
토큰
토큰 Token
- 토큰(token): 언어 모형이 입력과 출력을 처리하는 단위
- 토큰화(tokenization): 텍스트를 토큰의 나열로 바꾸는 과정
- 각 토큰은 어휘 집합(vocabulary)에 등록된 정수 ID로 변환
- 토큰의 경계는 단어, 글자, 형태소의 경계와 일치하지 않을 수 있음
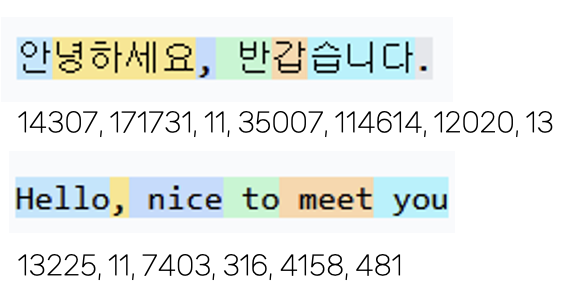
준단어 토큰화 Subword Tokenization
단어 전체를 토큰으로 사용하면 어휘 집합이 매우 커지고, 처음 보는 단어를 처리하기 어려움. 반대로 글자 하나씩 토큰으로 사용하면 어휘 집합은 작지만 토큰 수가 늘어남. 준단어(subword) 토큰화는 두 방식의 절충안.
| 토큰화 기준 | 장점 | 한계 |
|---|---|---|
| 글자 | 작은 어휘 집합으로 다양한 단어 표현 | 긴 토큰 나열 |
| 단어 | 짧은 토큰 나열 | 큰 어휘 집합과 새로운 단어 처리 문제 |
| 준단어 | 자주 등장하는 문자열은 묶고 드문 단어는 더 작게 분할 | 사람이 보는 단어·형태소 경계와 다를 수 있음 |
tiktoken은 바이트 쌍 인코딩(Byte Pair Encoding, BPE)에 기반한 토크나이저. 자주 함께 나타나는 바이트 조각은 하나의 토큰으로 묶고, 드문 문자열은 여러 조각으로 나눔. 따라서 공백이나 문장 부호가 주변 문자열과 함께 하나의 토큰이 될 수도 있음.
실습 준비
!pip install tiktoken
import tiktoken
텍스트를 토큰 ID로 변환
encoding = tiktoken.get_encoding("o200k_base")
text = "안녕하세요. 토큰화를 연습합니다."

token_ids = encoding.encode(text)
token_ids
실행 결과
[14307, 171731, 13, 68258, 118101, 92273, 24038, 8662, 24490, 13]
텍스트가 정수 ID의 나열로 변환됨. 각 ID가 o200k_base 어휘 집합의 토큰 하나를 가리킴.
토큰 조각 확인
각 ID에 대응하는 바이트를 UTF-8 문자열로 바꾸어 토큰 경계를 확인.
for token_id in token_ids:
    token = encoding.decode_single_token_bytes(token_id)
    print(token.decode("utf-8", errors="replace"))
실행 결과
안
녕하세요
.
 토
큰
화를
 연
습
합니다
.
' 토'와 ' 연'처럼 앞의 공백이 글자와 함께 묶일 수 있음. 안녕하세요는 '안'과 '녕하세요'로, 연습은 ' 연'과 '습'으로 나뉨.
encoding.decode(token_ids)
실행 결과
'안녕하세요. 토큰화를 연습합니다.'
한국어 글자 수와 토큰 수 비교
len(text) # 문자 수
실행 결과
18
len(token_ids) # 토큰 수
실행 결과
10
문자 수와 토큰 수가 일치하지 않음. LLM이 글자 수 세기 같은 작업을 어려워할 수 있는 이유 중 하나.
영어 문장 토큰화
같은 내용을 영어로 표현한 문장을 토큰화.
english_text = "Hello. We practice tokenization."

english_token_ids = encoding.encode(english_text)
english_token_ids
실행 결과
[13225, 13, 1416, 8248, 6602, 2860, 13]
for token_id in english_token_ids:
    token = encoding.decode_single_token_bytes(token_id)
    print(token.decode("utf-8", errors="replace"))
실행 결과
Hello
.
 We
 practice
 token
ization
.
len(english_text) # 영어 문자 수
실행 결과
32
len(english_token_ids) # 영어 토큰 수
실행 결과
7
영어 문장은 32자이지만 7개 토큰, 같은 내용의 한국어 문장은 18자이지만 10개 토큰. 이 예시에서는 영어의 자주 쓰이는 문자열이 더 큰 토큰으로 묶여 영어가 더 적은 토큰으로 표현됨.
인코딩별 토큰 수 비교
for encoding_name in ["o200k_base", "cl100k_base"]:
    current_encoding = tiktoken.get_encoding(encoding_name)
    print(encoding_name, len(current_encoding.encode(text)))
실행 결과
o200k_base 10
cl100k_base 17
같은 문장도 인코딩에 따라 토큰 수가 달라짐.
퀴즈
토큰에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.