집단지성
집단지성
오차 상쇄의 원리
- 군중의 지혜(wisdom of crowd): 개인의 답은 부정확해도, 이를 모은 결과는 평균적인 개인보다 정확할 수 있음
- 오차 상쇄(error cancellation)의 원리
- 기억과 추정 기준의 차이로 과대·과소 추정 발생
- 평균을 통해 과대·과소 추정 상쇄
- 정답을 아는 한 사람을 찾지 않아도 흩어진 지식으로 더 정확한 추정 가능
사례 — 상식 추정치를 단순 평균하기: Navajas et al. (2018)
사진: Phivospharconides, Wikimedia Commons, CC0 1.0

- 아르헨티나 대중 행사 참가자 5,180명
- 에펠탑 높이 등 정답이 있는 수량 질문 여덟 개
- 질문마다 20초 동안 토론 없이 개별 응답
- 여러 사람의 개별 응답 평균을 구함
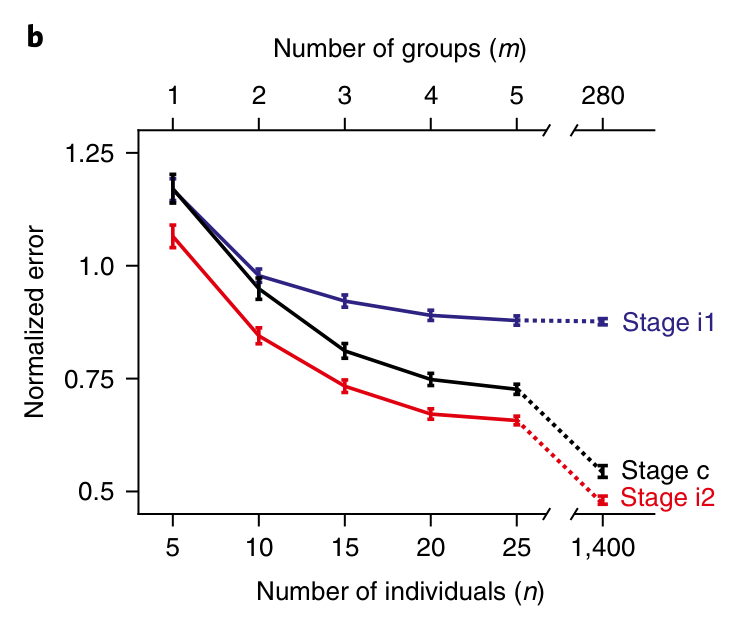
- 그래프 읽기
- 파란 선(Stage i1): 토론 전 독립 응답의 평균
- 가로축: 평균에 포함한 사람 수
- 세로축: 정규화한 오차, 낮을수록 정확
- 평균에 포함한 사람이 늘수록 집단 오차 감소
- 5,180명의 초기 응답 평균: 개인 추정 대비 오차 52% 감소
- 전문성 선별이나 설득 없이 독립 응답을 같은 비중으로 평균
집단 지성
- 단순 평균: 개인의 답을 그대로 결합
- 사람마다 아는 것이 다르다는 사실을 어떻게 활용할까?
- 잘 아는 사람의 정보에 더 큰 비중 부여
- 상호 설명으로 잘못된 판단 수정
- 모르는 문제는 다른 사람에게 위임
- 집단 성과는 응답 수뿐 아니라 정보별 영향력에도 달려 있음
- 집단지성(collective intelligence): 개인들의 협력·경쟁·집합행동을 통해 집단 수준에 나타나는 지능
- 모두가 같은 목표로 협력할 필요는 없음
- 각자 결정하며 타인에게 배우는 과정에서도 집단 수준의 성과 가능
의사결정 상황
| 의사결정 상황 | 결정의 단위 | 강의용 예시 | 중심 문제 |
|---|---|---|---|
| 합의 의사결정(consensus decision-making) | 집단이 하나의 결론 도출 | 채용위원회의 한 명 선발 | 서로 다른 정보와 전문성을 어떻게 통합할까? |
| 결합 의사결정(combined decision-making) | 타인의 영향을 받으며 각자 결정 | 타인의 선택을 참고한 개별 상품 구매 | 누가 새 정보를 얻고, 누가 누구에게서 배울까? |
합의 의사결정
합의의 규칙
- 합의 의사결정: 서로 다른 의견을 하나의 집단 판단으로 통합
- 범주형 선택: 다수결 또는 최다득표
- 수치 판단: 중앙값 또는 가까운 의견에 무게를 둔 평균
- 공식 투표 규칙이 없어도 토론에서 유사한 방식의 결론 도출 가능
- 사회적 공유성(social sharedness): 구성원이 이미 공유하는 지식이나 선호가 집단 결론이 되기 쉬움
- 정오를 분명히 입증하기 어려울수록 다수가 지지하는 의견이 합의 기준으로 작용
- 합의 규칙의 이점과 조건
- 복잡한 계산 없이 결론 도출
- 만장일치를 기다리다 결정을 못 하는 상황 감소
- 충분한 정확도와 적절한 결정 속도의 동시 확보 필요
- 정보의 질이 크게 다르면 동일 비중보다 전문성 반영이 유리할 수 있음
전문성 통합
- 전문성 통합: 정확한 판단자의 입력에 더 큰 영향력 부여
- 평가 단서: 과거 성과, 주관적 확신(subjective confidence), 개인 내 판단 일관성
- 단서의 유용성은 과제와 성과 자료에 달려 있음
- 과거 성적에 지나치게 맞춘 가중치의 위험
- 우연한 차이까지 학습해 새 문제의 정확도 저하 가능
- 자료가 부족할 때의 대안: 정확한 소수를 선발한 뒤 단순 평균
- 전문가 선별과 전문가 간 오차 상쇄의 결합
사례 — 최고 한 명보다 잘하는 몇 명의 평균: Mannes, Soll, & Larrick (2014)
- 문제: 최고 한 명과 전체 평균 중 무엇을 택할까?
- 한 명에게 의존: 해당 개인의 오류에 취약
- 전원 평균: 정확한 소수의 정보 희석 가능
- 어느 쪽도 항상 최선은 아님
- 연구 방식
- 모의실험과 기존 자료 90세트 재분석
- 실험적 추정 40세트, 경제 전망 50세트
- 선별 군중(select crowd): 과거 성과로 순위를 매긴 상위 소수의 응답 평균
- 경제 전망의 단순 평균: 전문 예측자 50세트의 전체 전망을 같은 비중으로 집계
- 모의실험과 기존 자료 90세트 재분석
- 결과: 과거 다섯 번의 성적으로 고른 상위 다섯 명의 평균
- 실험 자료: 평균적인 개인 대비 오차 39.7% 감소
- 전체 평균: 32.4% 감소
- 경제 전망: 평균적인 개인 대비 오차 14.4% 감소
- 전체 평균: 12.1% 감소
- 실험 자료: 평균적인 개인 대비 오차 39.7% 감소
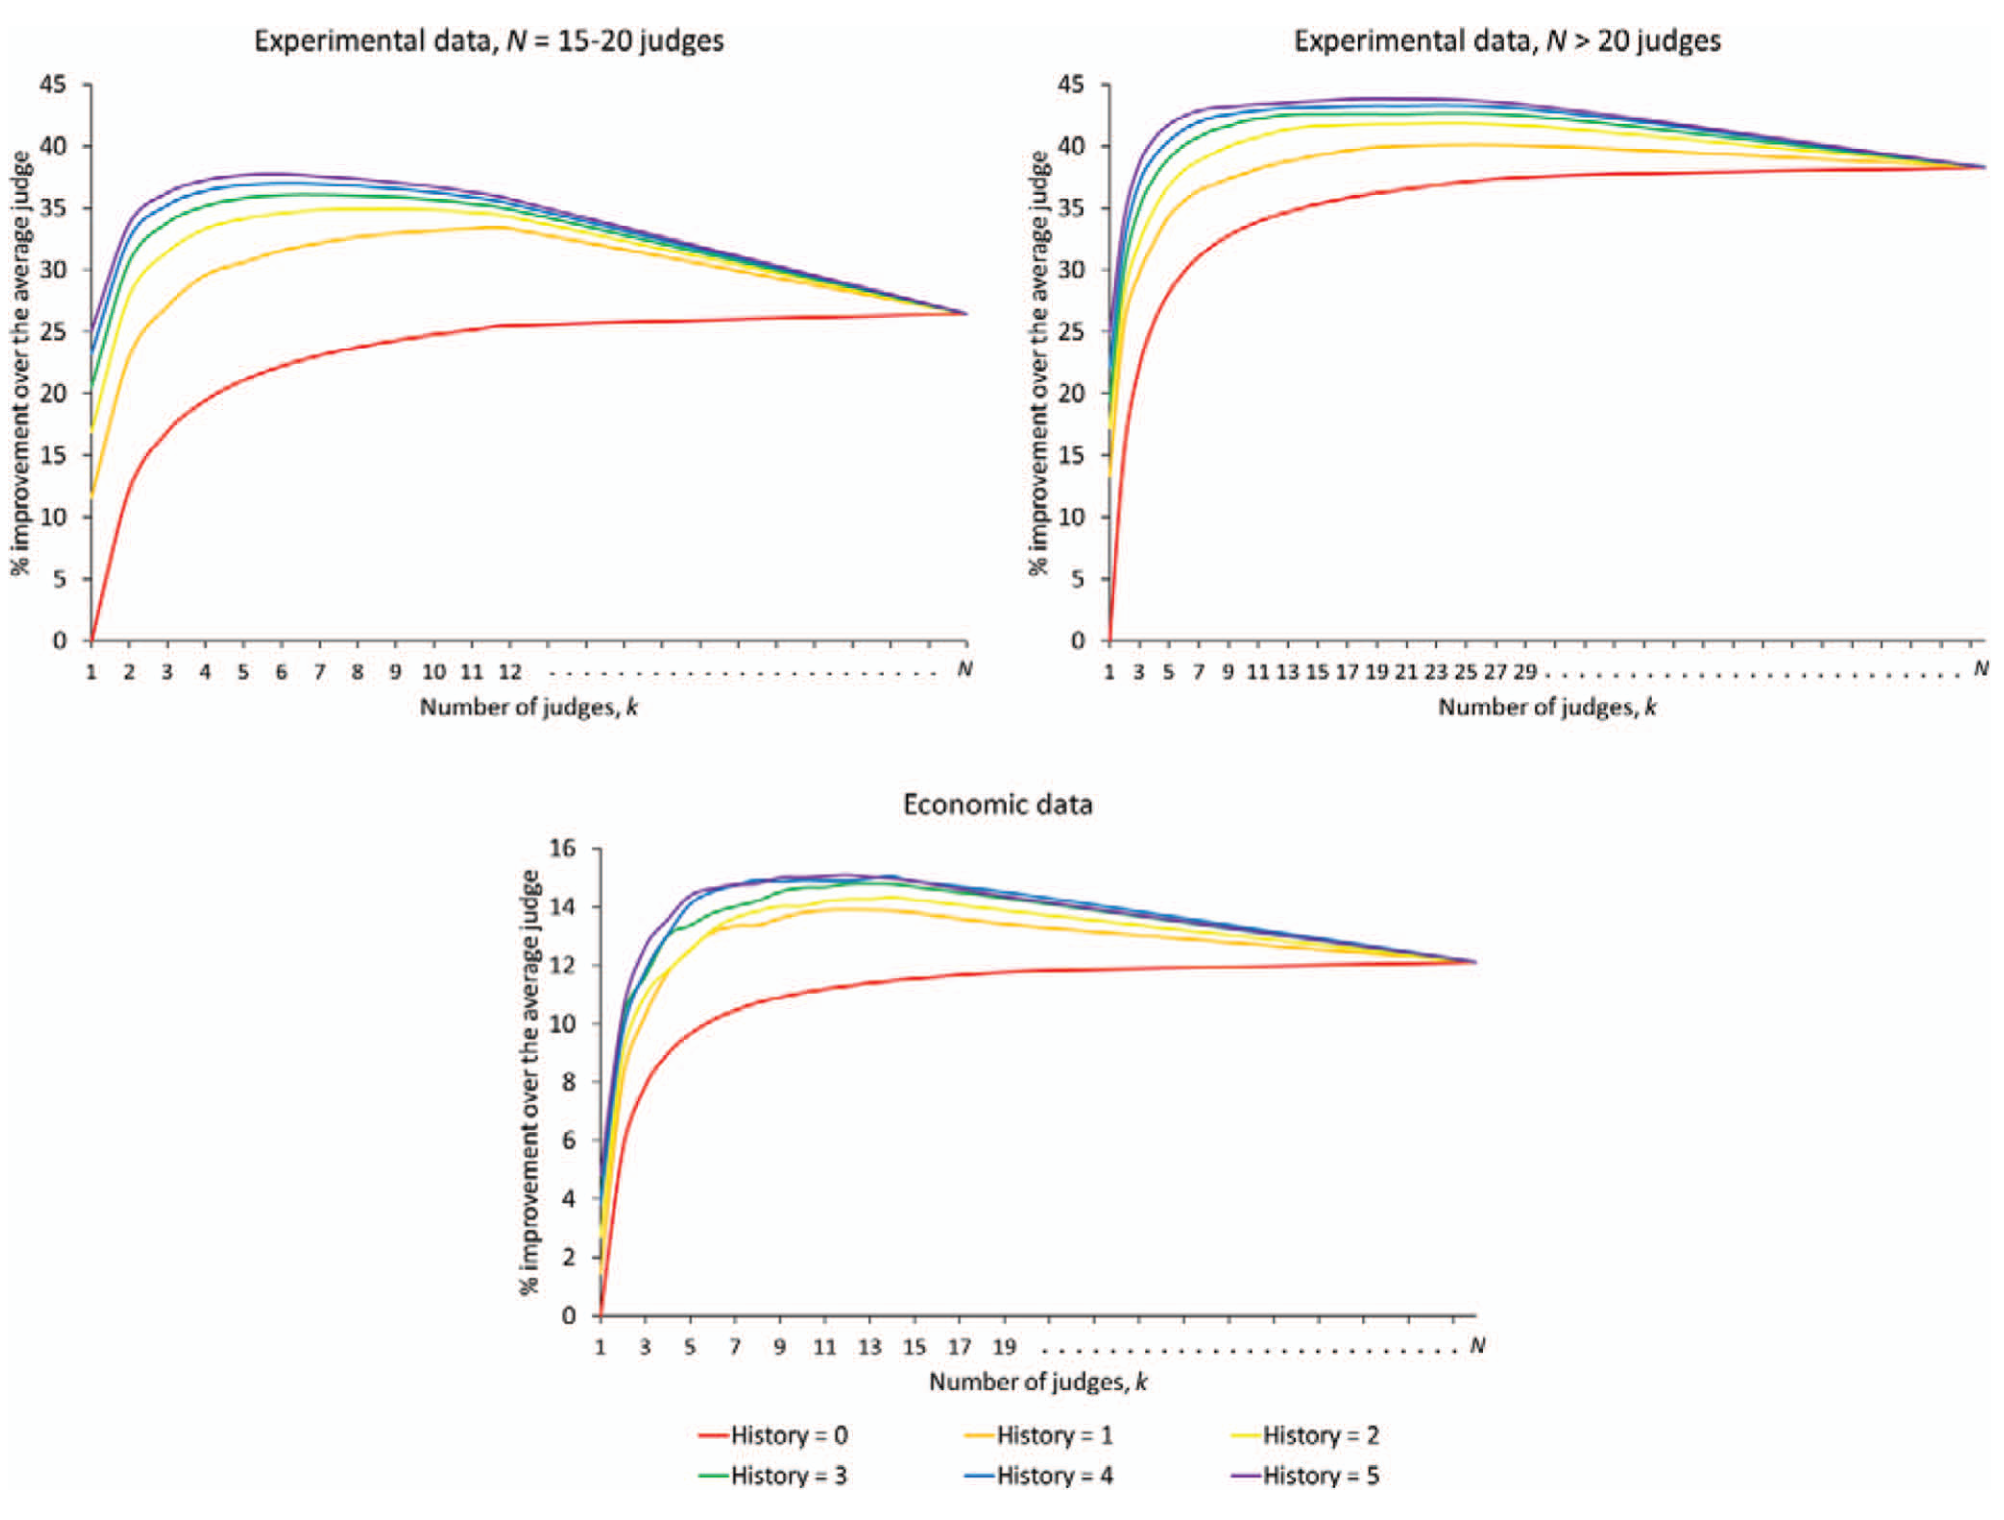
- 그래프 읽기
- 패널: 위 두 개는 집단 크기별 실험 자료, 아래는 경제 전망 자료
- 세로축: 평균적인 개인 대비 오차 감소율, 높을수록 정확
- 가로축: 평균에 포함한 판단자 수
- k = 1: 과거 성과로 고른 최고 한 명
- 중간: 상위 소수의 평균
- N: 전체 군중의 평균
- 색깔별 선: 선별에 사용한 과거 성과의 횟수
- 빨간 선(History = 0): 성과 이력 없이 무작위 선별한 평균
- 과거 성과를 활용한 선: 소수 평균에서 빠르게 상승한 뒤 전원 포함 시 하락
- 전문성 선별과 오차 상쇄의 결합 효과
- 경제 전망 패널의 N 지점: 여러 선이 약 12%에서 만남
- 전체 전망을 단순 평균한 효과
결합 의사결정
탐색과 활용, 그리고 정보에 편승하기
- 결합 의사결정: 하나의 답에 합의하는 대신 각자가 자기 선택을 하지만, 다른 사람이 무엇을 했고 어떤 결과를 얻었는지 참고
- 예: 새 식당을 고르거나 새로운 업무 방식을 시도하는 상황
- 개인의 과제: 탐색(exploration) 과 활용(exploitation) 의 균형
- 탐색: 새 정보 획득에 시간과 실패 비용 발생
- 활용: 이미 알고 있는 좋은 선택 사용
- 사회적 학습: 타인의 경험을 참고해 탐색 비용 절감
- 집단의 문제: 정보 편승(information scrounging)
- 모두 타인이 발견한 정보만 사용하면 새 정보를 얻는 사람 부족
- 개인에게 이로운 전략이 집단에는 이롭지 않을 수도
사회적 학습 전략
- 사회적 학습 전략: 언제, 누구를, 무엇을 참고할지에 따라 정보의 비중 조절
- 언제: 자신이 불확실할 때 타인 참고
- 정보가 부족하면 자기 추정보다 타인의 정보 활용
- 누구: 성과가 좋은 사람이나 다수가 선택한 행동 참고
- 특정 사람이나 행동의 영향력 증가
- 무엇: 이해하기 쉽거나 직관적인 내용 수용
- 정보의 내용에 따라 확산 정도 변화
- 언제: 자신이 불확실할 때 타인 참고
- 불확실할 때 복사하기(copy-when-uncertain): 개인의 지식 차이를 활용하는 전략
- 유용한 정보를 가진 사람은 자기 경험 활용
- 정보가 부족한 사람은 그 사람에게 학습 → 정확한 정보의 비중 증가
- 합의 상황에서 잘 아는 사람은 기여하고 덜 아는 사람은 판단을 유보하는 것과 유사
- 로저스의 역설(Rogers’s paradox): 무작위 복사의 한계
- 타인을 따르면 개인의 탐색 비용 절감
- 복사자가 늘면 오래된 정보를 재복사할 가능성 증가
- 해법: 언제 누구에게 배울지 선택하는 전략으로 문제 완화
- 동조적 사회학습(conformist social learning): 다수를 따르는 전략
- 다수가 유용한 정보를 보유하면 도움
- 환경 변화로 기존 선택의 가치가 떨어지면 옛 행동 확산
- 동기: 다수의 정보가 정확하리라는 기대와 집단에 맞추려는 욕구
사례 — 인기와 선택이 서로 강화되는 문화시장: Salganik, Dodds, & Watts (2006)
-
실험: 14,341명이 잘 알려지지 않은 48곡을 듣고 다운로드 여부 선택
- 독립 조건: 이전 참가자의 다운로드 수 비공개
- 사회적 영향 조건: 다운로드 수 공개, 서로 정보가 섞이지 않는 8개 평행 시장으로 분리
- 같은 곡과 출발 조건에서도 시장마다 다른 성공 경로가 생기는지 비교
- 실험 1: 곡을 격자의 무작위 위치에 배치하고, 사회적 영향 조건에서 다운로드 수 표시
- 실험 2: 사회적 영향 조건에서 곡을 다운로드 수와 함께 인기순 목록으로 제시해 인기 신호 강화
- 독립 조건은 다운로드 수 없이 무작위 순서로 제시
-
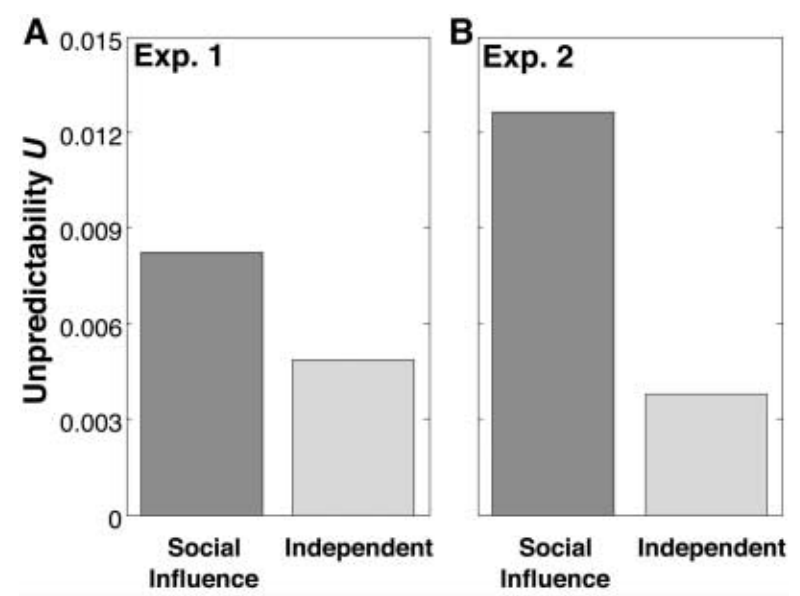
결과: 인기 정보 공개 시 성공의 쏠림과 예측 불가능성 모두 증가
- 한 시장 안에서는 일부 곡에 다운로드 집중
- 시장 사이에서는 같은 곡의 점유율·순위가 크게 달라짐
- 독립 조건에서 인기 있던 곡이 평균적으로 더 성공했지만, 품질만으로 최종 성과를 설명하기 어려움
- 여기서 품질은 독립 조건의 다운로드 성과로 측정한 선호 지표
-
그림 2: 같은 곡의 시장 간 점유율 차이를 평균한 예측 불가능성(U)
- 두 실험 모두 사회적 영향 조건(진한 막대)이 독립 조건(옅은 막대)보다 높음
독립성과 상호의존성
- 사회적 영향의 두 단계 구분
- 탐색·선택: 어디에서 정보를 찾고 무엇을 선택할지
- 평가·학습: 경험한 대상의 가치를 판단하고 믿음을 갱신하는 과정
- 꿀벌의 새 둥지 선택 모형: 탐색의 상호의존성과 평가의 독립성 결합
- 다른 벌의 춤에 영향을 받아 방문할 후보지 선택 → 탐색의 상호의존성
- 방문한 후보지의 품질은 직접 확인해 평가 → 평가의 독립성
- 이 조합으로 집단의 정확성과 행동의 유연성을 함께 재현
- 평가까지 상호의존적으로 바꾼 모형에서는 부적응적 군집행동 위험 증가
- 실제 품질과 무관하게 다른 벌이 추천한 장소를 더 좋다고 평가 → 좋지 않은 선택에 집단이 쏠릴 가능성
- 인간의 평가 과정에도 작용하는 사회적 영향
- 인기 있지만 최선은 아닌 대안을 가장 좋은 선택으로 오인할 가능성
- 선택뿐 아니라 평가의 근거도 서로 의존하면 잘못된 선택을 수정하기 어려워질 위험
- 평가의 독립성이 유지되는 경우 집단 성과와 행동의 유연성을 함께 유지할 수 있다는 연구 결과
- 다만 평가까지 상호의존적인 경우 인간 집단의 유연성이 실제로 얼마나 낮아지는지는 아직 불명확
정보의 분포와 흐름
집단이 가진 정보는 어떻게 분포하고 있는가?
- 정보가 편향 없이 분포할 때 평균·다수결의 정확성 향상 가능
- 다양한 판단이 정답의 양쪽에 분포하면 평균을 통해 오차 상쇄
- 다수결에서도 충분한 구성원이 올바른 선택을 뒷받침하는 정보·경험을 가질 때 유리
- 전문성이나 훈련으로 개별 판단의 오차를 줄이면 집단 판단의 정확성도 높아질 수 있음
- 공유정보(여러 사람이 이미 아는 정보) vs. 고유정보(특정 구성원만 아는 정보)
- 토론에서는 공유 정보가 반복되고 고유 정보는 덜 언급되거나 중요성이 과소평가되기 쉬움
- 공유 정보가 최선의 대안을 뒷받침하면 반복 공유가 반드시 해로운 것은 아님
- 공유 정보가 편향된 정보라면 반복을 통해 집단이 잘못된 결론으로 향할 수 있음
동종선호와 확인편향
- 동종선호(homophily): 비슷한 사람과 관계를 맺는 경향
- 비슷한 경험·생각을 가진 사람끼리 연결 → 정보와 태도가 비슷한 무리 형성
- 사회 전체에 다양한 정보가 있어도 각 무리가 접하는 정보는 편중될 수 있음
- 확인편향(confirmation bias): 기존 믿음을 지지하는 정보를 더 찾고 주목하는 경향
- 믿음을 뒷받침하는 정보는 타인에게도 더 잘 공유
- 동종선호와 결합 → 편향된 정보가 집단 안에서 반복·강화
- 디지털 환경에서의 증폭
- 기존 믿음에 맞는 정보 검색 → 알고리즘의 유사 정보 추천 → 비슷한 정보에 반복 노출
- 에코 챔버(echo chamber)·필터 버블(filter bubble)·정보 연쇄(information cascade) 형성 가능
- 정보 흐름을 자유롭게 열어 두는 것만으로 편향이 사라지지는 않음
- 특정 결론을 원하는 구성원의 전략적 정보 전달
- 선호하는 대안의 부정적 정보 은폐, 긍정적 정보 과장, 거짓 정보 제공
- 알고리즘을 활용해 그 정보를 믿기 쉬운 사람들에게 확산할 가능성
열린 사고와 지적 겸손
- 다양한 정보를 판단에 반영하는 태도
- 지적 겸손: 자신의 지식과 믿음이 틀릴 가능성 인정
- 열린 사고: 다른 관점과 새 증거를 검토하고 믿음 수정
- 열린 사고는 개인의 태도와 함께 집단이 지지하는 규범으로도 중요
- 반대 관점 검토와 믿음 수정을 허용해야 다양한 정보가 실제 판단에 반영될 수 있음
- 구조화된 비판적 사고: 확률 판단과 성과 추적
- 믿음을 세밀한 확률로 표현하고, 실제 결과와 비교해 정확도 추적
- “맞다/틀리다”로 입장을 고정하기보다 새 증거에 따라 가능성을 갱신
- Mellers et al. (2019)의 예측 토너먼트 연구
- 확률적 사고와 성과 추적을 통한 유연한 믿음 수정, 정치적 태도의 극단성 완화 보고
- 예측의 정확성과 태도의 양극화는 구별되는 결과
- 전문성이 높다는 자기인식이 언제나 열린 사고로 이어지는 것은 아님
- 획득된 독단주의 효과(the earned dogmatism effect): 자신이 더 전문적이라고 느끼면 타인의 아이디어를 덜 열린 태도로 검토할 수 있음
- 실제 전문지식의 수준과 자신의 전문성에 대한 인식을 구분할 필요
사례 — 생각을 수정하는 개방성과 추정 정확성: Gürçay, Mellers, & Baron (2015)
-
실험: 대학생들이 건물 높이·인구 비율 등 16개 수량을 두 차례 추정
- 독립 조건: 두 번 모두 혼자 추정, 개인 정확성에 따라 보상
- 토론 조건: 최초 독립 추정 → 8–10명이 문항별 90초 온라인 토론 → 각자 최종 추정 제출
- 최초 추정치·확신과 판단 근거 공유, 외부 검색 금지
- 개인 정확성에 보상하는 조건과 집단 중앙값의 정확성에 보상하는 조건 비교
-
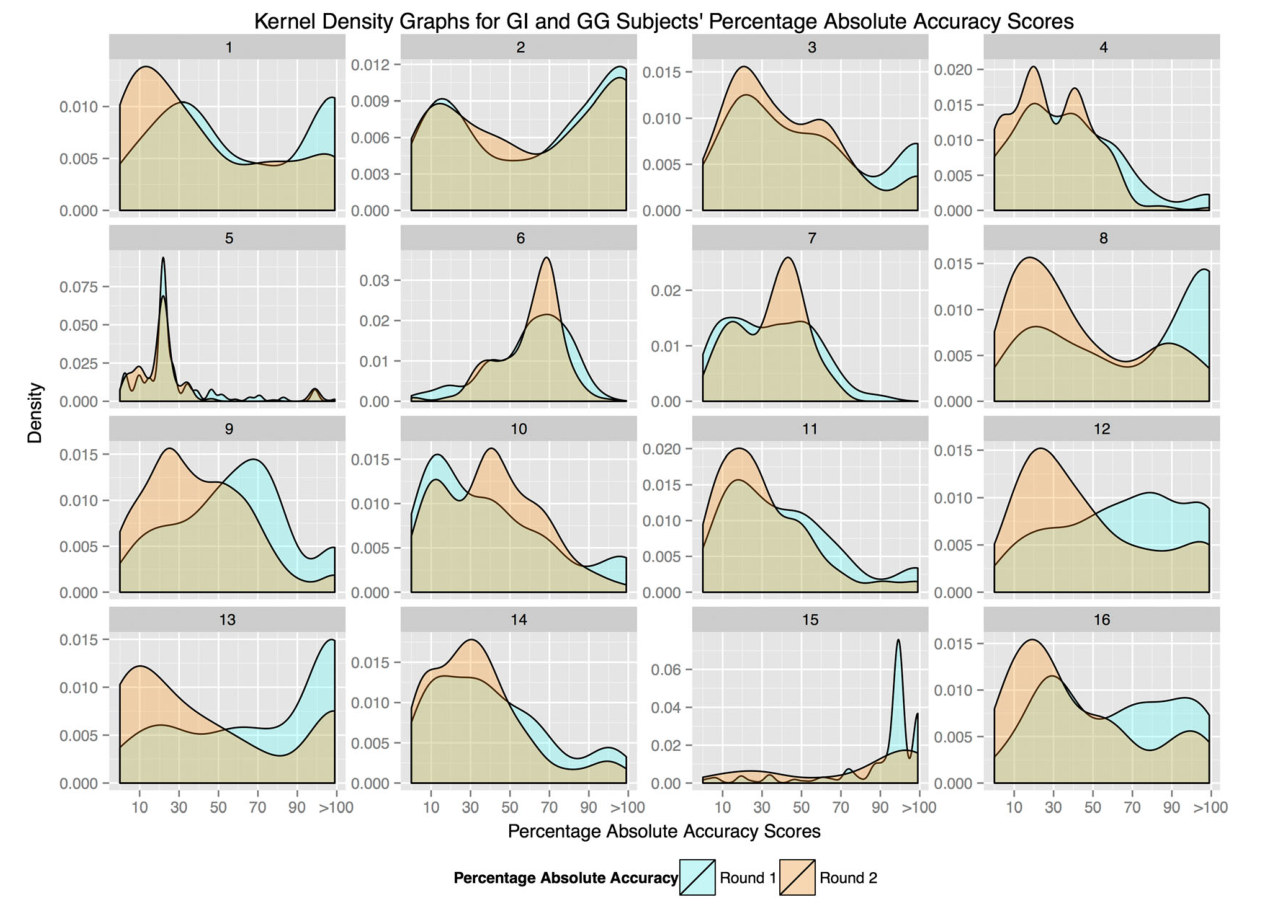
결과: 토론 후 추정치가 서로 가까워지면서 정확성도 향상
- 두 토론 조건 모두 16문항 중 12문항에서 최초 추정보다 절대오차가 유의하게 감소
- 독립 조건은 어느 문항에서도 유의한 향상이 없었음
- 토론 조건은 각각 11문항에서 독립 조건의 최종 추정보다 정확
- 집단 보상이 개인 보상보다 일관되게 유리하지는 않았음
-
그림 2: 두 토론 조건을 합친 문항별 추정오차 분포
- 파란색은 토론 전, 주황색은 토론 후, 녹색은 겹치는 영역; 가로축은 오차(%), 세로축은 확률밀도
- 여러 문항에서 토론 후 분포가 오차가 작은 왼쪽으로 이동 → 추정 정확성 향상
-
수정 과정: 최초 추정이 가장 부정확했던 사람은 모든 문항에서 다른 구성원보다 크게 수정
- 최초 추정이 가장 정확했던 사람은 12문항에서 다른 구성원보다 적게 수정
- 지식 차이에 따라 수정 정도가 달라지는 양상과 부합
-
열린 사고와의 연결: 채팅 발언 분석에서 추정 수정 발언이 집단 최종 추정의 낮은 오차와 관련
- 타인의 정보를 받아들여 자신의 판단을 수정하는 개방성의 중요성을 시사
여러 집단 사이에서는 무엇이 달라지는가?
- 사회의 여러 집단은 서로 다른 이해관계·정체성을 보유
- 하나의 집단 내부에도 정보와 태도가 다른 하위 집단 형성 가능
- 집단 간 대립이 두드러지면 내집단(ingroup) 을 높이고 외집단(outgroup) 을 낮추는 정보가 주로 공유
- 집단 정체성과 극단적 입장의 강화
- 상대 집단과 뚜렷이 구별되는 극단적 입장이 우리 집단의 대표 입장으로 인식될 가능성
- 그 입장과 지지 정보를 강하게 내세우는 사람이 지도자로 부상
- 소셜미디어 알고리즘이 정보 버블을 반영·증폭하며, 타당성과 무관하게 극단적 정보가 확산될 수 있음
- 공유된 믿음이 사실의 기준을 대신하는 위험
- 거짓 정보도 집단 정체성과 결부된 익숙한 이야기에 맞으면 그럴듯하게 수용
- 거짓이 집단의 ‘진실’로 굳어지는 동시에, 타당한 정보의 수용까지 방해할 수 있음
- 집단 내부의 넓은 동의가 사회 전체의 정확한 판단을 보장하지 않는 이유
- 외부 정보를 받아들이는 태도도 집단 관계에 좌우
- 내집단의 의견에는 더 개방적이고, 외집단의 의견에는 주의를 덜 기울이는 경향
- 열린 사고를 지지하는 내집단 규범은 이런 경향을 완화할 수 있음
- 집단 간 경쟁이 집단 내부의 정보처리를 개선하는 경우도 있으나, 친사회적·비경쟁적 동기도 개선에 기여
- 경쟁 자체가 항상 해롭거나 유익하다고 단정하기 어려움
- 외부 조언의 효과: 합의 상태와 조언 시점이 중요
- 집단은 대체로 개인보다 외부 조언을 덜 수용
- 그러나 내부 의견이 갈리고 아직 합의하지 않은 집단은 개인보다 외부 조언을 더 잘 활용할 수 있음
- 정보 자체의 타당성과 함께 집단이 어떤 단계·규범 아래에서 그 정보를 받는지 검토 필요
퀴즈
여러 사람의 추정치를 평균하면 오차가 줄어들 수 있는 이유는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.