Prophetverse
Prophetverse
- Prophet 모형의 원리를 확장한 시계열 예측 라이브러리
sktime과 호환되는fit()·predict()인터페이스- 기본 모형에 계절성을 추가하여 예측 결과 비교
pip install prophetverse
Prophet 모형의 특징
- Prophet: 메타(당시 Facebook)가 2017년에 공개한 시계열 예측 모형
- 시계열을 몇 가지 구성 요소의 합으로 보고 각각을 따로 추정
- 추세(trend)
- 장기적인 증가·감소를 여러 직선 조각을 이어 붙인 형태로 표현
- 기울기가 바뀌는 지점(변화점, changepoint)을 데이터에서 자동으로 찾음
- 예: 생산량이 늘다가 어느 시점부터 줄어드는 변화도 반영
- 계절성(seasonality)
- 연간·주간·일간처럼 일정한 간격으로 반복되는 패턴
- 사인·코사인 곡선을 겹쳐 부드러운 반복 모양을 만듦
- 휴일 효과(holiday)
- 명절, 공휴일, 행사처럼 특정 날짜에만 나타나는 효과를 따로 반영
- 장점
- 추세, 계절성 등 구성 요소별로 결과를 나누어 해석하기 쉬움
- 관측 간격이 불규칙하거나 일부 값이 빠져 있어도 사용 가능
- 통계 지식이 많지 않아도 기본 설정으로 쓸 만한 예측을 얻을 수 있음
- 한계
- 과거의 반복 패턴이 미래에도 이어진다고 가정
- 바로 직전 값의 영향(자기상관)은 직접 모형에 넣지 않으므로, 단기 변동이 큰 자료에서는 다른 모형보다 불리할 수 있음
- Prophetverse: Prophet의 구조를 그대로 따르면서
sktime방식으로 사용할 수 있게 다시 구현한 라이브러리
실습 프롬프트
🤖 AI 프롬프트
Prophetverse를 이용해 beer.xlsx의 맥주 생산량을 2015년 2분기까지 예측해줘.
기본 모형과 연간 계절성을 추가한 모형의 예측을 그래프로 비교하고, 반복 패턴의 차이를 설명해줘.
실습 준비
import pandas as pd
# 분기 시작일(quarter)을 날짜 인덱스로 읽기
beer = pd.read_excel('beer.xlsx', parse_dates=True,
                     index_col='quarter')

# 예측할 대상: 분기별 맥주 생산량
y = beer.production

# 마지막 관측 다음 달력 분기의 시작일
start_date = (beer.index[-1]
              + pd.offsets.QuarterBegin(startingMonth=1))

# 그 날부터 분기 시작일(QS) 간격으로 20개 분기, 즉 5년
future_dates = pd.date_range(start=start_date, periods=20,
                             freq='QS')
기본 모형으로 예측
- 기본 모형은 기울기가 구간별로 달라질 수 있는 추세만 추정
- 연간·주간 계절성은 자동으로 포함되지 않음
- 아래 계절성 추가 실습에서는 이 추세에 반복되는 계절 효과를 더함
from prophetverse.sktime import Prophetverse

# 아무 설정 없이 만든 기본 모형: 꺾은선 형태의 추세만 사용
pp = Prophetverse()

# 과거 생산량으로 모형 적합
pp.fit(y=y)
실행 결과
Prophetverse()
# fh(forecasting horizon): 예측할 미래 날짜
y_pp = pp.predict(fh=future_dates)

# 예측 날짜를 인덱스로 하는 데이터프레임으로 정리
pred_pp = pd.DataFrame({'production': y_pp},
                       index=future_dates)
pred_pp.head()
실행 결과
            production
2010-07-01  414.790253
2010-10-01  414.199615
2011-01-01  413.608917
2011-04-01  413.031158
2011-07-01  412.446716
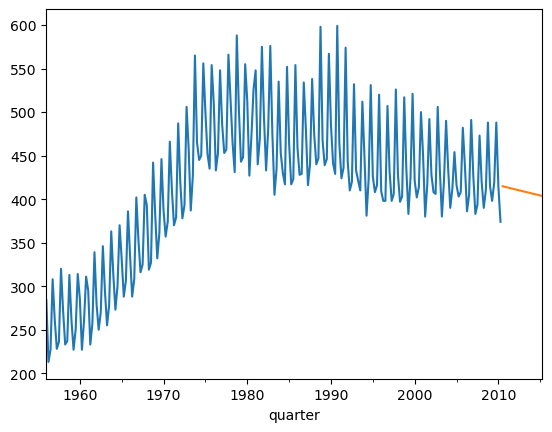
# 과거 생산량과 예측값을 한 그래프에
# 계절성이 없으므로 예측은 완만하게 감소하는 직선
beer.production.plot()
pred_pp.production.plot()
추세와 변화점
- 기본 모형의 추세는 여러 직선 조각을 이어 붙인 형태
- 후보 변화점: 학습 기간의 앞 80% 안에서 25개 관측값(약 6년)마다 하나씩 배치
- 각 변화점에서 기울기가 얼마나 바뀌는지 추정. 대부분은 0에 가깝게 추정되고, 실제로 꺾이는 곳만 크게 추정
import numpy as np

# 과거부터 예측 마지막 분기까지 전체 날짜
all_dates = pd.date_range(y.index[0], future_dates[-1], freq='QS')

# predict_components(): 예측값을 추세 등 구성 요소별로 나누어 반환
# 그중 추세 성분만 선택
trend = pp.predict_components(fh=all_dates)['trend']

# 변화점별 기울기 변화의 추정값(표본 1000개 × 변화점 7개)
samples = pp.posterior_samples_['trend/changepoint_coefficients']

# 후보 변화점 간격(관측값 수). 이 모형에서는 25
interval = pp.trend_model_.changepoint_interval

changepoints = pd.DataFrame({
    # 첫 관측부터 interval마다 하나씩, 변화점 개수만큼
    'date': y.index[::interval][:samples.shape[1]],
    # 표본의 평균. 양수면 그 시점부터 기울기가 커지고 음수면 작아짐
    # 값은 모형 내부에서 크기를 조정한 단위
    'slope_change': np.asarray(samples).mean(axis=0),
})
changepoints
실행 결과
        date  slope_change
0 1956-01-01      0.001916
1 1962-04-01      0.003939
2 1968-07-01      0.000581
3 1974-10-01     -0.005169
4 1981-01-01     -0.002230
5 1987-04-01     -0.000323
6 1993-07-01      0.000307
# 원래 생산량(회색)과 추정한 추세(파란색)
ax = y.plot(color='gray', alpha=0.6, label='production')
trend.plot(ax=ax, color='C0', linewidth=2, label='trend')

# 변화점마다 세로 점선
# 기울기가 작아지면 빨간색(C3), 커지면 초록색(C2)
# 변화가 클수록 진하게(최대 1)
for date, change in zip(changepoints['date'],
                        changepoints['slope_change']):
    color = 'C3' if change < 0 else 'C2'
    alpha = min(1, abs(change) / 0.005)
    ax.axvline(date, color=color, linestyle='--', alpha=alpha)

ax.legend()
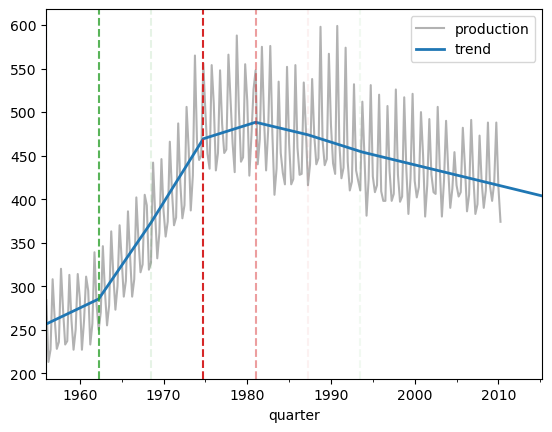
- 1962년경: 증가 속도가 빨라짐
- 1974년경: 가장 큰 변화. 빠른 증가가 멈추고 완만해짐
- 1981년경: 증가에서 감소로 전환
- 미래 구간은 마지막 추세의 기울기를 그대로 연장
계절성 추가
- 기본 모형의 추세에 해마다 반복되는 계절 효과를 더함
- 계절 곡선은 사인·코사인 곡선(푸리에 항)을 여러 개 겹쳐서 표현
- 항 개수가 많을수록 더 복잡한 모양의 계절 곡선을 표현할 수 있음
- 설정 예: 연간 10, 주간 3, 월간 3~10. 자료와 목적에 맞게 조절
# 사인·코사인 형태의 푸리에 항으로 계절성을 표현하는 효과
from prophetverse.effects.fourier import LinearFourierSeasonality
# 별도의 입력 컬럼 없이 날짜 인덱스만으로 효과를 만들 때 사용
from prophetverse.utils import no_input_columns

seasonality = LinearFourierSeasonality(
    # 주기의 기준 단위를 일(day)로 지정
    # 분기별 자료를 일별 자료로 바꾸는 설정은 아님
    freq='D',
    # 주기 365.25일: 평균적인 1년 길이 → 연간 계절성
    sp_list=[365.25],
    # 사인·코사인 10쌍, 총 20개 항으로 계절 곡선 표현
    fourier_terms_list=[10],
)

pps = Prophetverse(
    # (효과 이름, 효과, 사용할 입력 컬럼) 묶음의 목록
    exogenous_effects=[
        ('seasonality', seasonality, no_input_columns),
    ],
)
pps.fit(y=y)
실행 결과
Prophetverse(exogenous_effects=[('seasonality',
                                 LinearFourierSeasonality(fourier_terms_list=[10],
                                                          freq='D',
                                                          sp_list=[365.25]),
                                 '^$')])
# 미래 20개 분기의 생산량 예측
y_pps = pps.predict(fh=future_dates)

# 예측 날짜를 인덱스로 하는 데이터프레임으로 정리
pred_pps = pd.DataFrame({'production': y_pps},
                        index=future_dates)
pred_pps.head()
실행 결과
            production
2010-07-01  388.728455
2010-10-01  486.886230
2011-01-01  418.340973
2011-04-01  372.630920
2011-07-01  386.312622
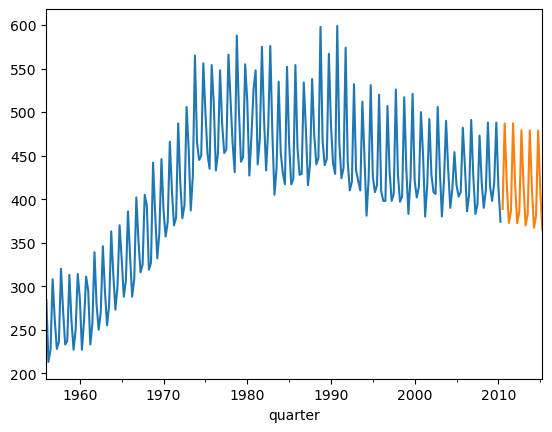
# 과거 생산량과 예측값을 한 그래프에
# 기본 모형과 달리 분기마다 오르내리는 반복 패턴이 나타남
beer.production.plot()
pred_pps.production.plot()
퀴즈
Prophetverse 기본 모형에 연간 계절성을 반영하려면 어떤 준비가 필요한가요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.