
의사결정 나무
여러 입력 변수에 질문을 던지고 잎의 평균으로 숫자를 예측하는 의사결정나무 회귀
질문으로 예측하기
- 의사결정나무(decision tree): 질문으로 사례를 둘로 나누는 과정을 반복하는 모델
- 질문 지점(node): 한 입력 변수의 값이 문턱값보다 작거나 같은지 확인하는 곳
- 가지(branch): 질문의 답에 따라 이동하는 경로
- 잎(leaf): 질문이 끝나고 최종 예측값을 내는 곳
스무고개와 비슷한 구조. 한 번에 하나의 입력 변수를 확인하고, 답에 따라 사례의 범위를 점차 축소.
예시: 주거 만족도
240명의 주거 조건으로 만족도를 예측하는 수업용 자료.
- 입력 X
commute: 통학 시간(분)rent: 월세(만원)noise: 소음 수준(1은 조용함, 5는 시끄러움)
- 타깃 y
score: 주거 만족도(0점에서 100점)
실습 준비
Colab에서 두 파일을 바로 내려받으려면 다음 셀 실행.
!wget -q -O housing.xlsx "https://i7xuddrpzatg79hh.public.blob.vercel-storage.com/content/shared/sha256/98/98281ede1416a15670d419ced730f15ab08d51ff370771636544a1261bb3c53f/housing.xlsx?download=1"
!wget -q -O cases.xlsx "https://i7xuddrpzatg79hh.public.blob.vercel-storage.com/content/shared/sha256/85/85f41d8db294086be3bd075f460463b844856bb1b72e8974f08c2088544c0cc0/cases.xlsx?download=1"
데이터 불러오기
Excel 파일이 Colab의 현재 폴더에 준비된 상태에서 실행.
import pandas as pd

df = pd.read_excel("housing.xlsx", sheet_name="data")
df.head()
실행 결과
   commute  rent  noise  score
0       10    51      2   90.8
1       56    87      5   48.2
2       48    47      2   66.8
3       33    92      4   53.0
4       33    90      3   70.7
- 사례: 한 사람이 한 행을 차지하는 구조
- 입력 변수: 통학 시간, 월세, 소음 수준의 세 열
- 타깃: 마지막 만족도 열
입력과 타깃 나누기
features = [
    "commute",
    "rent",
    "noise",
]
X = df[features]
y = df["score"]
X에 세 입력 변수를 함께 배치. y에는 예측할 만족도만 배치.
열 이름을 하나씩 적는 대신 drop()으로 타깃 열을 제외하는 방법도 가능.
y = df["score"]
X = df.drop(columns="score")
drop(columns="score"):score열을 제외한 나머지 열을 X로 선택- y: 제외한
score열을 타깃으로 선택
나무가 질문을 고르는 방법
나무가 검토하는 질문의 예:
- 통학 시간이 30분 이하인가?
- 월세가 80만 원 이하인가?
- 소음 수준이 3 이하인가?
각 질문으로 훈련 사례를 두 집단으로 분할(split). 분할 뒤 각 집단 안의 만족도 차이가 작아지는 질문을 우선 선택.
회귀나무의 잎에 도착한 뒤 사용하는 값은 그 잎에 모인 훈련 사례의 타깃 y 평균.
얕은 나무 학습
from sklearn.tree import DecisionTreeRegressor

model = DecisionTreeRegressor(
    max_depth=3,          # 질문을 최대 세 단계로 제한
    min_samples_leaf=12,  # 한 잎에 남길 최소 사례 수
    random_state=42,      # 같은 조건에서 같은 결과 재현
)
model.fit(X, y)
실행 결과
DecisionTreeRegressor(max_depth=3, min_samples_leaf=12, random_state=42)
max_depth=3: 뿌리에서 잎까지 질문을 최대 세 번 사용min_samples_leaf=12: 각 잎에 훈련 사례를 최소 12개 유지fit(X, y): 세 입력 변수와 만족도의 관계 학습
학습한 질문 확인
from sklearn.tree import export_text

tree_rules = export_text(model, feature_names=features)
print(tree_rules)
실행 결과
|--- commute <= 41.50
|   |--- noise <= 3.50
|   |   |--- rent <= 83.00
|   |   |   |--- value: [83.20]
|   |   |--- rent >  83.00
|   |   |   |--- value: [72.18]
|   |--- noise >  3.50
|   |   |--- rent <= 74.50
|   |   |   |--- value: [68.33]
|   |   |--- rent >  74.50
|   |   |   |--- value: [55.73]
|--- commute >  41.50
|   |--- noise <= 3.50
|   |   |--- rent <= 90.50
|   |   |   |--- value: [65.52]
|   |   |--- rent >  90.50
|   |   |   |--- value: [55.21]
|   |--- noise >  3.50
|   |   |--- rent <= 90.00
|   |   |   |--- value: [50.58]
|   |   |--- rent >  90.00
|   |   |   |--- value: [40.14]
- 첫 질문: 통학 시간이 41.5분 이하인지 확인
- 두 번째 질문: 각 가지에서 소음 수준이 3.5 이하인지 확인
- 세 번째 질문: 월세를 기준으로 다시 분할
- 최종 구조: 깊이 3, 잎 8개
첫 번째 잎으로 가는 경로:
통학 시간 ≤ 41.5분
→ 소음 수준 ≤ 3.5
→ 월세 ≤ 83만 원
→ 만족도 83.20점 예측
value: [83.20]은 이 잎에 모인 훈련 사례의 평균 만족도. 세 조건을 모두 만족하는 새 사례도 같은 값으로 예측.
새로운 사례 예측
cases = pd.read_excel("cases.xlsx", sheet_name="cases")
cases.head()
실행 결과
   commute  rent  noise
0       15    60      1
1       35    85      3
2       55   110      5
cases.xlsx에는 입력 변수만 존재. 아직 만족도나 예측값이 없는 상태.
cases["prediction"] = model.predict(cases)
cases
실행 결과
   commute  rent  noise  prediction
0       15    60      1   83.197674
1       35    85      3   72.177500
2       55   110      5   40.142105
prediction 열에 나무가 예측한 만족도 추가.
- 첫 사례: 통학 15분, 월세 60만 원, 소음 1 → 만족도 약 83.2점
- 둘째 사례: 통학 35분, 월세 85만 원, 소음 3 → 만족도 약 72.2점
- 셋째 사례: 통학 55분, 월세 110만 원, 소음 5 → 만족도 약 40.1점
각 예측값은 계산식으로 세 값을 더한 결과가 아니라, 질문에 답하며 도착한 잎의 평균.
나무 시각화
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree

plt.figure(figsize=(16, 8))  # 넓은 나무가 잘 보이도록 크기 지정
plot_tree(
    model,                    # 시각화할 학습된 나무
    feature_names=features,   # 질문에 표시할 입력 변수 이름
    filled=True,              # 예측값에 따라 노드 색상 표시
    rounded=True,             # 노드 상자의 모서리를 둥글게 표시
    precision=1,              # 숫자를 소수점 한 자리까지 표시
)
plt.show()
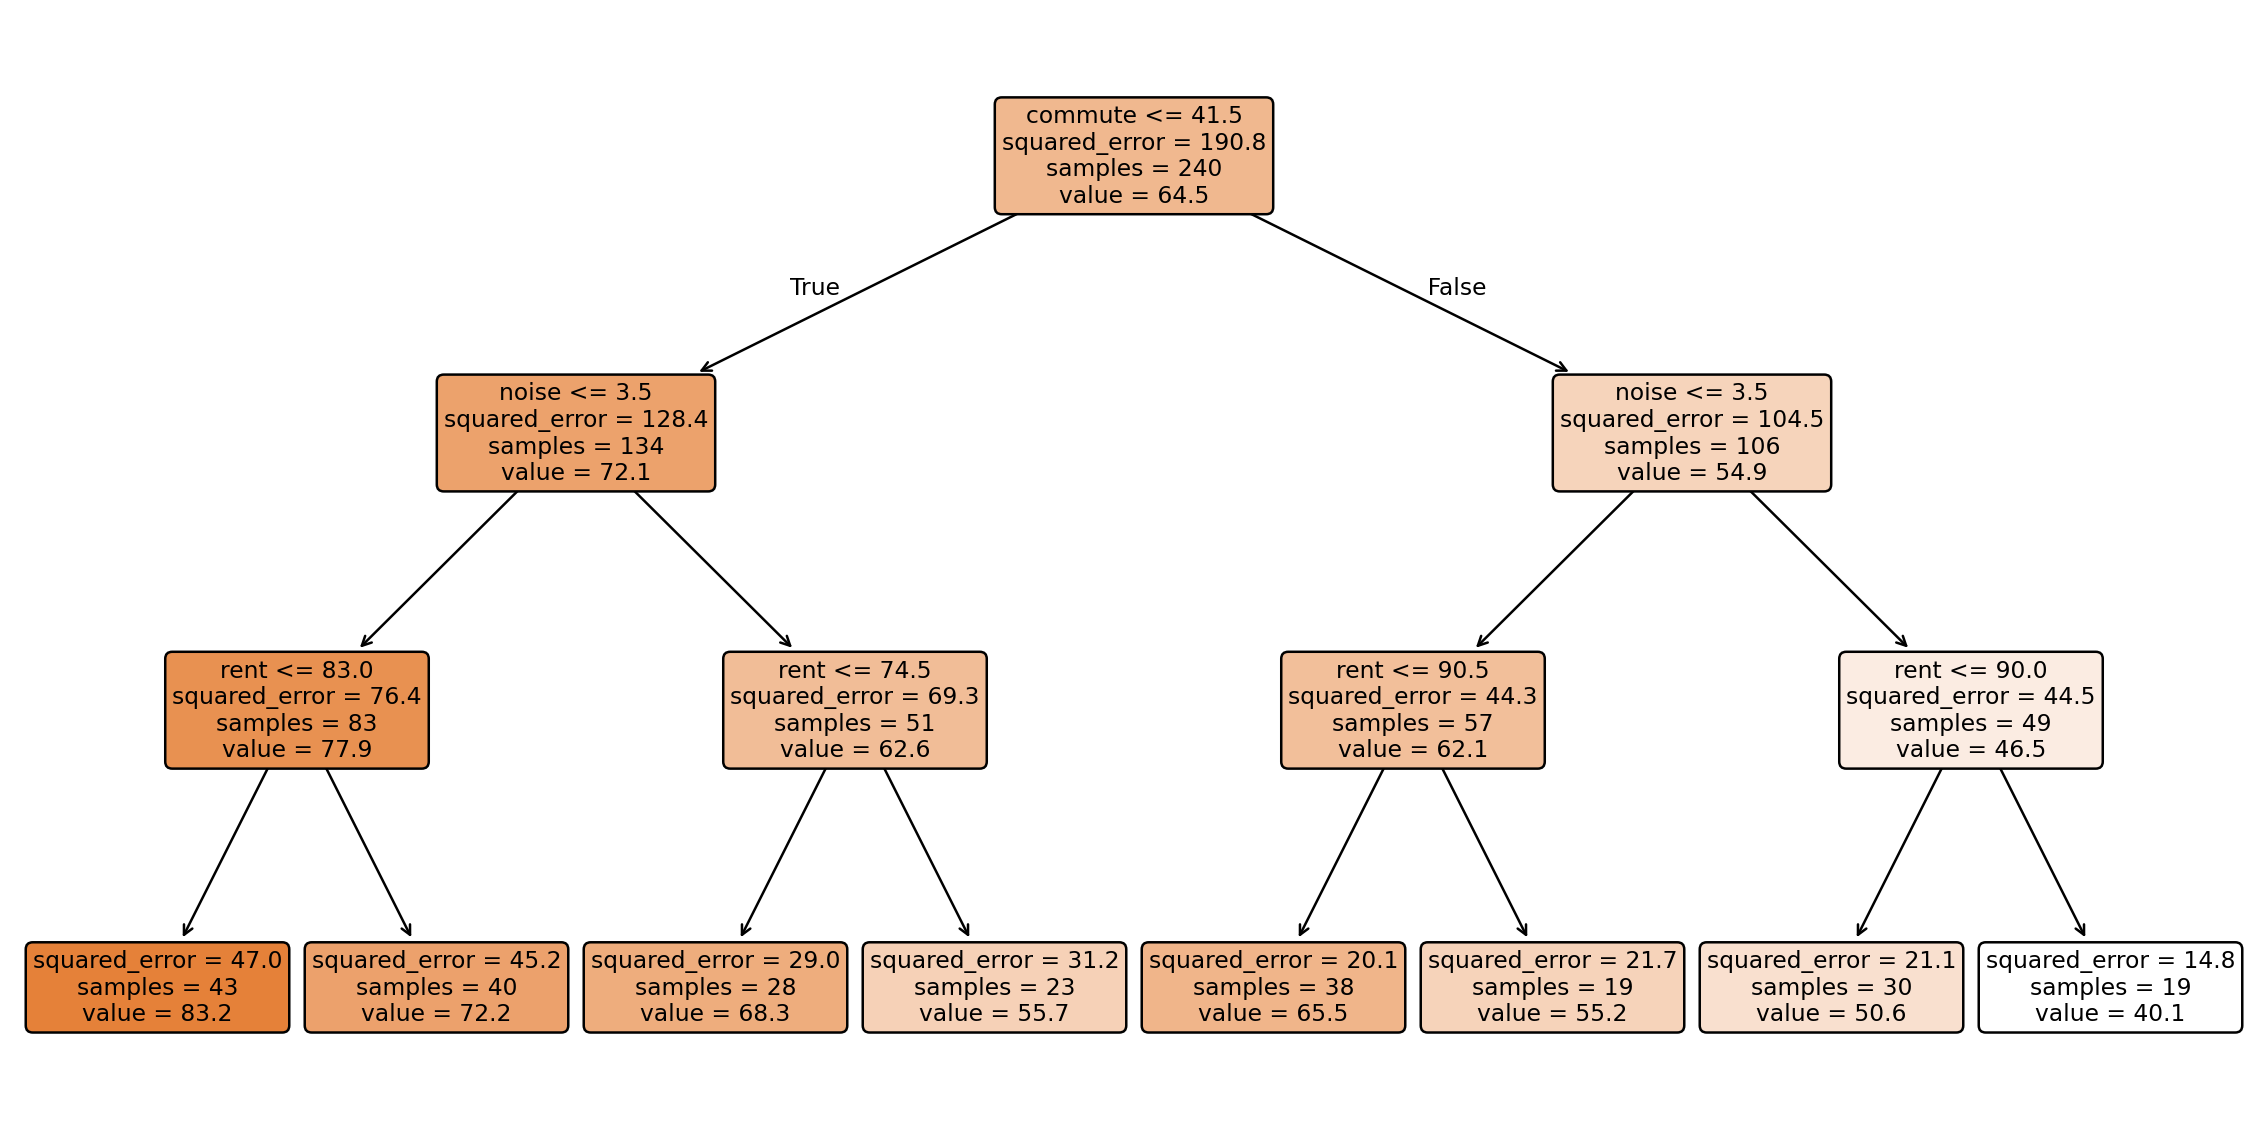
- 위쪽 상자: 첫 질문이 있는 뿌리(root)
- 왼쪽 가지: 질문의 조건을 만족하는 사례
- 오른쪽 가지: 질문의 조건을 만족하지 않는 사례
samples: 해당 지점에 도착한 훈련 사례 수value: 해당 지점에 모인 사례의 평균 만족도
나무의 깊이
- 얕은 나무: 적은 수의 큰 집단과 단순한 규칙
- 깊은 나무: 많은 수의 작은 집단과 세밀한 규칙
- 지나치게 깊은 나무: 훈련 사례를 너무 잘게 나눌 위험
- 깊이 조절:
max_depth로 질문 단계 제한
회귀나무와 분류나무
- 회귀나무: 잎에 모인 타깃의 평균으로 숫자 예측
- 분류나무: 잎에 가장 많이 모인 범주로 분류
- 공통 구조: 한 번에 한 변수에 질문하고 가지를 따라 이동
이 예시의 타깃은 숫자인 주거 만족도. 따라서 DecisionTreeRegressor 사용.
퀴즈
의사결정나무가 새 사례를 예측하는 과정으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.