앙상블 학습
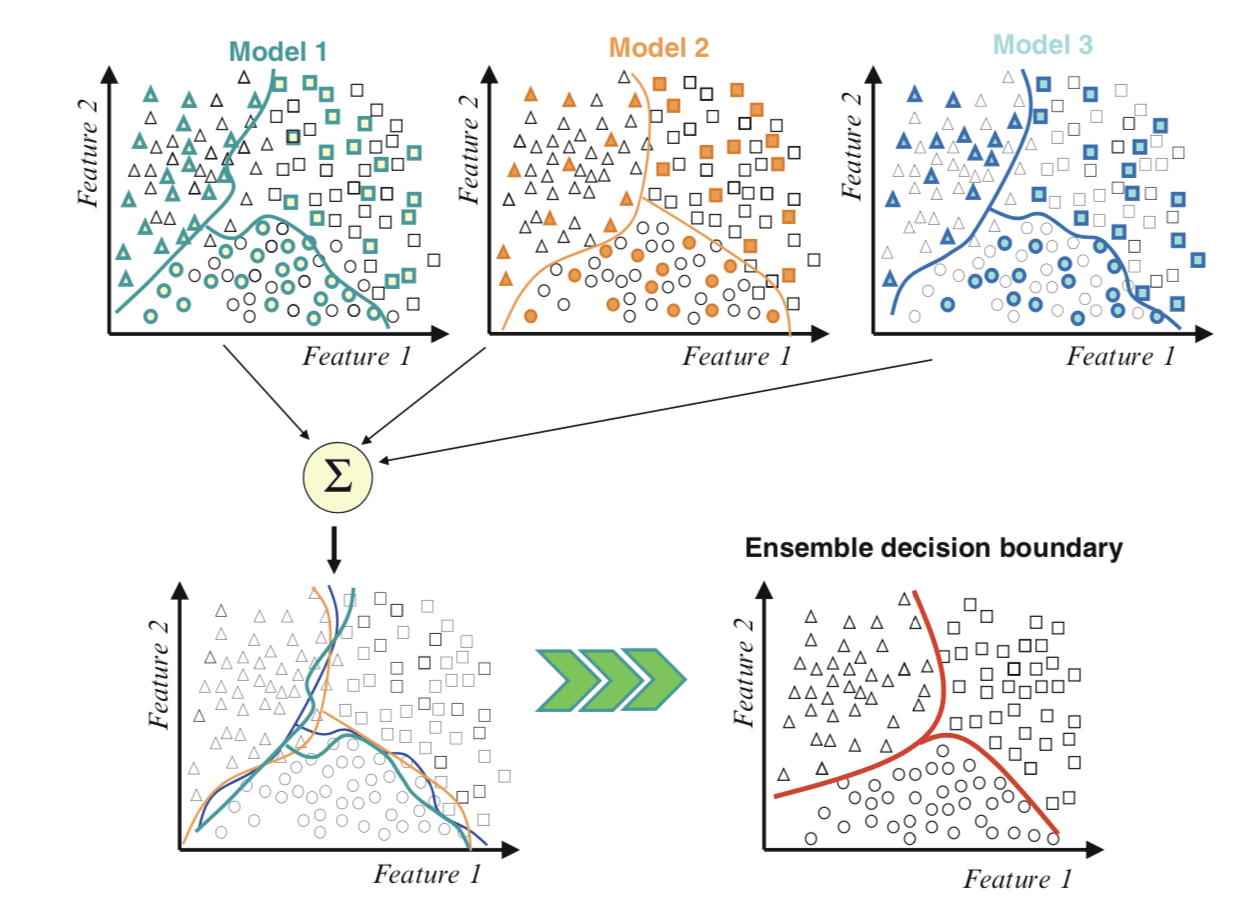
앙상블: 여러 모델의 예측을 결합하는 방법
한 모델의 판단보다 여러 모델의 판단을 모아 안정성 향상
분류에서는 다수결이나 확률 평균 사용
회귀에서는 여러 예측값의 평균 사용
종류
왜 단일 모델보다 안정적인가
단일 모델은 특정 데이터 분할이나 잡음에 흔들릴 수 있음
서로 다른 모델의 오류가 완전히 같지는 않음
여러 예측을 결합하면 우연한 오류를 줄일 수 있음
성능뿐 아니라 변동성 감소도 중요한 장점
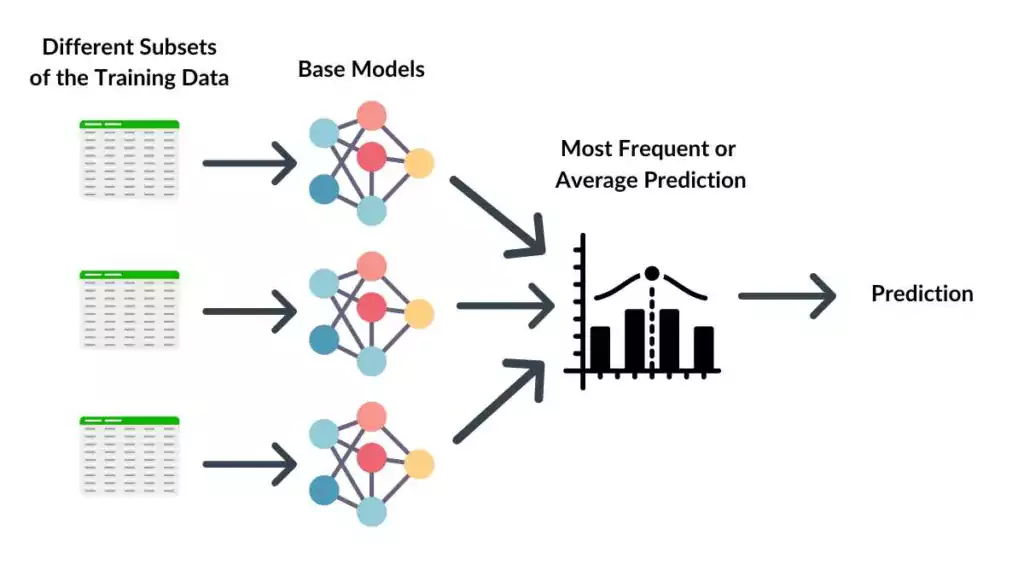
배깅
배깅(bagging): bootstrap aggregation의 약자
데이터셋에서 동일한 크기의 부분집합들을 샘플링
부분집합으로 여러 개의 약한 모델을 학습
각 모델은 조금씩 다른 데이터를 보고 학습
최종 예측은 여러 모델의 평균 또는 다수결
대표 모델: 랜덤 포레스트(random forest)
랜덤 포레스트 분류 실습
여러 결정트리를 학습해 예측을 결합
단일 결정트리보다 과대적합에 강한 편
from sklearn.ensemble import RandomForestClassifier
rf_clf = RandomForestClassifier(n_estimators=200 , random_state=42 )
rf_clf.fit(X_train, y_train)
y_pred_rf = rf_clf.predict(X_test)
accuracy_score(y_test, y_pred_rf)
랜덤 포레스트 변수 중요도
변수 중요도는 모델이 어떤 변수를 많이 활용했는지 확인하는 값
높은 중요도는 예측에 자주 기여했다는 의미
인과관계를 바로 의미하지는 않음
import seaborn as sns
import matplotlib.pyplot as plt
importance = pd.DataFrame({
"feature" : X.columns,
"importance" : rf_clf.feature_importances_,
}).sort_values("importance" , ascending=False ).head(10 )
sns.barplot(data=importance, x="importance" , y="feature" )
부스팅
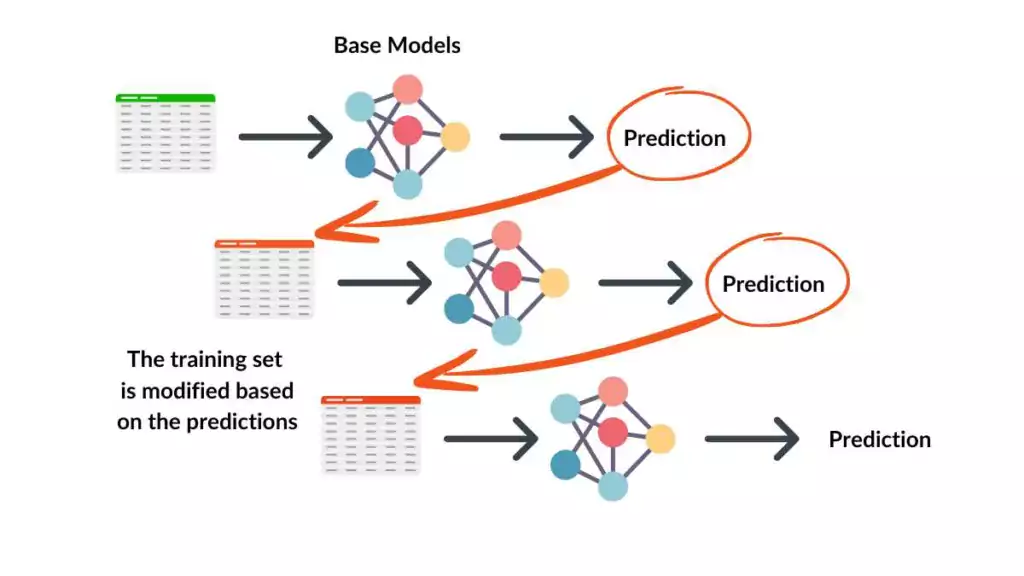
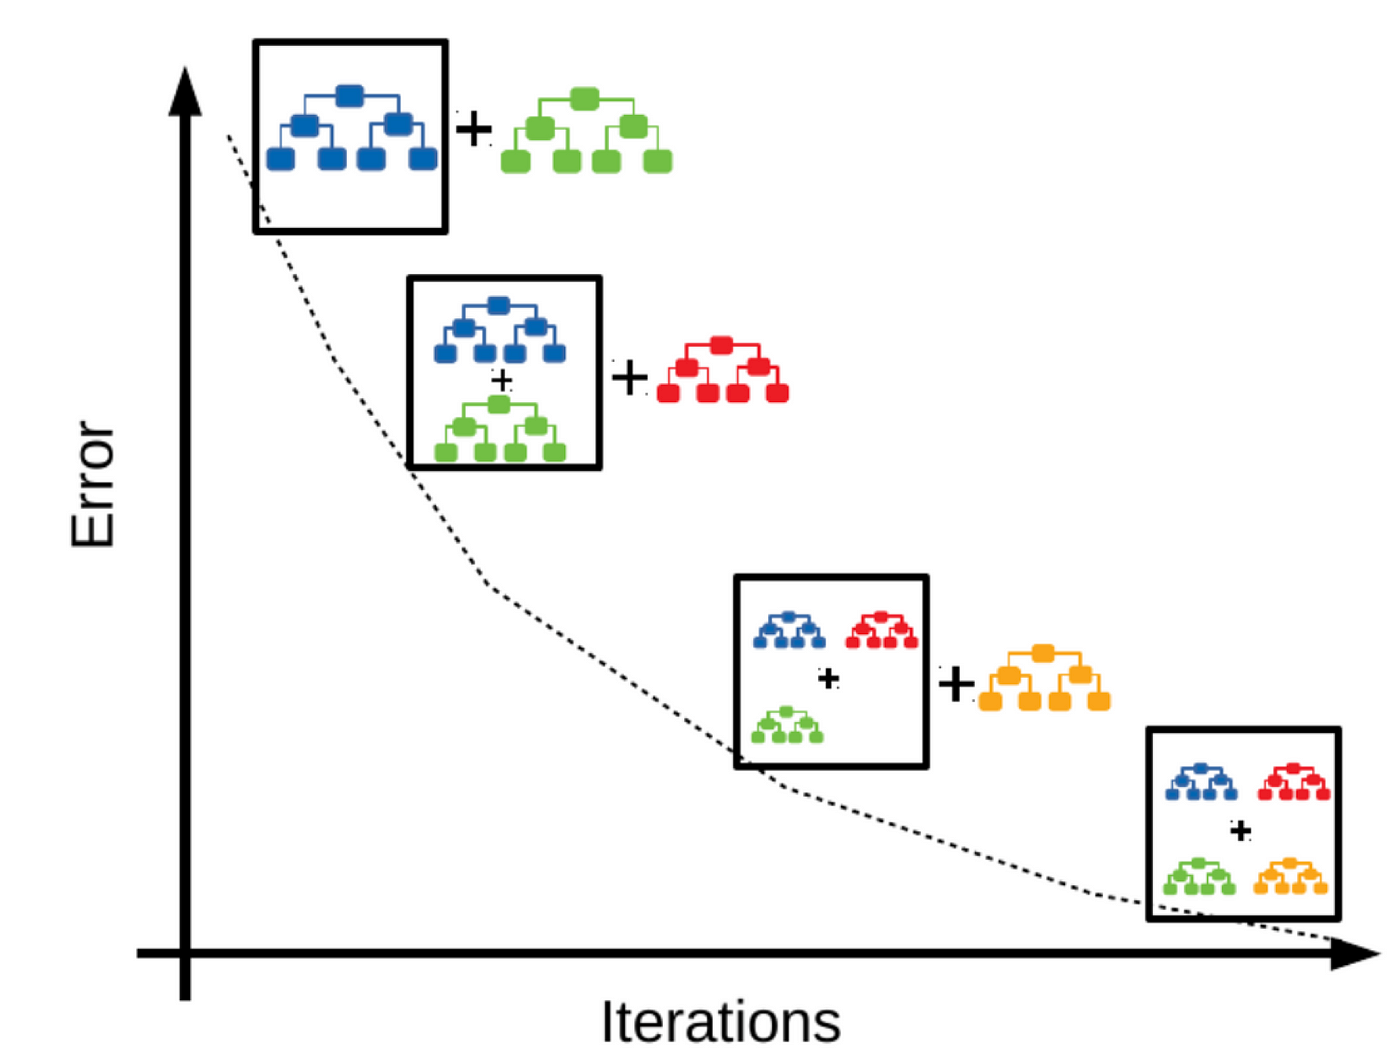
부스팅(boosting): 약한 모델을 순서대로 학습해 앞 모델의 오류를 보완하는 방법
앞 단계에서 틀린 부분에 다음 모델이 더 집중
성능이 강력하지만 학습 설정에 민감할 수 있음
대표 모델: Gradient Boosting, XGBoost, LightGBM
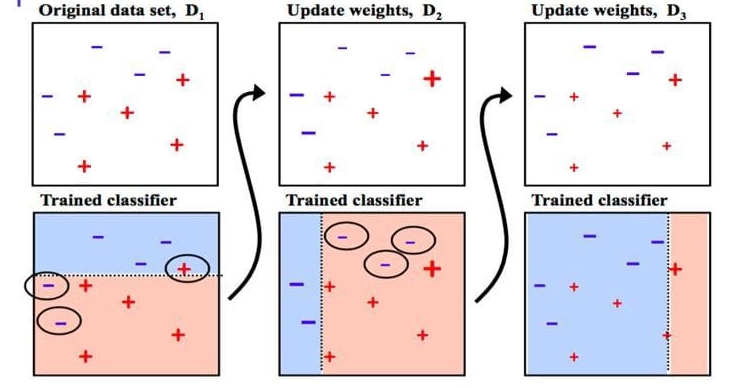
AdaBoost
이전 모델에서 잘못 분류한 사례에 가중치를 주어 다음 모델을 학습
from sklearn.ensemble import AdaBoostClassifier
ada = AdaBoostClassifier(n_estimators=100 , random_state=42 )
ada.fit(X_train, y_train)
y_pred_ada = ada.predict(X_test)
accuracy_score(y_test, y_pred_ada)
경사 부스트
경사 부스트(gradient boost): 경사하강법을 부스팅으로 구현한 것
이전 모델의 예측 오차를 다음 모델로 예측
모델을 추가할 때마다 예측 오차가 점진적으로 줄어듦
from sklearn.ensemble import GradientBoostingClassifier
gb = GradientBoostingClassifier(n_estimators=100 , random_state=42 )
gb.fit(X_train, y_train)
y_pred_gb = gb.predict(X_test)
accuracy_score(y_test, y_pred_gb)
스태킹
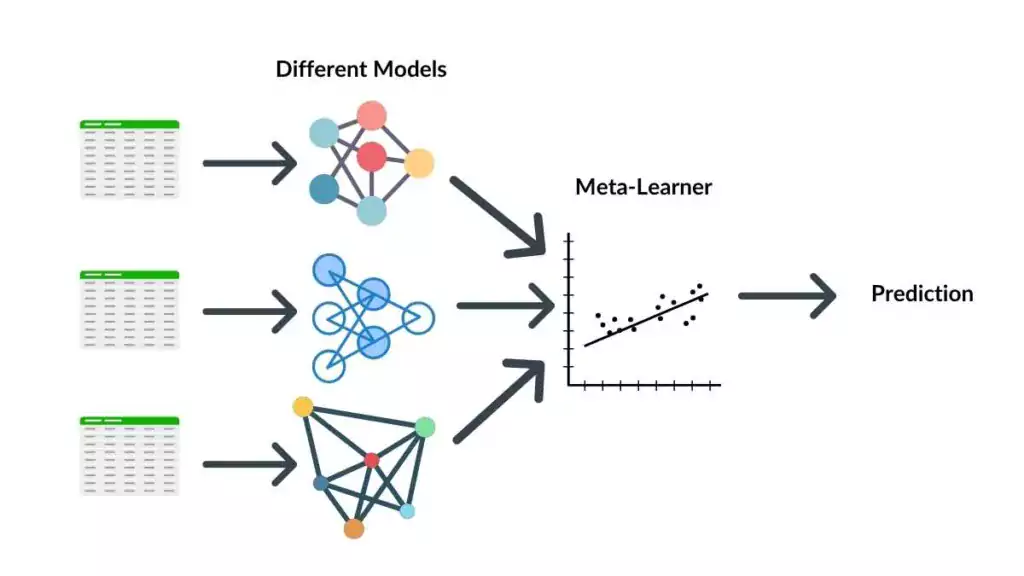
스태킹(stacking): 여러 모델의 예측을 다시 입력으로 사용하는 방식
1단계 모델들이 각자 예측
2단계 모델이 그 예측 결과를 보고 최종 판단
서로 성격이 다른 모델을 조합할 때 활용
StackingClassifier 실습
결정트리와 KNN의 예측을 결합
최종 모델은 얕은 결정트리 사용
서로 다른 모델의 장점을 함께 활용
from sklearn.ensemble import StackingClassifier
stack_clf = StackingClassifier(
estimators=[
("tree" , DecisionTreeClassifier(max_depth=4 , random_state=42 )),
(
"knn" ,
make_pipeline(
StandardScaler(),
KNeighborsClassifier(n_neighbors=5 ),
),
),
],
final_estimator=DecisionTreeClassifier(max_depth=2 , random_state=42 ),
cv=5 ,
)
stack_clf.fit(X_train, y_train)
y_pred_stack = stack_clf.predict(X_test)
accuracy_score(y_test, y_pred_stack)
앙상블의 동향
표 형태의 데이터에서는 의사결정나무에 기반한 앙상블이 주류
특히 경사부스팅 계열 알고리즘인 XGBoost, LightGBM, CatBoost가 각광
딥러닝도 일종의 앙상블로 이해할 수 있음
앙상블은 성능은 높지만 계산량이 많음
예측 정확도보다 계산량이나 속도가 더 중요하면 쓰지 않을 때도 많음
명시적인 앙상블 기법은 아니어도 비슷한 아이디어는 널리 사용됨
예: 넷플릭스 추천 시스템은 한 사용자에게 복수의 추천 알고리즘을 사용
실습 데이터: 데이터센터 장애 위험 예측
데이터센터 운영 기록 1,000건
현재 서버 상태로 1시간 이내 장애 발생 여부 예측
모든 입력 변수가 숫자형이므로 앞에서 사용한 분류 코드를 그대로 적용
incident_next_hour는 0=정상, 1=장애 발생
cpu_util_pctCPU 사용률(%)
memory_util_pct메모리 사용률(%)
disk_io_mb_s초당 디스크 입출력량(MB/s)
request_rate_per_sec초당 요청 수
p95_latency_ms95번째 백분위 응답시간(ms)
packet_loss_pct패킷 손실률(%)
recent_deployments_7d최근 7일 배포 횟수
uptime_days재시작 후 가동 일수
room_temp_c서버실 온도(°C)
incident_next_hour1시간 이내 장애 여부(0=정상, 1=장애 발생)
데이터 불러오기와 학습/평가 데이터 분할
import pandas as pd
from sklearn.model_selection import train_test_split
df_server = pd.read_excel("datacenter_incident.xlsx" )
X = df_server.drop(columns="incident_next_hour" )
y = df_server["incident_next_hour" ]
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.2 ,
random_state=42 ,
stratify=y,
)
위 코드를 실행한 뒤 개념 문항과 이어지는 실습 문항을 순서대로 해결하세요.
퀴즈
○ 정답이 0=정상, 1=장애 발생이라는 두 범주이기 때문에 ○ CPU 사용률과 응답시간이 연속적인 숫자이기 때문에 ○ 전체 데이터가 1,000건으로 고정되어 있기 때문에 ○ 모든 입력 변수의 평균을 계산할 수 있기 때문에 퀴즈를 풀려면 대화형 기능을 불러와야 합니다.
1시간 이내 장애 발생 여부를 예측하는 문제가 분류에 해당하는 이유는?
회귀와 분류는 입력 변수의 형태가 아니라 예측하려는 정답의 형태로 구분합니다.
정답이 0=정상, 1=장애 발생이라는 두 범주이기 때문에 CPU 사용률과 응답시간이 연속적인 숫자이기 때문에 전체 데이터가 1,000건으로 고정되어 있기 때문에 모든 입력 변수의 평균을 계산할 수 있기 때문에
정답이 0=정상, 1=장애 발생이라는 두 범주이기 때문에 앙상블이 단일 모델보다 안정적일 수 있는 이유로 가장 적절한 것은?
결합 효과는 개별 모델의 판단이 완전히 같지 않을 때 생깁니다.
데이터 분할이나 잡음에 따라 서로 다른 오류를 내는 모델들의 예측을 결합하면 우연한 오류를 줄일 수 있다 모든 개별 모델이 같은 결정 경계와 같은 오답을 내도록 만들면 오류가 줄어든다 여러 모델 중 훈련 정확도가 가장 높은 하나만 선택하면 예측의 변동성이 사라진다 각 모델의 예측을 결합하지 않고 하나씩 번갈아 사용하면 항상 같은 결과를 얻는다
데이터 분할이나 잡음에 따라 서로 다른 오류를 내는 모델들의 예측을 결합하면 우연한 오류를 줄일 수 있다 배깅(bagging)에 대한 설명으로 가장 적절한 것은?
배깅은 복원추출한 서로 다른 데이터에서 모델들을 독립적으로 학습하는 방식입니다.
여러 데이터 부분집합으로 모델들을 학습하고 예측을 평균이나 다수결로 결합한다 앞 모델이 틀린 관측치의 가중치를 높여 다음 모델을 순서대로 학습한다 기본 모델의 예측을 새로운 입력으로 삼아 메타 모델을 학습한다 하나의 결정트리를 이전보다 더 깊게 확장한다
여러 데이터 부분집합으로 모델들을 학습하고 예측을 평균이나 다수결로 결합한다 max_depth=4, random_state=42를 사용한 단일 결정트리의 테스트 정확도를 소수점 넷째 자리까지 입력하세요.
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
tree_clf = DecisionTreeClassifier(
max_depth=4 , random_state=42
)
tree_clf.fit(X_train, y_train)
y_pred_tree = tree_clf.predict(X_test)
accuracy_score(y_test, y_pred_tree)
0.7150 n_estimators=200, random_state=42를 사용한 랜덤 포레스트의 테스트 정확도를 소수점 넷째 자리까지 입력하세요.
from sklearn.ensemble import RandomForestClassifier
rf_clf = RandomForestClassifier(
n_estimators=200 , random_state=42
)
rf_clf.fit(X_train, y_train)
y_pred_rf = rf_clf.predict(X_test)
accuracy_score(y_test, y_pred_rf)
0.7300 랜덤 포레스트 변수 중요도에 대한 해석으로 가장 적절한 것은?
변수 중요도는 학습된 모델 내부의 활용 정도이며 원인 효과를 측정한 값은 아닙니다.
모델이 예측 과정에서 어떤 변수를 많이 활용했는지 보여주지만 인과관계를 뜻하지는 않는다 중요도가 가장 높은 변수가 장애의 원인임을 실험 없이 확정한다 중요도가 낮은 변수는 데이터에서 항상 제거해야 한다 중요도의 합이 모델의 테스트 정확도와 같다는 뜻이다
모델이 예측 과정에서 어떤 변수를 많이 활용했는지 보여주지만 인과관계를 뜻하지는 않는다 학습한 랜덤 포레스트의 변수 중요도가 가장 높은 입력 변수는?
importance = pd.DataFrame({
"feature" : X.columns,
"importance" : rf_clf.feature_importances_,
}).sort_values("importance" , ascending=False )
importance
내림차순으로 정렬한 첫 번째 행의 변수명을 확인하세요.
request_rate_per_seccpu_util_pctuptime_daysrecent_deployments_7d
request_rate_per_secAdaBoost가 다음 모델을 학습하는 방식으로 가장 적절한 것은?
AdaBoost는 앞 단계에서 맞히기 어려웠던 관측치에 다음 학습의 초점을 둡니다.
이전 모델이 잘못 분류한 관측치의 가중치를 높여 더 집중한다 모든 모델을 같은 데이터와 같은 가중치로 독립적으로 학습한다 기본 모델의 예측을 메타 모델의 입력으로만 사용한다 각 단계에서 임의의 특성을 하나씩 영구적으로 제거한다
이전 모델이 잘못 분류한 관측치의 가중치를 높여 더 집중한다 n_estimators=100, random_state=42를 사용한 AdaBoost의 테스트 정확도를 소수점 넷째 자리까지 입력하세요.
from sklearn.ensemble import AdaBoostClassifier
from sklearn.metrics import accuracy_score
ada = AdaBoostClassifier(
n_estimators=100 , random_state=42
)
ada.fit(X_train, y_train)
y_pred_ada = ada.predict(X_test)
accuracy_score(y_test, y_pred_ada)
0.7200 경사 부스트(gradient boost)의 기본 아이디어로 가장 적절한 것은?
경사 부스트에서는 새 모델이 이전 모델까지 남긴 오차를 보완합니다.
이전 단계의 예측 오차를 줄이는 방향으로 모델을 순서대로 추가한다 복원추출한 데이터 부분집합에서 모든 모델을 동시에 학습한다 각 기본 모델의 예측을 단순 다수결 없이 그대로 반환한다 훈련 데이터의 정답을 사용하지 않고 군집을 만든다
이전 단계의 예측 오차를 줄이는 방향으로 모델을 순서대로 추가한다 n_estimators=100, random_state=42를 사용한 경사 부스트의 테스트 정확도를 소수점 넷째 자리까지 입력하세요.
from sklearn.ensemble import GradientBoostingClassifier
gb = GradientBoostingClassifier(
n_estimators=100 , random_state=42
)
gb.fit(X_train, y_train)
y_pred_gb = gb.predict(X_test)
accuracy_score(y_test, y_pred_gb)
0.7150 스태킹(stacking)의 특징으로 가장 적절한 것은?
스태킹은 기본 모델 단계와 그 예측을 결합하는 메타 모델 단계로 구성됩니다.
여러 기본 모델의 예측을 새로운 입력으로 사용해 메타 모델이 최종 예측한다 하나의 모델이 틀린 관측치의 가중치만 계속 높인다 복원추출한 데이터에서 같은 종류의 모델만 독립적으로 학습한다 여러 모델 중 훈련 정확도가 가장 높은 하나만 남긴다
여러 기본 모델의 예측을 새로운 입력으로 사용해 메타 모델이 최종 예측한다 결정트리와 표준화한 KNN을 결합한 스태킹 모델의 테스트 정확도를 소수점 넷째 자리까지 입력하세요.
from sklearn.ensemble import StackingClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
stack_clf = StackingClassifier(
estimators=[
("tree" , DecisionTreeClassifier(
max_depth=4 , random_state=42
)),
("knn" , make_pipeline(
StandardScaler(),
KNeighborsClassifier(n_neighbors=5 )
)),
],
final_estimator=DecisionTreeClassifier(
max_depth=2 , random_state=42
),
cv=5
)
stack_clf.fit(X_train, y_train)
y_pred_stack = stack_clf.predict(X_test)
accuracy_score(y_test, y_pred_stack)
0.7250 앙상블 모델의 실무적 특징으로 가장 적절한 것은?
성능 향상 가능성과 여러 모델을 학습하는 계산 비용을 함께 고려하세요.
표 데이터에 자주 쓰이며 성능이 높을 수 있지만 계산량이 늘어날 수 있다 표 데이터에는 거의 쓰이지 않으며 단일 모델보다 계산량이 항상 적다 같은 데이터로 학습하면 모든 앙상블 기법의 예측이 같다 여러 모델을 결합하면 항상 단일 모델보다 정확하다
표 데이터에 자주 쓰이며 성능이 높을 수 있지만 계산량이 늘어날 수 있다 이 고정된 테스트 분할에서 테스트 정확도가 가장 높은 모델은?
pd.Series({
"decision_tree" : tree_accuracy,
"random_forest" : rf_accuracy,
"adaboost" : ada_accuracy,
"gradient_boosting" : gb_accuracy,
"stacking" : stack_accuracy,
}).sort_values(ascending=False )
정확도를 내림차순으로 정렬한 첫 번째 모델을 확인하세요.
랜덤 포레스트 스태킹 AdaBoost 결정트리와 경사 부스트 공동
랜덤 포레스트