컨텍스트 엔지니어링
모델에 무엇을 보여 줄지 설계하는 컨텍스트 엔지니어링의 개념과 관리 기법 6가지를 정리하고, 그중 가지치기·요약·외부 저장·격리의 방법과 사례를 다룬다.
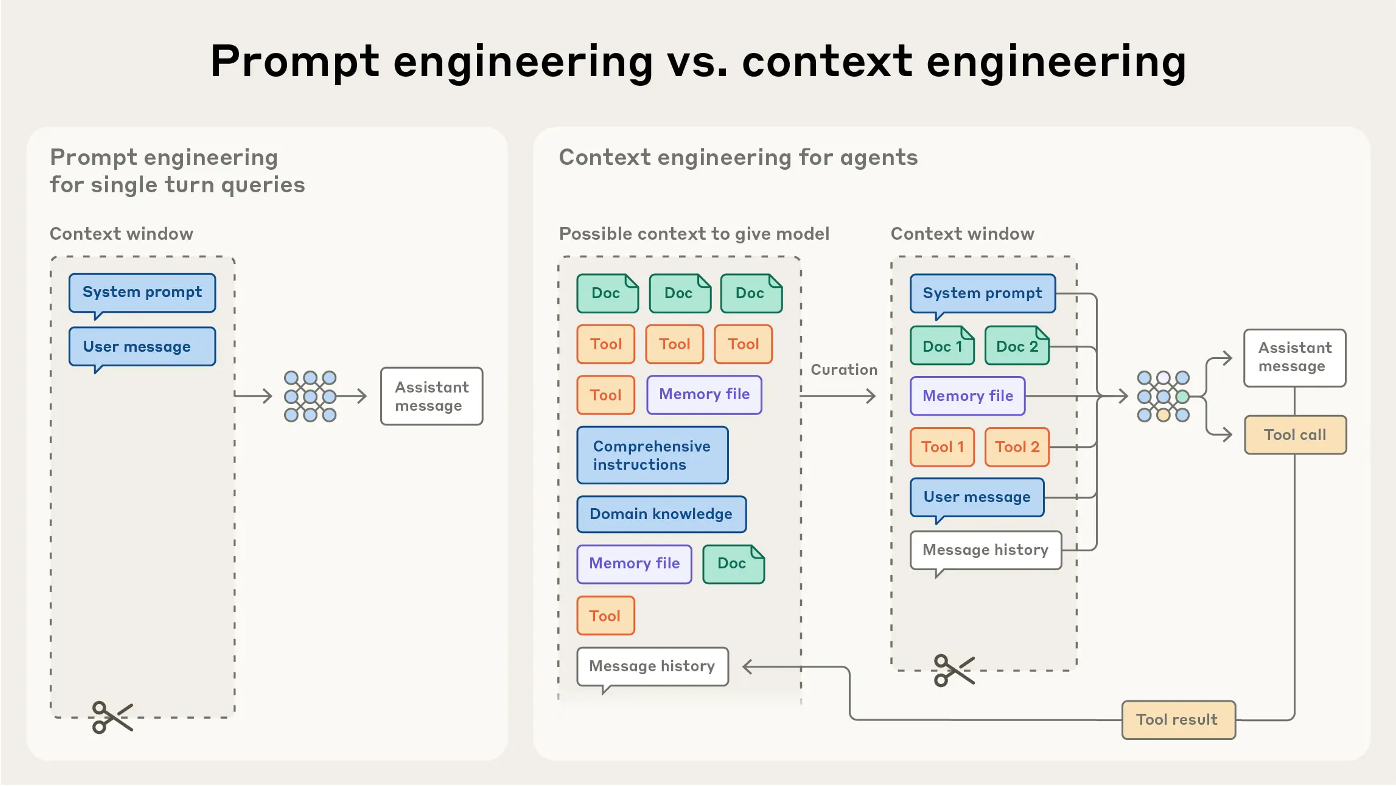
- 컨텍스트 엔지니어링(context engineering): 모델이 이번 호출에서 볼 정보를 고르고 배치하는 설계.
- 사용자가 바꿀 수 있는 것은 대부분 컨텍스트.
- 결과를 좋게 만드는 방법: 더 큰 모델(비쌈), 더 오래 추론(느림), 더 나은 컨텍스트(싸고 빠름).
컨텍스트 관리 기법 6가지
| 기법 | 하는 일 |
|---|---|
| 보강(augmentation) | RAG·스킬로 필요한 정보를 가져옴 |
| 도구 선별(tool loadout) | 이번 작업에 필요한 도구만 보여 줌 |
| 가지치기(pruning) | 필요 없는 이력·도구 결과를 지움 |
| 요약(summarization, compaction) | 긴 이력을 짧은 브리핑으로 압축 |
| 외부 저장(offloading) | 파일·DB에 두었다가 필요할 때 읽음 |
| 격리(quarantine) | 하위 작업을 빈 이력의 하위 에이전트에 맡김 |
- 보강, 도구 선별은 앞서 다룸
가지치기
- 가지치기(pruning): 지금 판단에 필요 없는 이력·도구 결과를 입력에서 지움.
- 지울 대상: 인사말·잡담, 같은 문서를 여러 번 조회한 결과, 처리가 끝난 도구 출력.
- 발췌(excerpt): 원문을 통째로 지우지 않고 필요한 부분만 그대로 남기는 가지치기. 예: 긴 문서·검색 결과에서 질문과 관련된 단락만.
- 지우면 안 되는 것: 아직 해결하지 못한 질문, 사용자가 정한 결정·제약, 판단을 바꾸는 수치·날짜.
- 비용: 이력의 앞부분을 바꾸면 프롬프트 캐싱이 깨질 수 있음. 요약도 마찬가지.
결과만 남기고 과정은 잊기
- Tan 외(2026): 점수로 채점되는 문제(휴리스틱 프로그래밍, 커널 최적화, 소형 언어 모델 학습)에서 에이전트가 후보 해를 반복 개선하는 자동 연구(autoresearch) 실험.
- 문제: 한 에이전트를 오래 돌리든, 여러 에이전트를 병렬로 돌리든, 서로의 후보를 공유하게 하든 이력이 쌓이면 결국 정체(plateau).
- 에이전트가 자기의 과거 시도에 묶여(anchoring) 수정이 점점 작고 보수적이 됨. 예산을 더 써도 개선이 거의 없음.
- 망각(forgetting): 일정 시점마다 모든 에이전트의 세션과 후보 이력을 지우고 지금까지 가장 좋은 후보 하나만 남김. 빈 컨텍스트의 새 에이전트가 그 후보에서 다시 시작.
- 잃는 것이 적음: 가장 좋은 후보에 이전의 진전이 대부분 담겨 있음. 지워지는 것은 주로 "어떻게 거기에 도달했는가"의 기록.
- 새 에이전트는 이전의 실패한 시도에 끌려가지 않음.
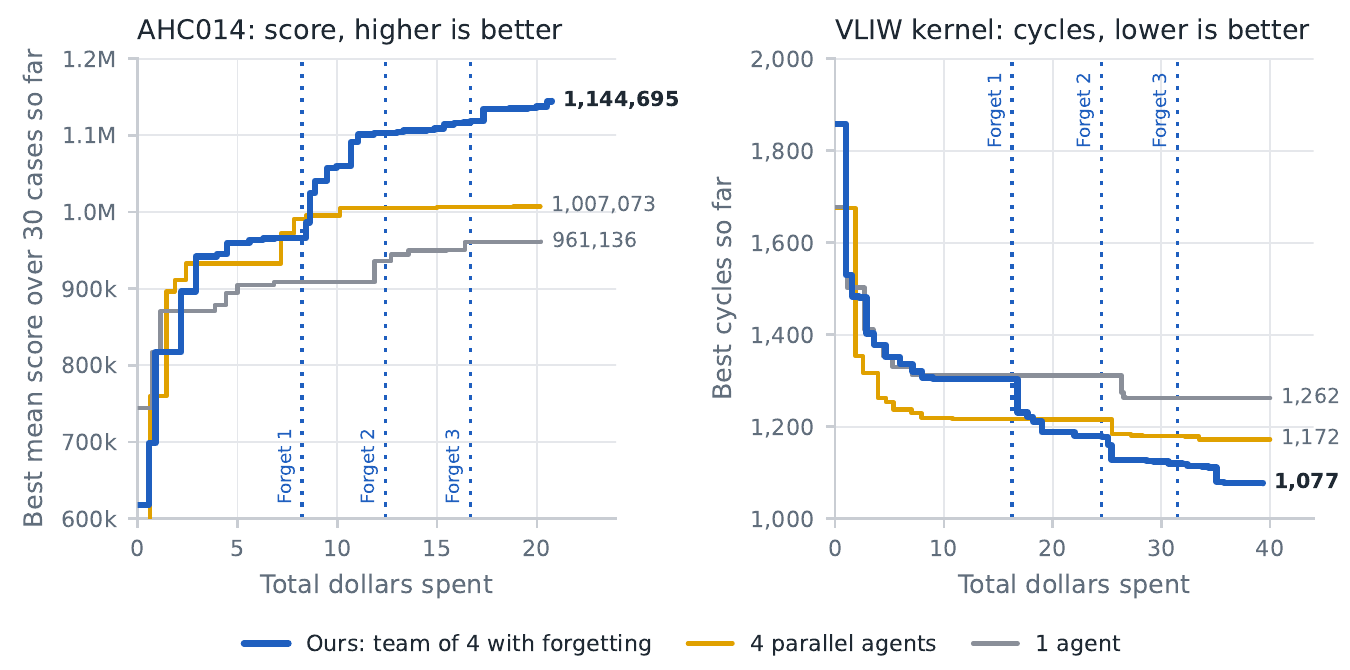
- 왼쪽은 점수(높을수록 좋음), 오른쪽은 커널 실행 사이클(낮을수록 좋음). 점선마다 팀 전체가 망각.
- 단일 에이전트(회색)와 병렬 에이전트 4개(노랑)는 일찍 정체. 망각하는 4개 에이전트 팀(파랑)은 점선을 지날 때마다 다시 개선.
- 네 과제에서 같은 비용으로 병렬 에이전트보다 최대 15%, 단일 에이전트보다 최대 39% 개선. 효과는 첫 망각이 가장 큼.
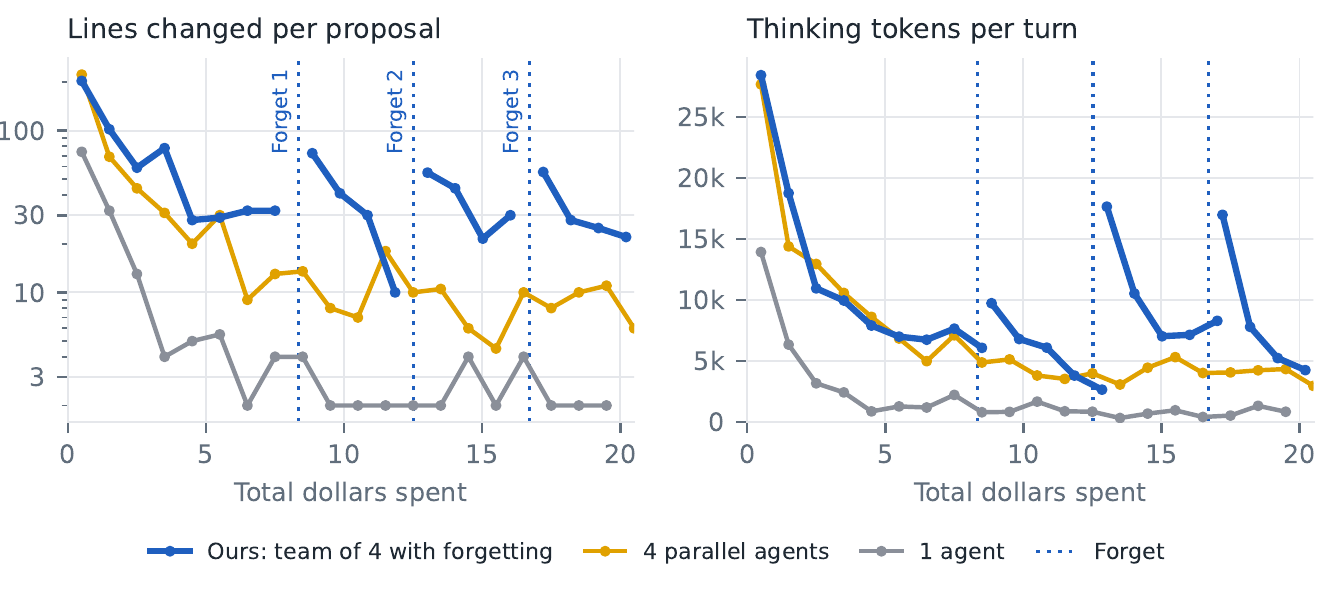
- 세션이 길어질수록 탐색이 좁아짐: 제안당 수정한 코드 줄 수(왼쪽, 로그 척도)와 추론 토큰(오른쪽)이 함께 감소.
- 팀은 첫 망각 전까지 수정이 약 150줄 → 30줄, 추론이 약 28k → 7k 토큰으로 줄었다가 망각 직후 다시 커짐.
- 극단적인 경우 단일 에이전트는 "이 기계 구성의 실질적 한계에 도달했다"며 제안을 멈춤. 같은 과제에서 망각하는 팀은 훨씬 더 나은 결과에 도달.
- 같은 정체 상태에서 30번 더 제안할 때, 세션을 이어 가면 +1.4-1.9%, 망각하면 +4.5-9.2%. 비용은 망각 쪽이 약 절반(컨텍스트가 짧음).
- 시사점: 결과물은 남기고 과정의 기록은 지우는 것도 가지치기. 에이전트가 무엇을 기억하게 할지가 계산량만큼 중요.
출처: Tan 외(2026), Scaling Discovery Requires Forgetting, 그림 1·5(CC BY 4.0).
요약
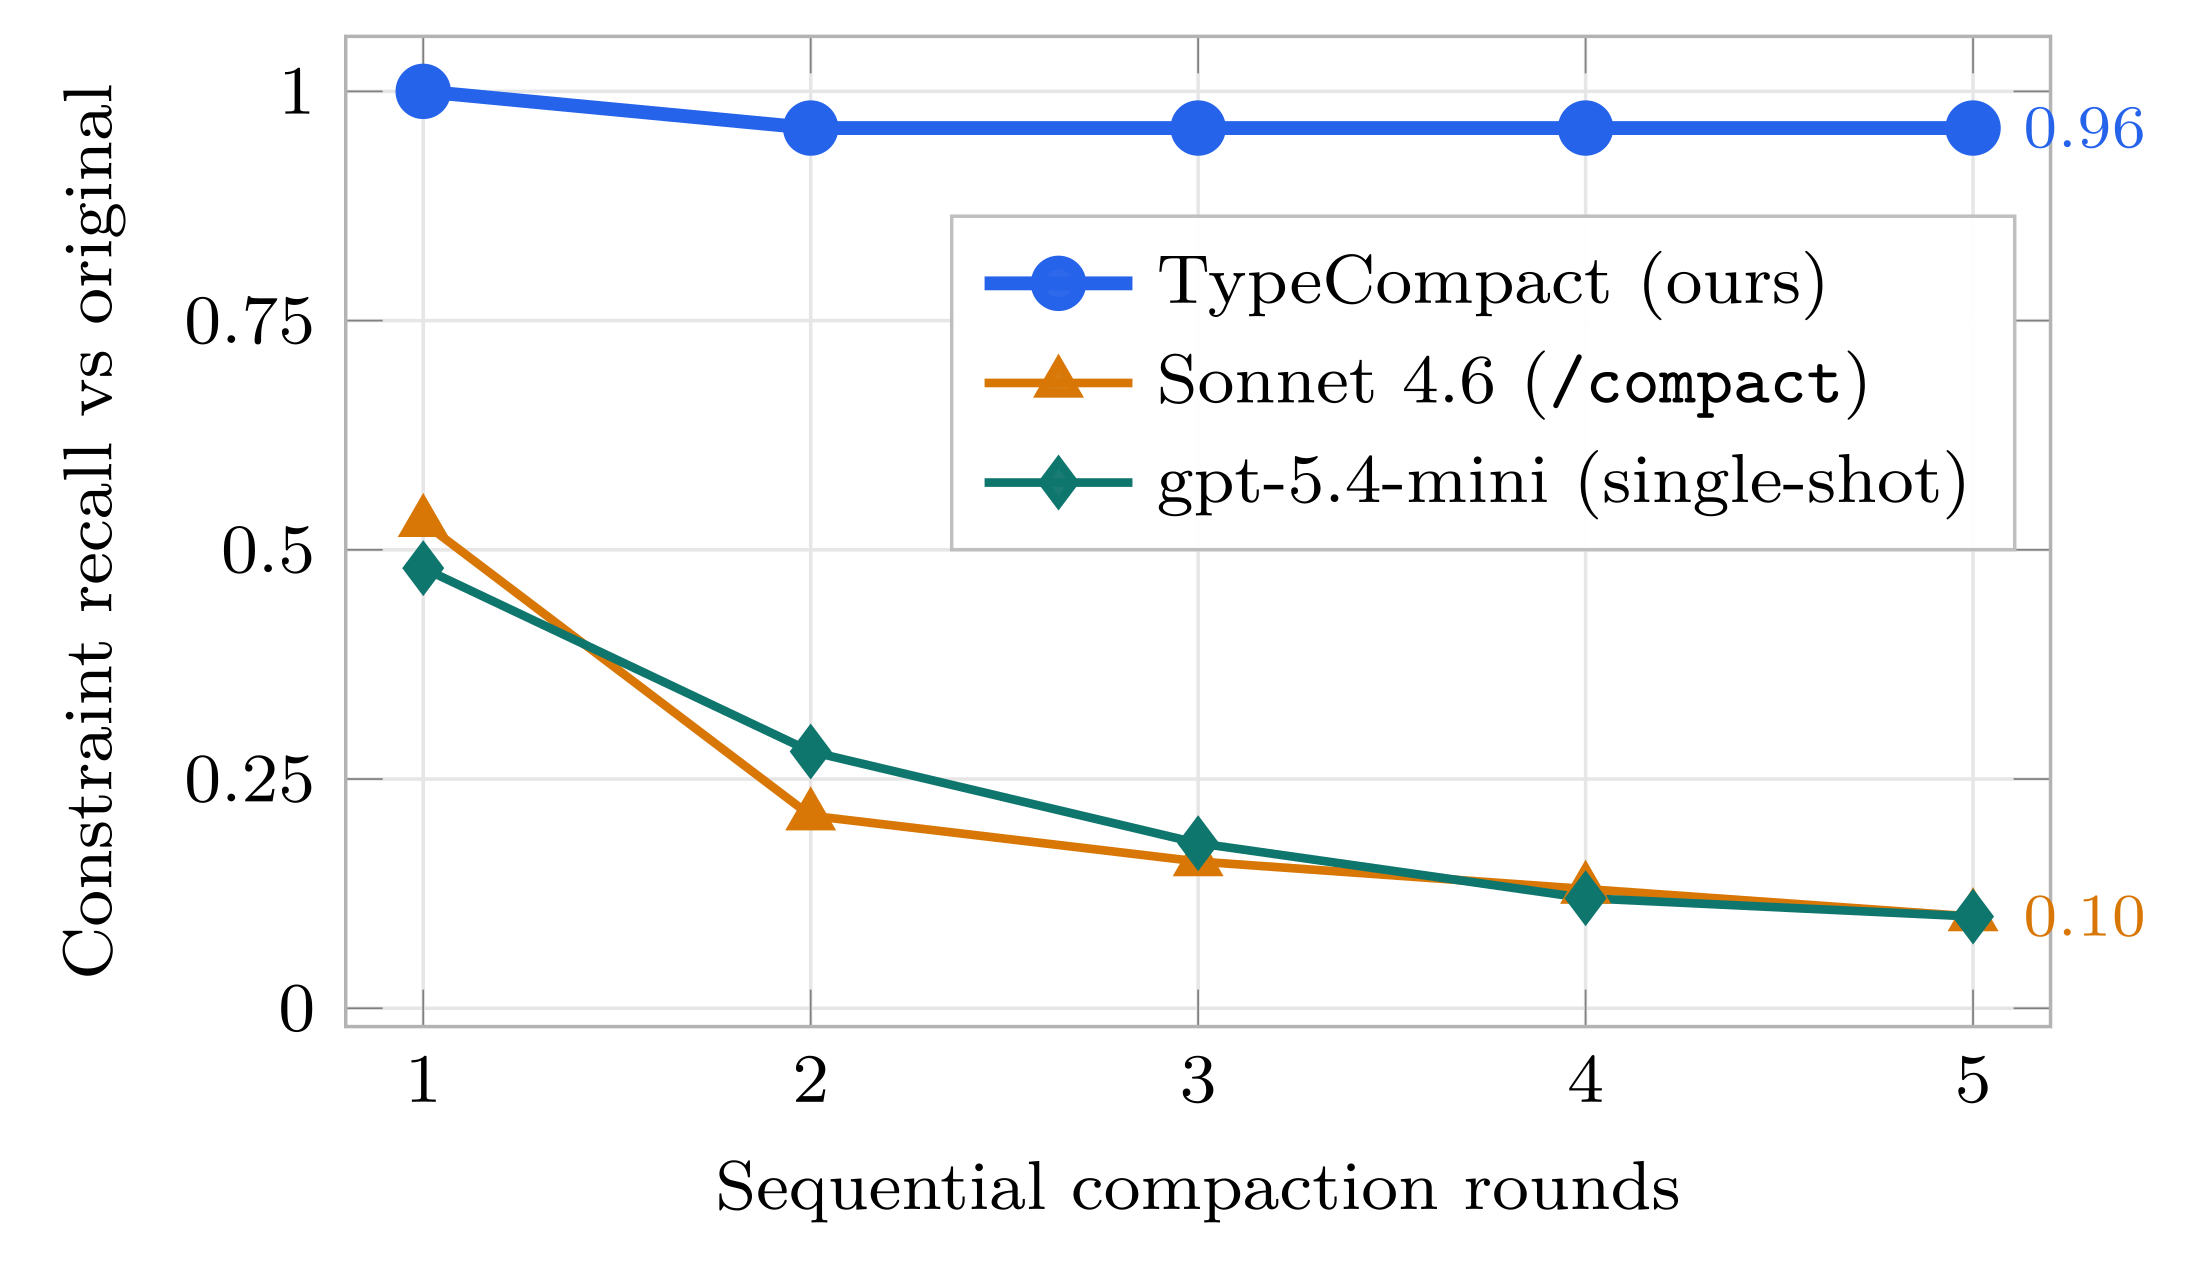
- 요약(summarization, compaction): 긴 이력을 다음 호출에 넣을 짧은 작업 상태로 압축.
- 단점: 반복 요약에 따른 정보 손실
- Claude Code의
/compact프롬프트로 다섯 번 압축하면 원래 규칙의 10%만 남음. 규칙·절차를 원문으로 보존하는 TypeCompact는 96%. 출처: Zerhoudi 외(2026), The Compaction Cliff in Long-Running AI Agent Memory, 그림 3.
- Claude Code의
외부 저장
- 외부 저장(offloading): 정보를 파일·DB에 두었다가 필요할 때 읽어 컨텍스트에 넣음.
- 공통 원리: 모델의 가중치는 바뀌지 않음. 대화 밖에 저장해 둔 정보를 다음 대화의 컨텍스트에 다시 넣는 장기 기억.
- 설계의 갈림길은 세 가지.
- 무엇을 저장할까: 사용자에 대한 사실·선호를 짧은 항목으로 / 과거 대화 전체 / 작업 중 배운 내용을 파일로
- 언제 불러올까: 매 대화에 자동으로 넣기(항상 주입) / 필요할 때 모델이 찾아 읽기(검색)
- 어디까지 공유할까: 사용자 전체 / 프로젝트별로 분리
- ChatGPT 및 클로드의 외부 저장 기능
- 메모리: 대화 중 기억할 만한 사실·선호(직업, 원하는 답변 형식 등)를 짧은 항목으로 저장해 이후 대화에 반영. 사용자가 "기억해 줘"라고 하거나 모델이 스스로 고름.
- 대화 기록 참조: 따로 저장하지 않은 과거 대화에서도 관련 내용을 찾아 반영.
- Anthropic 내부 평가에서 가지치기와 외부 저장을 함께 쓸 때 39%, 가지치기만 쓸 때 29% 개선.
격리
- 격리(quarantine): 하위 작업을 빈 이력(blank history)의 하위 에이전트에 맡기고 결과만 돌려받음.
- 대표 구조는 오케스트레이터-워커(orchestrator-worker): 관리자(오케스트레이터) 에이전트가 작업을 나눠 하위 에이전트(sub-agent, 워커)에게 맡기고 결과를 종합.
- 효과:
- 검색 결과·실패한 시도는 하위 에이전트에만 남고 관리자에는 요약만 들어감 → 관리자의 컨텍스트가 짧고 깨끗함.
- 하위 에이전트마다 다른 지시문·도구·더 싼 모델 사용 가능.
- 대가:
- 요약 과정의 정보 손실, 하위 에이전트끼리 서로의 결정을 모름
- 하위 작업은 "서로 독립적이고 결과를 짧게 요약할 수 있는" 것이 좋음. 조사(research)가 대표적.
- 작업 분해가 관리자의 핵심 역할. 하위 주제가 겹치거나 빠지면 하위 에이전트가 잘해도 결과가 나쁨.
- 요약에 없는 근거는 최종 답에도 없음 → 요약에 무엇을 담을지 지시하는 것이 중요. 실제 시스템은 출처 목록을 함께 주거나 자세한 결과를 파일에 저장하고 경로만 돌려줌(외부 저장과 결합).
- 호출 수가 늘어남: 관리자 호출에 하위 에이전트 수 × 하위 호출 수가 더해져 단일 호출보다 비용이 몇 배.
퀴즈
긴 대화 이력을 가지치기할 때 남겨 두어야 하는 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.