소형 언어 모델
스케일링 법칙과 친칠라 법칙으로 이해하는 소형 언어 모델의 학습 전략과 활용 기준
소형 언어 모델
- 소형 언어 모델(Small Language Model, SLM): 상대적으로 적은 파라미터와 실행 자원으로 활용하도록 설계한 언어 모델
- 범용 모델로 활용하거나 특정 업무에 맞춰 추가 학습 가능
- 규모의 기준: 통일된 경계는 없으며 아래 그림의 바탕이 된 연구는 100M-5B 모델을 분석
- 구조: 많은 SLM이 디코더 전용 트랜스포머를 사용
- 합성곱과 어텐션을 결합한 LFM2처럼 실행 효율을 고려한 다른 구조도 존재
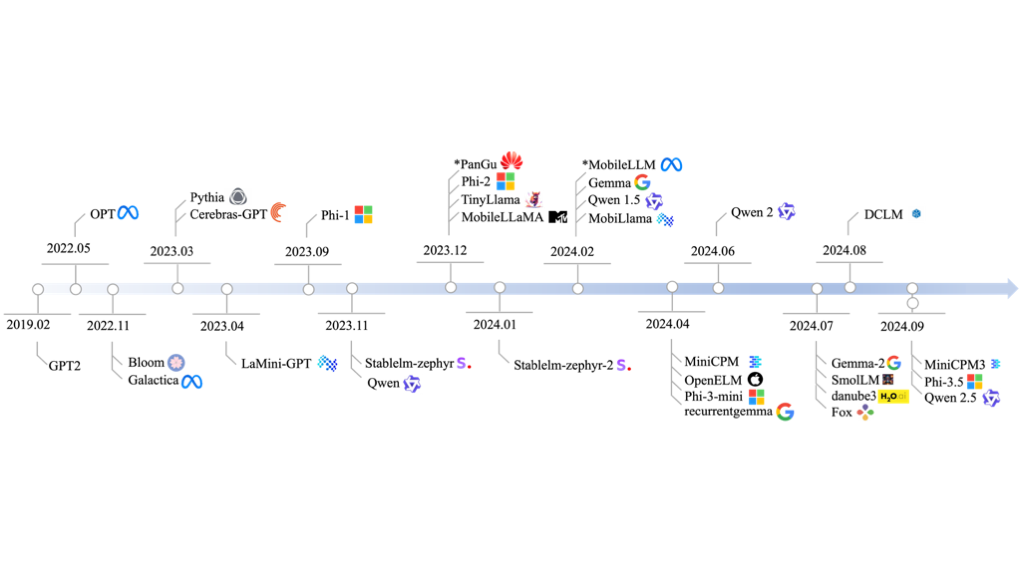
- Small Language Models: Survey, Measurements, and Insights (Lu 외, 2024)
- LFM2 Technical Report (Amini 외, 2025)
스케일링 법칙과 친칠라 법칙
- 스케일링 법칙: 모델 크기·학습 토큰 수·계산량과 예측 손실 사이에 관찰되는 경험적 관계
- 친칠라 법칙(Chinchilla scaling law): 스케일링 법칙을 바탕으로 주어진 사전학습 계산량에서 손실을 줄이는 모델 크기와 토큰 수의 균형을 추정
- 같은 학습 예산으로 큰 모델을 적은 데이터로 학습하거나 작은 모델을 많은 데이터로 학습하는 선택 가능
- 연구 결과: 학습 계산량을 늘릴 때 모델 크기와 학습 토큰 수를 대략 같은 비율로 확대하는 것이 유리
- 예: 모델 크기를 두 배로 늘리면 학습 토큰 수도 두 배로 확대
- Kaplan 외(2020)의 추정보다 모델을 덜 키우고 데이터를 더 늘리는 쪽으로 수정된 결과
- 파라미터당 약 20개 토큰: 해당 연구에서 얻은 근사적인 학습 기준
- 1B 파라미터 모델이라면 약 20B 학습 토큰에 해당
- 모든 모델에 적용되는 고정 비율이나 더 학습해도 효과가 없다는 상한은 아님
- 당시 모델에 대한 해석: 모델 크기에 비해 학습 토큰 수가 부족한 경우가 많았음
- 모델이 크기만 하고 충분한 데이터로 학습하지 않으면 같은 계산량으로 더 좋은 성능을 얻을 기회를 놓칠 수 있음
- 모델을 조금 줄이고 학습 토큰 수를 늘리는 편이 더 낮은 손실을 얻는 경우도 존재
- GPT-3: 175B 파라미터를 300B 토큰으로 학습
- 친칠라: Gopher(280B)와 같은 학습 계산량으로 모델을 70B로 줄이고 데이터를 1.4T 토큰으로 늘려 성능 개선
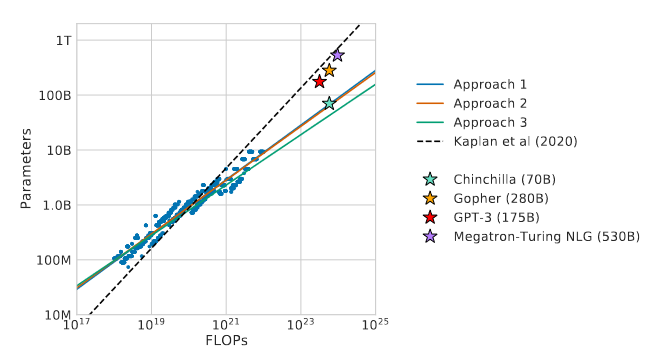
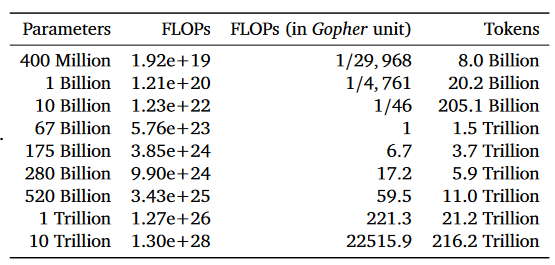
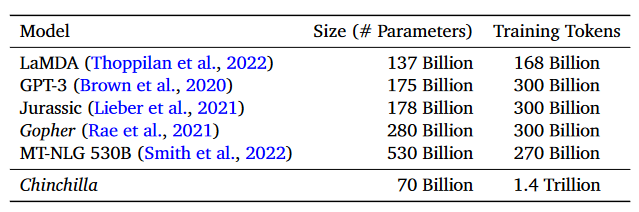
출처: Training Compute-Optimal Large Language Models (Hoffmann 외, 2022)
실제로는 친칠라 법칙보다 더 많이 학습
- 친칠라의 질문: 정해진 학습 예산으로 모델을 얼마나 크게 만들고 얼마나 학습해야 좋을까?
- 정해진 예산에서 모델이 너무 크거나 너무 작으면 모두 손해이며, 손실이 가장 낮은 균형점이 존재
- 서비스의 질문: 이 모델로 앞으로 수백만 번 답변한다면 총비용은 얼마나 들까?
- 모델을 준비하는 학습 비용과 요청마다 답변을 생성하는 추론 비용을 함께 고려
- 학습에 비용을 더 들이더라도 반복 실행에서 비용을 절약하면 총비용은 낮아질 수 있음
- 비교의 전제: 같은 업무에서 필요한 성능을 두 방식 모두 달성할 수 있다고 가정
| 학습 방식 | 모델을 준비할 때 | 서비스에서 반복 실행할 때 |
|---|---|---|
| 친칠라 기준에 맞춰 학습 | 필요한 성능에 도달하는 학습 비용이 더 낮을 수 있음 | 모델이 커서 요청마다 실행 비용 부담 |
| 작은 모델을 더 오래 학습 | 필요한 성능에 도달하기 위해 학습 비용을 더 쓸 수 있음 | 모델이 작아 요청마다 실행 비용 절약 가능 |
- 실제 학습 사례
- 왼쪽: 여러 SLM은 빨간 선으로 표시한 친칠라 기준(파라미터당 약 20토큰)보다 훨씬 많은 토큰으로 학습
- 예: Phi-3-mini는 3.8B 파라미터를 3.3T 토큰으로 학습해 파라미터당 약 870토큰으로, 친칠라 기준의 40배 이상
- 오른쪽: 학습 토큰 수와 평균 정확도의 관계, 색상은 파라미터 수
- 학습 토큰이 많은 모델일수록 평균 정확도가 높은 경향
- 왼쪽: 여러 SLM은 빨간 선으로 표시한 친칠라 기준(파라미터당 약 20토큰)보다 훨씬 많은 토큰으로 학습
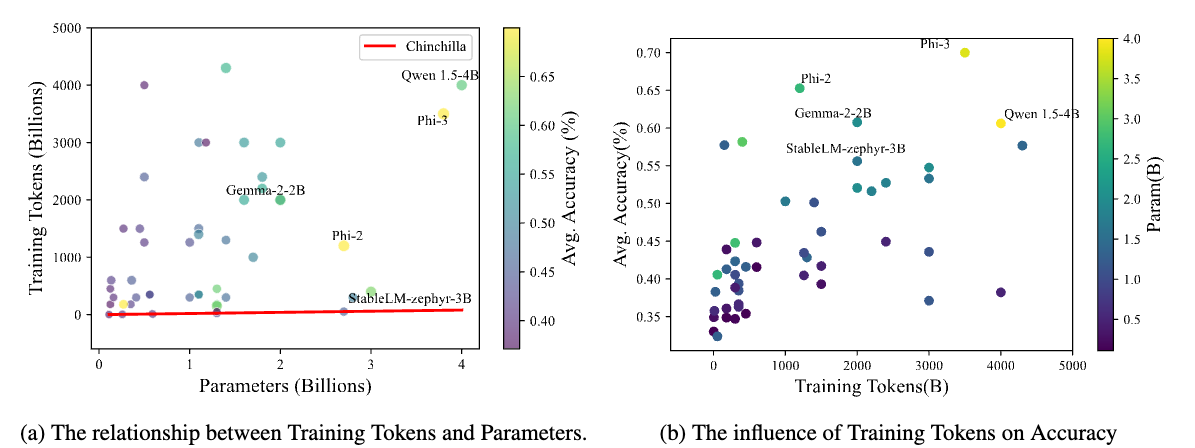
그림 출처: Lu 외 (2024)
SLM과 LLM의 비교
- 일부 SLM은 특정 평가에서 이전 세대의 더 큰 모델에 근접하거나 상회
- 아래 그림: Phi-3, Phi-3.5 등 수 B 규모 모델이 Llama 7B급 모델의 점수(파란 점선)에 근접하거나 상회
- 성능 발전의 배경: 충분한 학습량과 함께 데이터 선별·혼합, 지식 증류, 후학습을 활용
- 지식 증류: 더 강한 모델의 출력이나 예측 분포를 학습 신호로 활용
- 후학습: 기본 학습 뒤에 지시 따르기와 과제 수행 능력을 추가 학습
- 최근 사례: 개발진의 평가에서 Gemma 3 4B-IT가 Gemma 2 27B-IT와 경쟁력 있는 성능을 보고
- IT: 지시 따르기를 추가 학습한 모델(instruction-tuned)
- Gemma 3는 증류와 후학습을 활용해 성능 개선
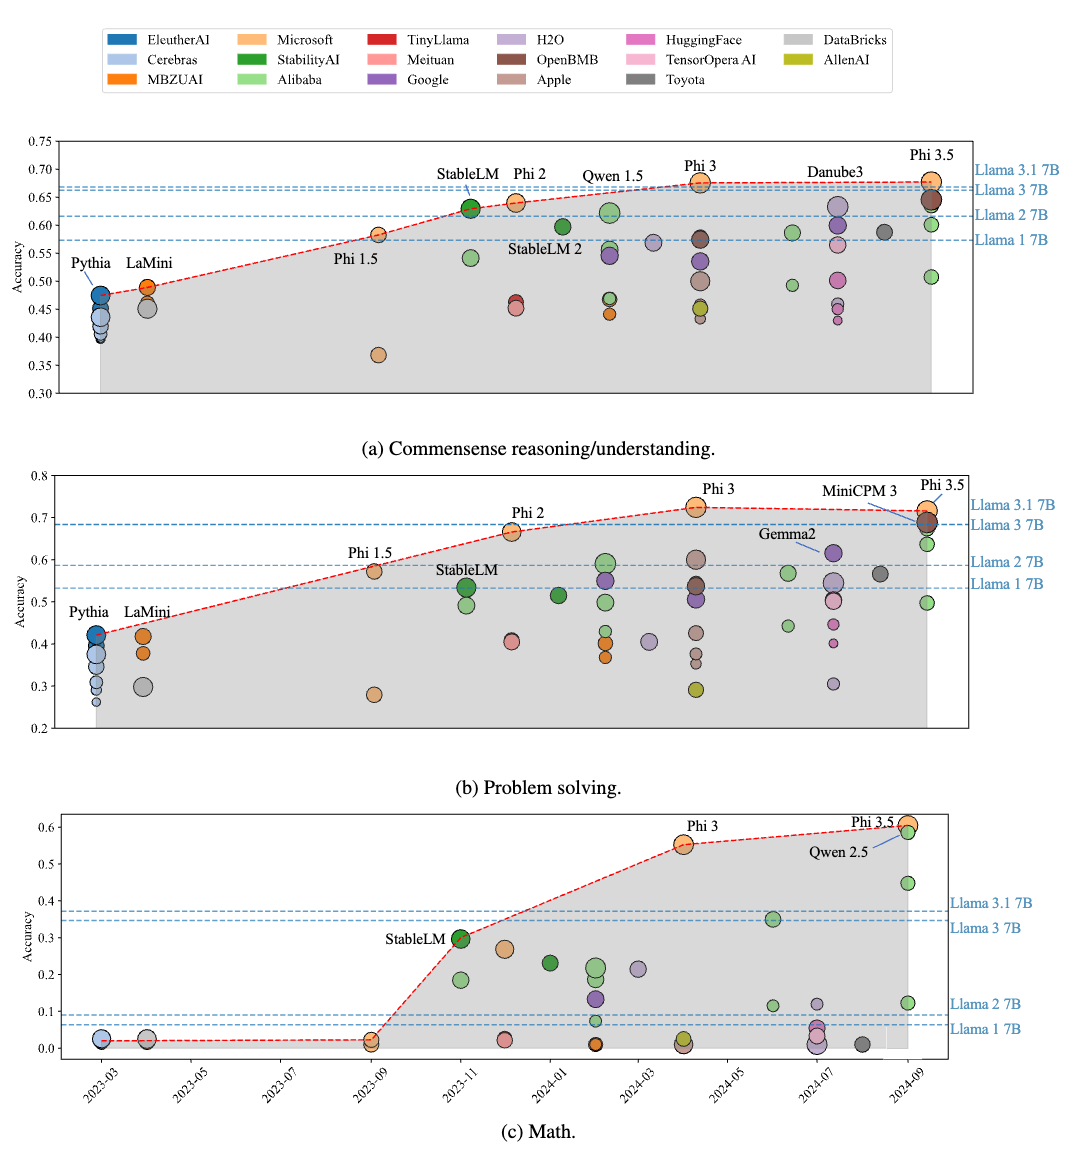
출처: Lu 외 (2024), Gemma 3 Technical Report (2025)
SLM을 고르는 기준
- 업무 성능: 공개 벤치마크보다 실제 업무 데이터로 정확도를 확인
- 위 그림처럼 상식 추론, 문제 해결, 수학 등 평가 영역에 따라 모델의 순위가 달라짐
- 한 평가에서 큰 모델을 앞섰다고 다른 업무에서도 같다는 보장은 없음
- 실행 효율: 실제로 사용할 장비에서 응답 속도와 메모리 사용량을 측정
- 파라미터 수가 비슷해도 구조와 실행 환경에 따라 속도·메모리가 달라질 수 있음
- 두 기준을 함께 고려: 업무에 필요한 성능을 내는 모델 중에서 실행 비용이 가장 낮은 모델을 선택
퀴즈
친칠라 법칙이 찾으려는 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.