합성 데이터와 모형 붕괴
합성 데이터의 활용 사례와 모형 붕괴의 원인, 원본 보존과 검증을 통한 활용 조건
공개 텍스트 데이터의 한계
- 데이터 확보의 한계: 학습 데이터 수요가 사용 가능한 공개 인간 작성 텍스트의 규모에 접근할 가능성
- 2024년 연구: 당시의 발전 추세가 지속될 경우 2026-2032년에 비슷한 규모에 도달할 것으로 전망
- 새로운 글이 사라진다는 뜻이 아니라, 기존 공개 텍스트를 더 많이 모으는 방식만으로 학습 규모를 늘리기 어려워질 가능성
- 그림의 해석: 공개 텍스트의 추정량과 모형 학습에 필요한 데이터 규모를 비교한 조건부 전망
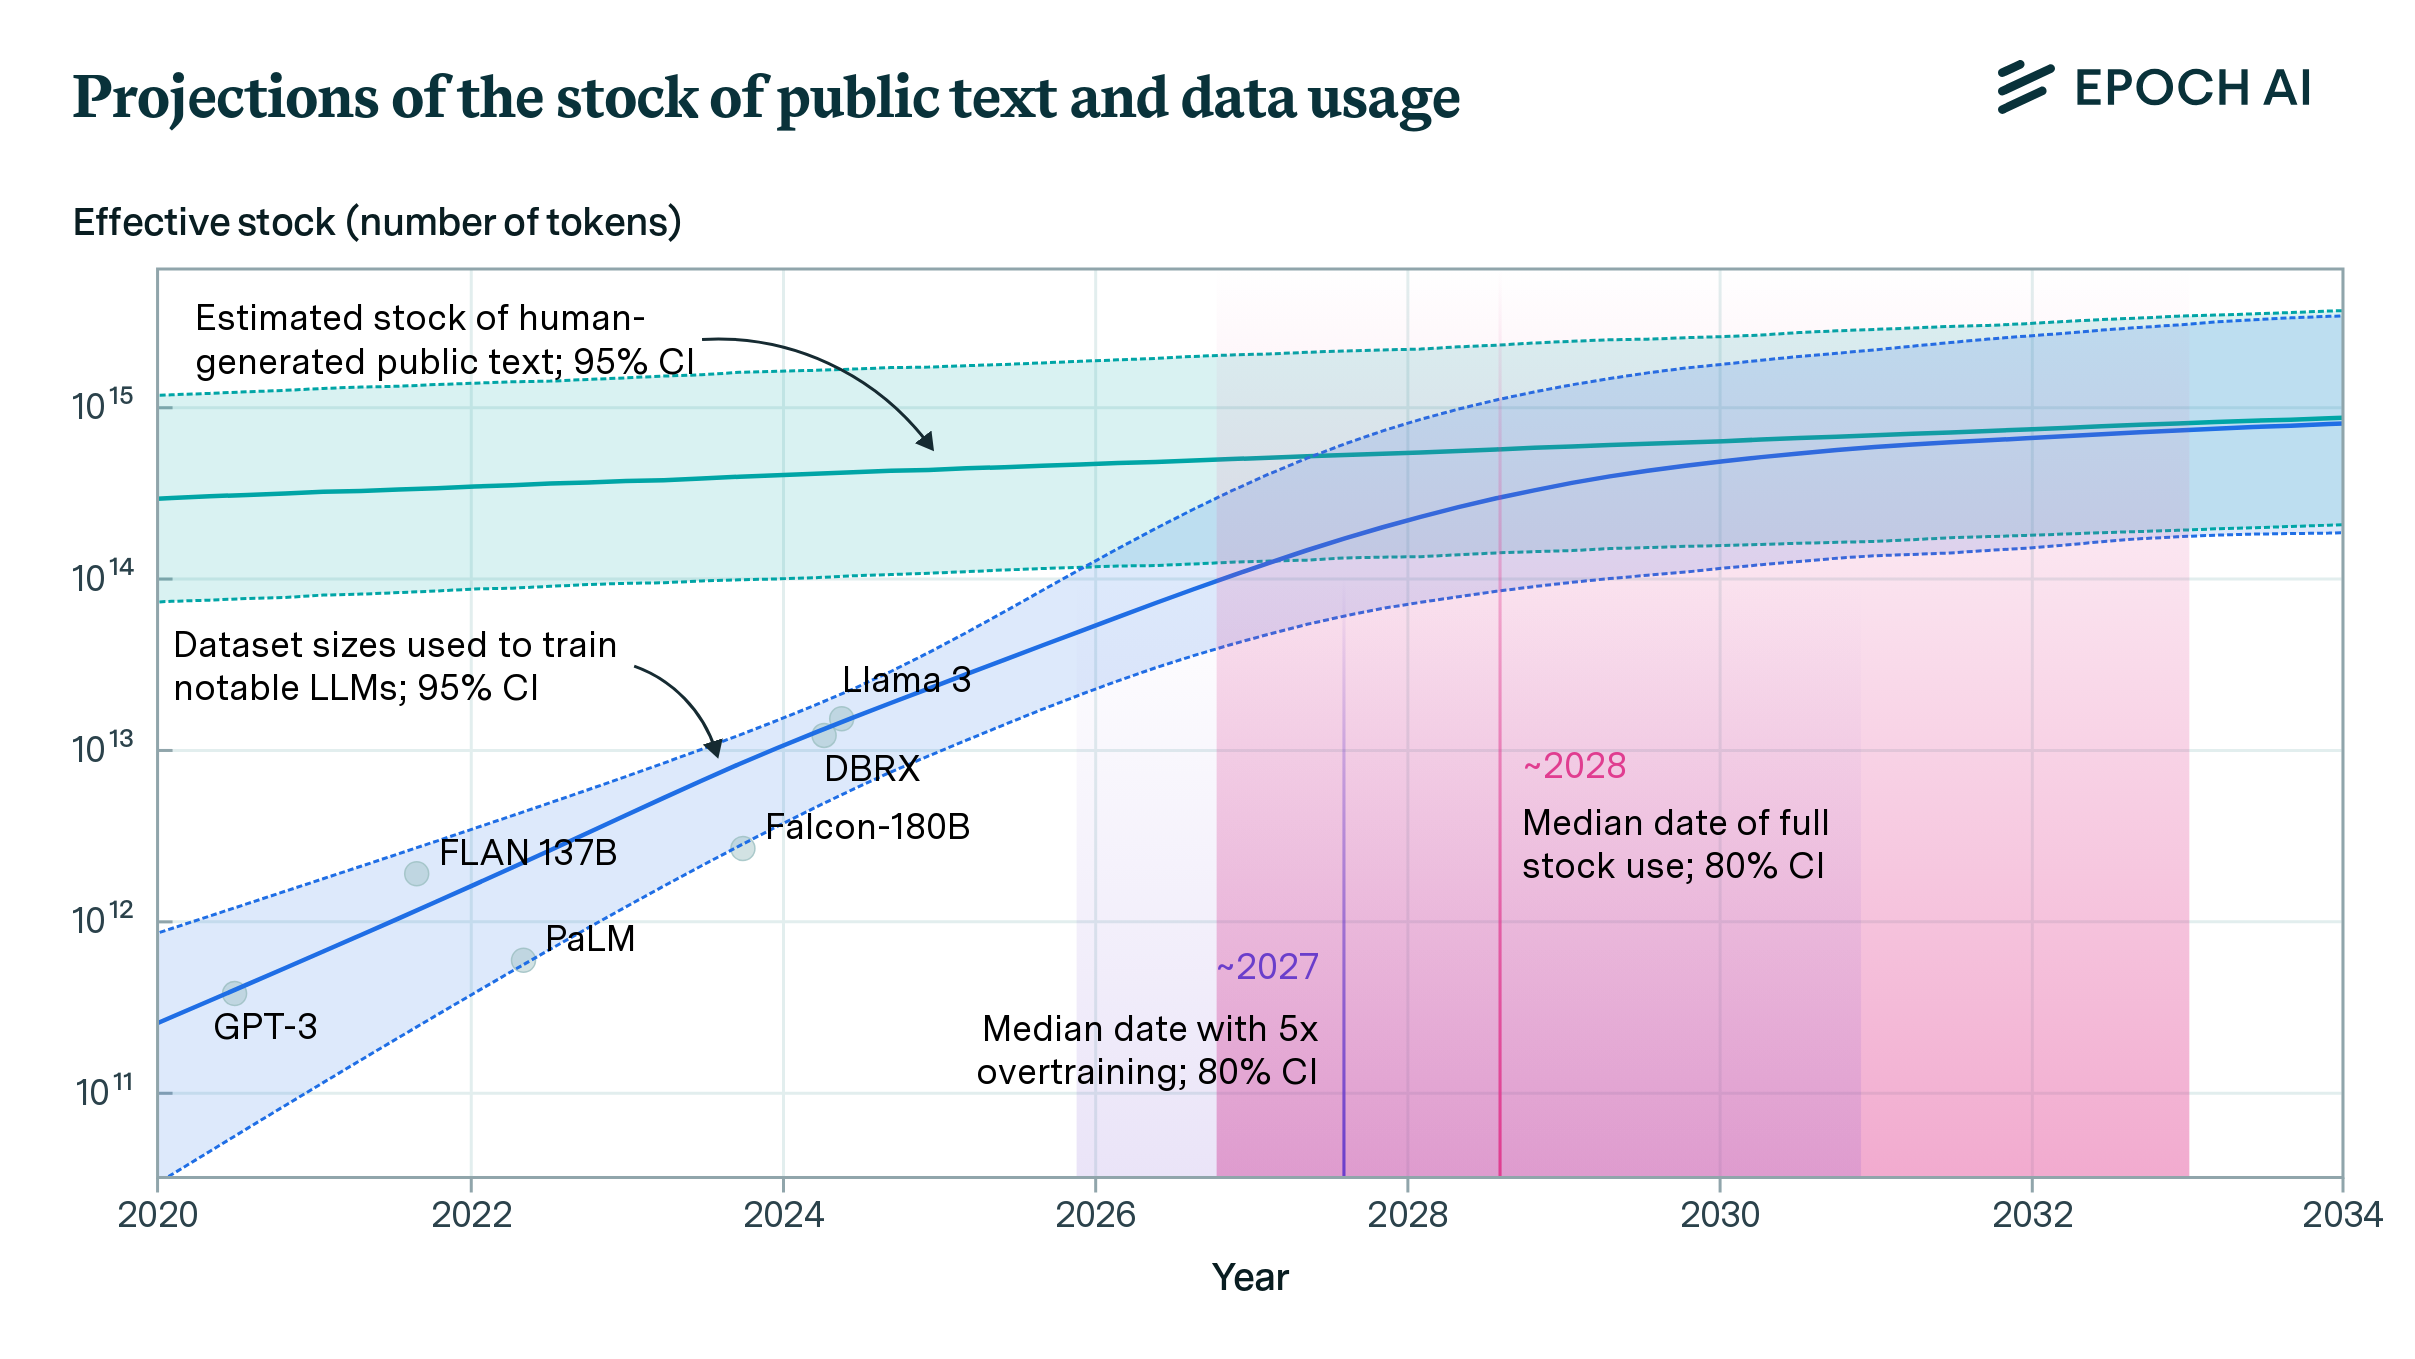
출처: Will we run out of data? Limits of LLM scaling based on human-generated data (Villalobos 외, 2024 개정)
합성 데이터
- 합성 데이터: 모형이나 프로그램으로 생성한 학습 예시
- 사람이 직접 작성한 예시가 부족한 유형과 난이도의 데이터를 보충
- 수학 문제와 풀이, 코드와 테스트 등 학습 목적에 맞춘 데이터 생성
- Xwin-Math: GPT-4로 생성한 수학 데이터를 이용해 더 작은 언어 모형을 학습
- 일부 수학 벤치마크에서 초기 GPT-4에 근접하거나 상회한 사례
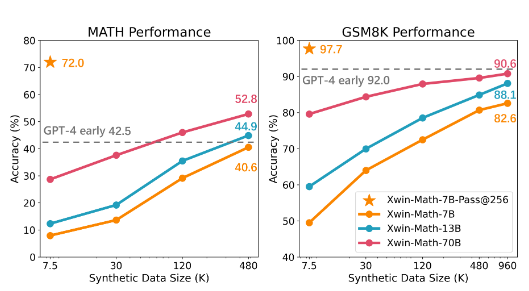
출처: Common 7B Language Models Already Possess Strong Math Capabilities (Li 외, 2024)
- 딥마인드의 AlphaGeometry: 무작위 기하 도형에서 관계와 증명을 도출해 약 1억 개의 학습 예시 생성
- 언어 모형의 보조선 제안과 기호 추론 엔진을 결합해 문제 해결
- 올림피아드 기하 문제 30개 중 25개 해결
- 해당 평가에서 금메달 수상자의 평균인 25.9개에 근접
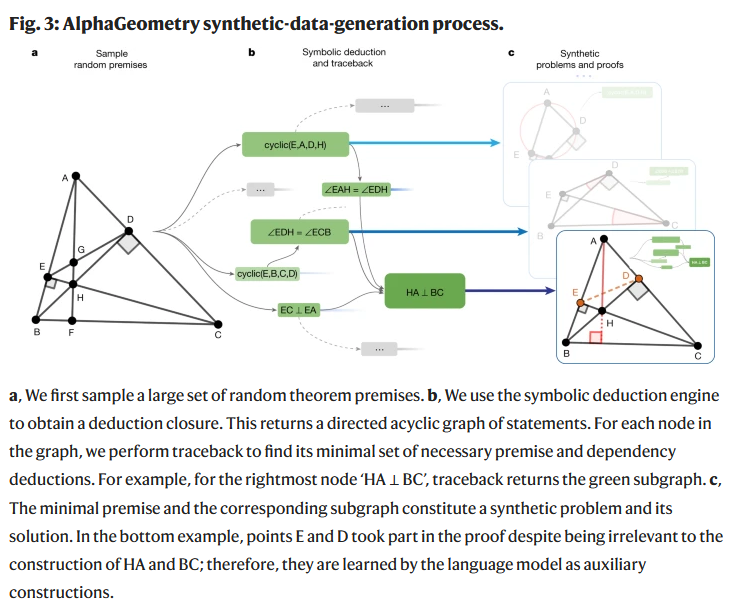
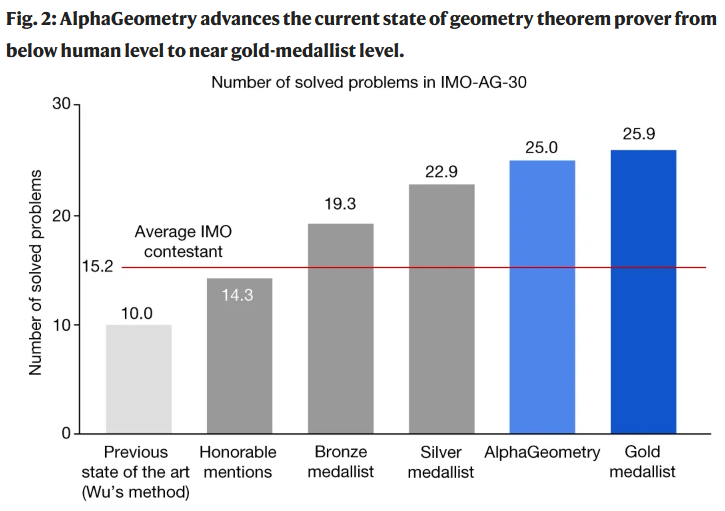
출처: Solving olympiad geometry without human demonstrations (Trinh 외, 2024)
모형 붕괴
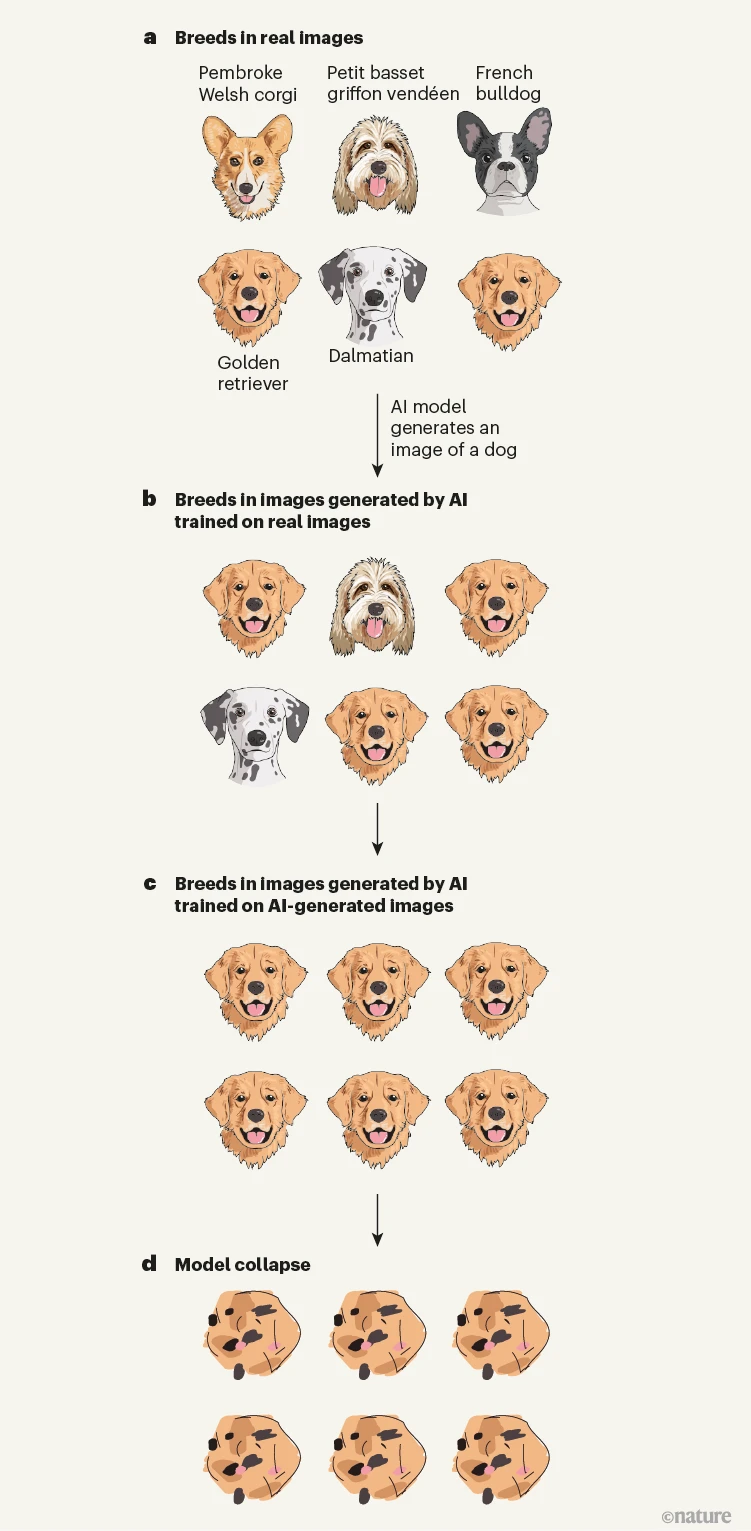
- 모형 붕괴(model collapse): 이전 세대의 생성 데이터로 다음 세대를 반복 학습하면서 원본 분포의 정보가 손실되는 현상
- 특히 원본 데이터를 보존하지 않고 각 세대의 생성 데이터로 대체하는 조건에서 관찰
- 드문 사례가 사라지고 생성 결과의 다양성과 실제 데이터에 대한 성능이 저하될 수 있음
- 원인: 데이터 생성과 학습의 오차가 세대를 거치며 누적
- 유한한 수의 예시를 생성하는 과정에서 확률이 낮은 사례가 누락
- 모형이 원본 분포를 완벽하게 표현하지 못해 정보가 상실
- 이전 세대의 오류까지 다음 세대의 학습 자료에 포함
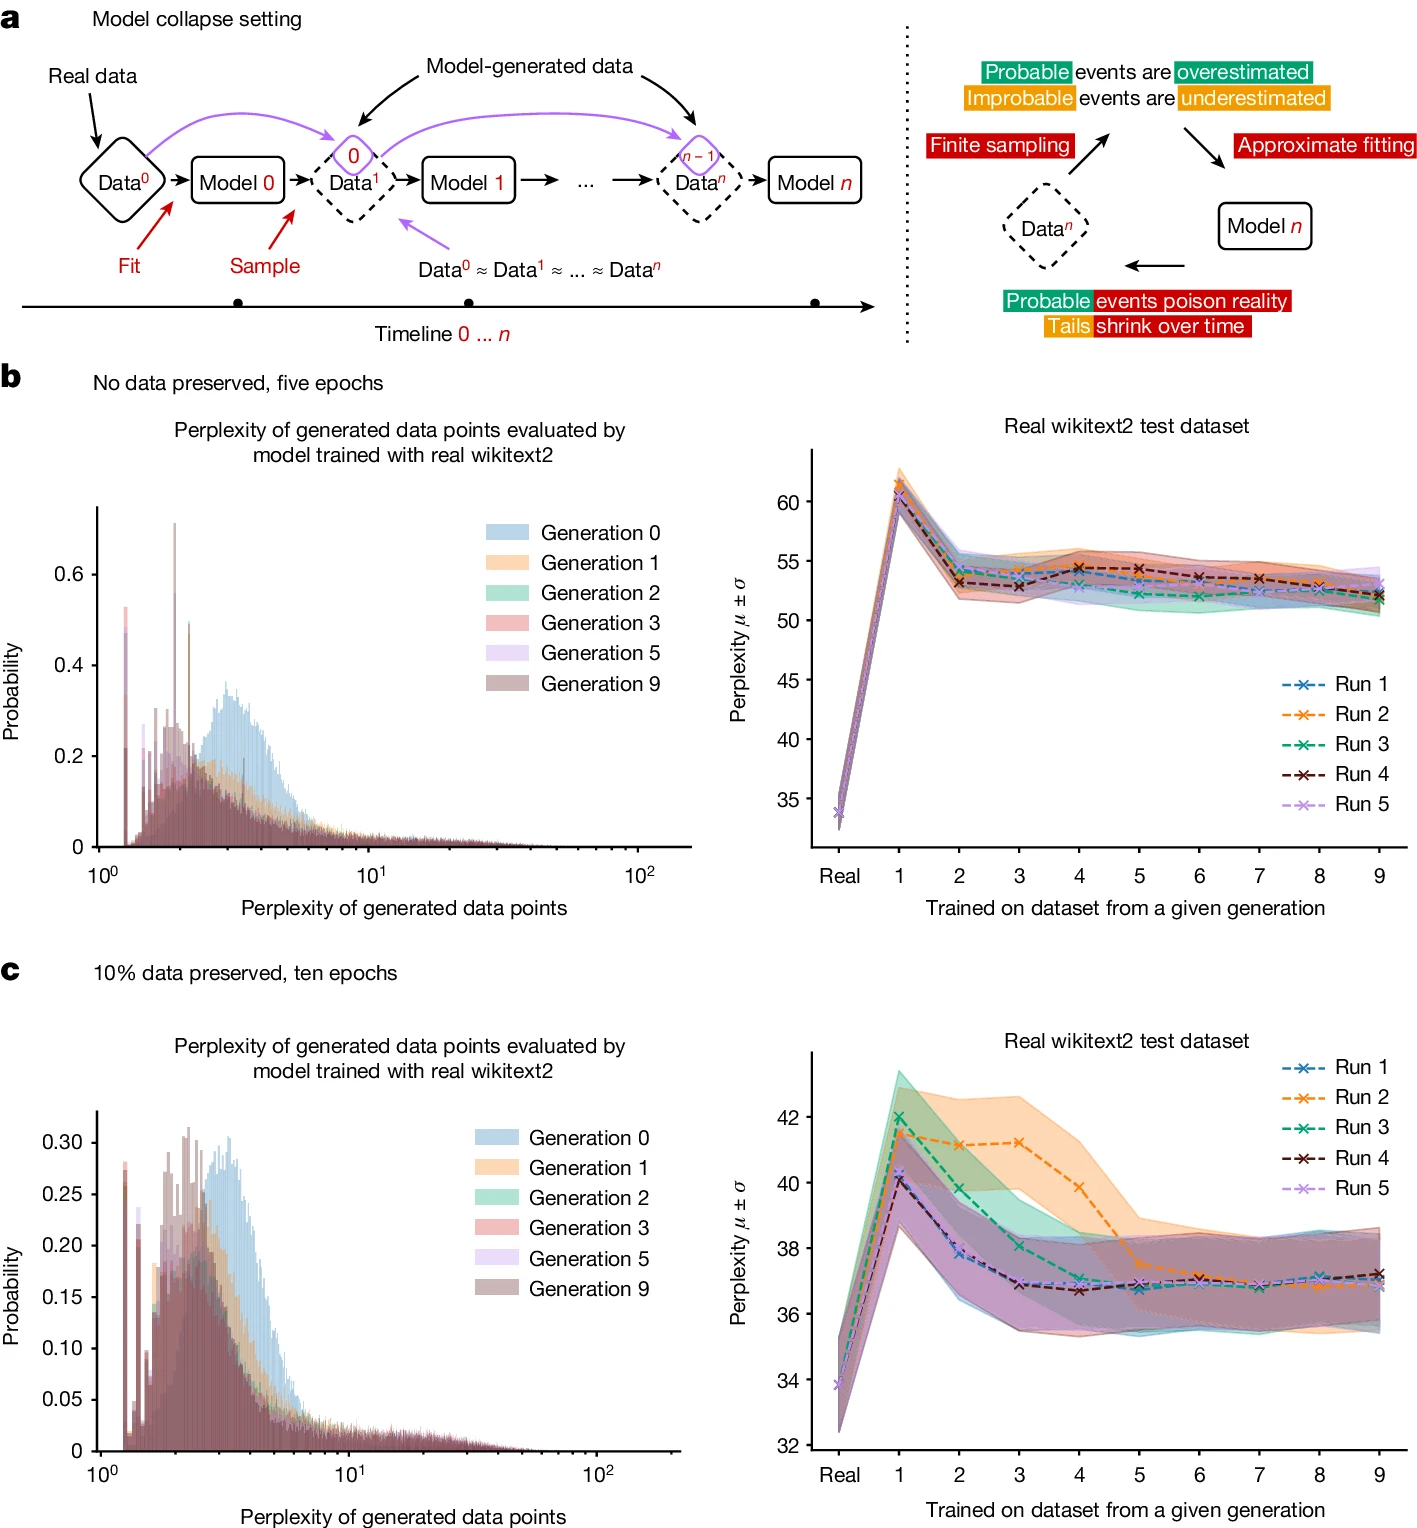
- 혼란도(perplexity): 평가하는 모형이 주어진 문장을 얼마나 예측하기 어려워하는지 나타내는 지표
- 낮을수록 해당 모형이 예측하기 쉬운 문장
- [b왼쪽] 원본 데이터로 학습한 기준 모형이 각 세대의 생성 문장을 평가
- 세대가 진행되며 기준 모형이 쉽게 예측하는 문장에 더 몰리는 경향
- 동시에 일부는 높은 혼란도 쪽으로 길게 퍼지며 오류 누적도 관찰
- [b오른쪽] 각 세대 모형이 실제 시험 데이터를 평가
- 원본으로 학습한 모형보다 혼란도가 높아져 실제 데이터에 대한 예측 성능 저하
- [c] 원본 데이터의 10%를 매 세대 학습에 보존한 실험에서는 성능 저하 완화
출처: AI models collapse when trained on recursively generated data (Shumailov 외, 2024)
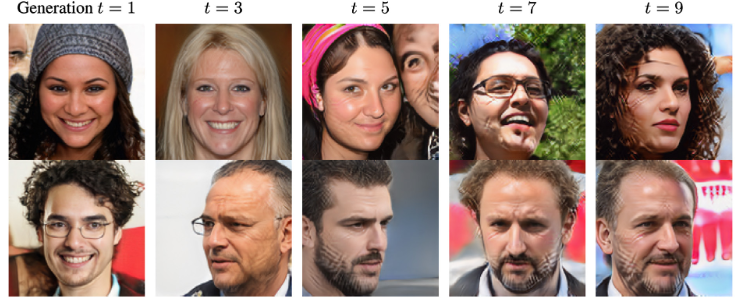
모형 붕괴 예시
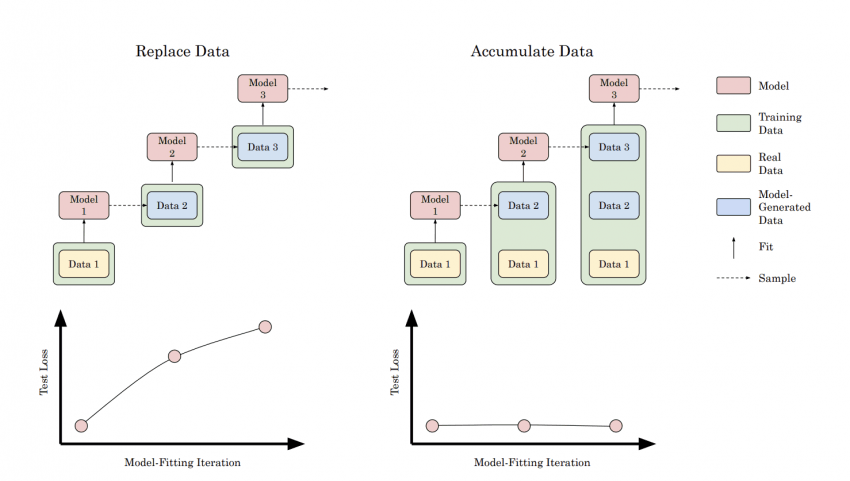
모형 붕괴는 피할 수 없는가?
- 원본 데이터를 각 세대의 합성 데이터로 대체한 실험
- 세대가 진행될수록 성능이 나빠지고 손실이 증가하는 경향
- 원본 데이터를 보존하면서 각 세대의 합성 데이터를 누적한 실험
- 모형 붕괴를 피하고 성능이 안정되거나 개선되는 결과
- 합성 데이터 사용 여부뿐 아니라 원본 보존과 데이터 구성 방식이 중요
합성 데이터를 잘 활용하려면?
- 원본 보존: 실제 데이터와 그 출처를 유지해 생성 과정에서 사라지는 정보를 보완
- 정확성 검증: 생성한 예시를 그대로 쓰지 않고 오류를 걸러내기
- 코드 실행과 테스트, 수학의 정답·증명 검사, 사람의 검토 등 활용
- 검증기로 합성 데이터를 선별해 모형 붕괴를 방지한 연구 사례
- 다양성 확보: 비슷한 쉬운 예시만 늘리지 않고 드문 사례와 다양한 난이도도 포함
- 정답인 예시라도 같은 유형에 몰리면 학습에 필요한 범위를 충분히 다루지 못할 수 있음
- 효과 확인: 생성과 선별에 사용하지 않은 실제 평가 데이터로 학습 전후 성능 비교
- 전체 점수와 함께 드문 사례에서의 오류도 확인
출처: Beyond Model Collapse: Scaling Up with Synthesized Data Requires Verification (Feng 외, ICLR 2025), On the Diversity of Synthetic Data and its Impact on Training Large Language Models (Chen 외, 2024)
퀴즈
합성 데이터를 활용하는 이유로 가장 가까운 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.