
비율의 비교
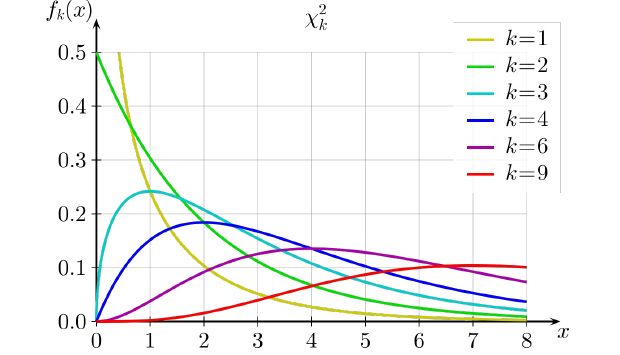
카이제곱 분포
- 서로 독립이고 정규분포 N(μ,σ2)을 따르는 확률변수 Xi를 표준화하면
- 서로 독립인 Zi의 개수 ν를 자유도(degree of freedom)라고 부름
- Zi를 모두 제곱하여 더한 χ2은 자유도가 ν인 카이제곱분포를 따름
- χ는 그리스 문자 "카이"
기대빈도와 관찰빈도
- 귀무가설이 참이면 관찰빈도 O는 기대빈도 E 주변에서 변동
- 기대빈도가 충분히 크면 다음 값으로 관찰빈도와 기대빈도의 차이를 표준화
- 각 범주의 표준화된 차이를 제곱하여 더하면 근사적인 카이제곱 통계량을 얻음
- 이 통계량을 이용해 관찰빈도가 기대빈도에서 얼마나 벗어났는지 검정할 수 있음
카이제곱 적합도 검정
- 카이제곱 적합도 검정(chi-square test for goodness of fit)은 표본에서 얻은 분포가 귀무가설에서 가정하는 모집단 분포와 잘 맞는지 알아보기 위해 사용
- 귀무가설: 모집단의 비율은 기대빈도의 비율과 같음
- 예: 브랜드 선호도
- 50명을 설문했을 때 A 브랜드 31명(62%), B 브랜드 19명(38%)이면 A 브랜드의 선호도가 통계적으로 유의하게 높은가?
- 100명을 설문했을 때 A 브랜드 62명(62%), B 브랜드 38명(38%)이면 A 브랜드의 선호도가 통계적으로 유의하게 높은가?
Python 카이제곱 적합도 검정
from scipy.stats import chisquare

chisquare([31, 19], [25, 25])
# statistic=2.88, pvalue=0.0897

chisquare([62, 38], [50, 50])
# statistic=5.76, pvalue=0.0164
- 귀무가설: 모집단에서 두 브랜드의 선호도는 50%:50%로 같음
chisquare에 관찰빈도와 기대빈도 순으로 입력- 결과로 카이제곱값과 p-value가 출력됨
- 50명 조사: p-value가 0.05보다 크므로 귀무가설 기각 실패
- 100명 조사: p-value가 0.05보다 작으므로 귀무가설 기각
- 같은 비율 차이도 표본이 커지면 발견하기 쉬움
분할표
- 분할표(contingency table)는 행과 열이 서로 다른 범주형 변수의 값을 나타내는 표
- 교차표(cross table) 또는 피봇 테이블(pivot table)이라고도 함
- 표의 각 칸에는 사례 수를 표기
import pandas as pd

hr = pd.read_excel("hr.xlsx")
hr.pivot_table(index="marriage", columns="department", aggfunc="size")
| marriage | Engineering | Finance | Sales |
|---|---|---|---|
| married | 462 | 36 | 209 |
| single | 499 | 27 | 237 |
카이제곱 독립성 검정
- 카이제곱 독립성 검정(chi-square test for independence)은 두 범주형 변수 사이에 관계가 있는지 알아보기 위해 사용
- 귀무가설: 두 변수가 독립적임, 즉 관계가 없음
- 예시
- 남녀 간의 브랜드 선호도 차이
- 지역별 정당 지지율 차이
- 혈액형과 성격유형의 관계
- 기대빈도가 작으면 카이제곱 근사가 부정확할 수 있음
- 기대빈도 5 이상인 셀이 전체의 80% 이상
- 기대빈도 1 미만인 셀은 없어야 함
- Cramér's V는 두 변수의 관계를 0부터 1까지로 표시
- 0: 전혀 관련이 없음
- 1: 완전히 일치
카이제곱 검정 순서도
Mermaid 다이어그램 원문
flowchart TD
    A["귀무가설<br/>두 변수는 연관성이 없다"] --> B{"p < α<br/>(보통 0.05)"}
    B -- "예" --> C["통계적으로 유의한 관계가 있다<br/>두 변수는 연관성이 있다"]
    B -- "아니요" --> D["통계적으로 유의한 관계가 없다<br/>결론을 유보"]
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
Python 카이제곱 독립성 검정
import pingouin as pg

expected, observed, stats = pg.chi2_independence(
    x="marriage",
    y="department",
    data=hr,
)
expected
| marriage | Engineering | Finance | Sales |
|---|---|---|---|
| married | 462.195238 | 30.3 | 214.504762 |
| single | 498.804762 | 32.7 | 231.495238 |
observed
stats
| test | lambda | chi2 | dof | pval | cramer | power |
|---|---|---|---|---|---|---|
| pearson | 1.000000 | 2.338180 | 2.0 | 0.310650 | 0.039882 | 0.257948 |
| cressie-read | 0.666667 | 2.337586 | 2.0 | 0.310742 | 0.039877 | 0.257891 |
| log-likelihood | 0.000000 | 2.340188 | 2.0 | 0.310338 | 0.039899 | 0.258141 |
| freeman-tukey | -0.500000 | 2.345475 | 2.0 | 0.309518 | 0.039944 | 0.258649 |
| mod-log-likelihood | -1.000000 | 2.353653 | 2.0 | 0.308255 | 0.040014 | 0.259435 |
| neyman | -2.000000 | 2.378838 | 2.0 | 0.304398 | 0.040228 | 0.261856 |
- Pearson 행의
pval이 0.310650으로 0.05보다 크므로 귀무가설을 기각하지 않음 cramer가 약 0.04이므로 두 변수의 관계도 매우 약함
퀴즈
관찰빈도 O와 기대빈도 E로 카이제곱 통계량을 계산하는 식은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.