
한 변수의 분포 시각화
단일 변수의 데이터 분포 파악
- 하나의 변수가 어떤 값들을 가지며, 각 값들이 얼마나 자주 나타나는지 확인
- 데이터가 어느 구간에 몰려 있는지, 비대칭적인지 등을 파악하여 통계적 특징 유추
- 중심 경향치와 변산성 척도를 시각적으로 뒷받침
히스토그램(Histogram)의 이해
- 연속형 데이터의 분포를 나타내는 가장 대표적인 그래프
- 데이터의 범위를 여러 구간(Bin)으로 나누고, 각 구간에 속한 데이터의 빈도수(개수)를 막대 높이로 표현
# 'speed' 열의 히스토그램 시각화
sns.histplot(data=df, x='speed')
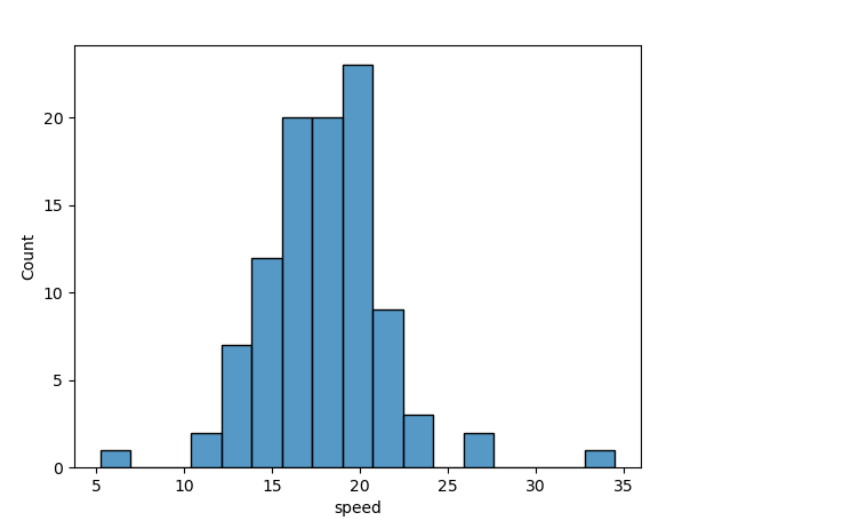
히스토그램 구간(Bin) 설정의 중요성
- 구간(Bin)의 수나 너비에 따라 히스토그램의 모양이 크게 달라질 수 있음
- 구간이 너무 적으면 데이터의 세부적인 특징(패턴)을 놓칠 수 있음
- 구간이 너무 많으면 노이즈가 강조되어 전반적인 분포를 파악하기 어려움
# 구간(bins) 개수를 20개로 지정하여 히스토그램 시각화
sns.histplot(data=df, x='speed', bins=20)
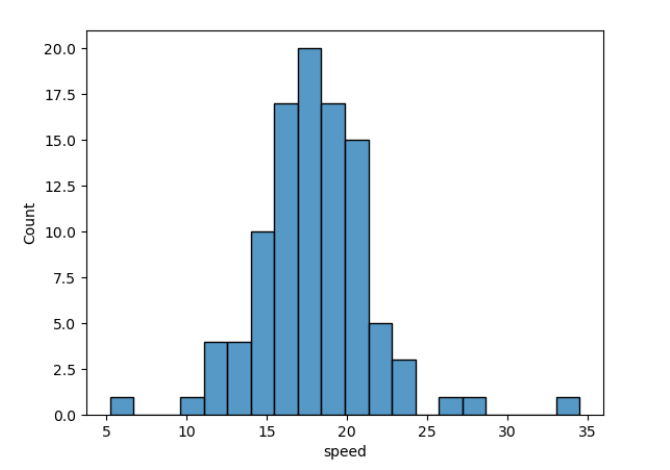
구간 개수와 경계 지정
bins에 정수를 전달하면 히스토그램의 구간 개수를 지정
sns.histplot(data=df, x='speed', bins=30)
bins에 경계값 목록을 전달하면 각 구간의 시작점과 끝점을 직접 지정
sns.histplot(data=df, x='speed', bins=[5, 10, 15, 20, 25, 30, 35])
- 위 코드는 5 이상 10 미만, 10 이상 15 미만과 같이 5노트 간격으로 속도를 나누어 비교
KDE
- 커널 밀도 추정(Kernel Density Estimation)의 약자
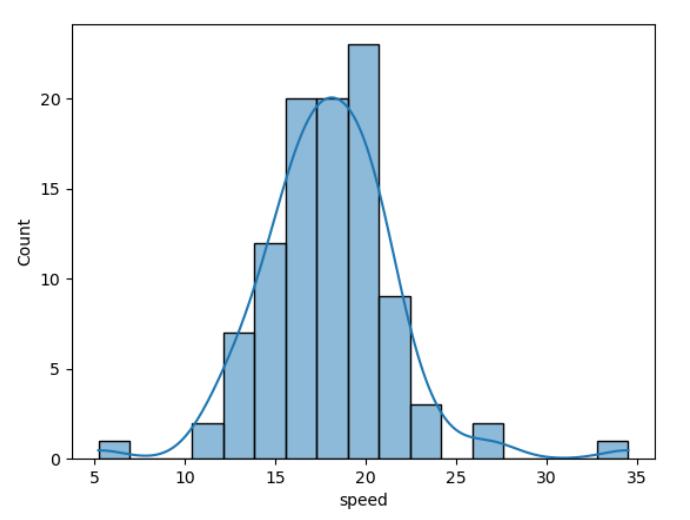
- 히스토그램의 계단식 모양을 부드러운 곡선으로 나타내어 데이터의 확률 밀도를 보여줌
- 각 데이터 점 주변에 커널 함수를 씌워 더하는 방식으로, 연속적인 분포 형태를 파악하기 용이함
# 히스토그램과 KDE 곡선을 함께 시각화
sns.histplot(data=df, x='speed', kde=True)
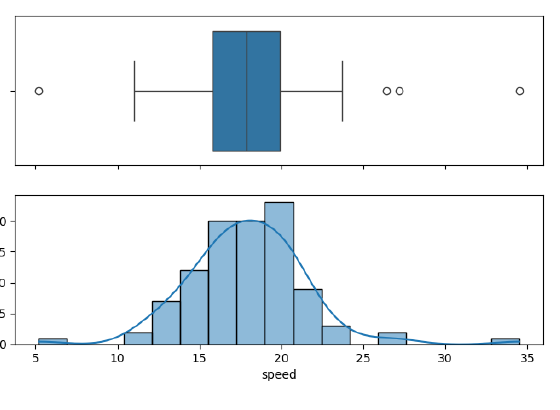
상자 수염 그림(Boxplot)과 히스토그램 비교
- 히스토그램: 전체적인 데이터의 형태와 분포(대칭성 등)를 파악하기 좋음
- 상자 수염 그림: 사분위수에 기반하여 중심 위치와 이상치(outlier)를 식별하는 데 유리함
- 두 그래프를 함께 보여주면 단일 변수의 특성을 보다 명확하게 이해할 수 있음
import matplotlib.pyplot as plt
import seaborn as sns

# 위에는 상자 수염 그림, 아래는 히스토그램 배치
fig, ax = plt.subplots(2, 1, figsize=(8, 5), sharex=True)
sns.boxplot(data=df, x='speed', ax=ax[0])
sns.histplot(data=df, x='speed', kde=True, ax=ax[1])
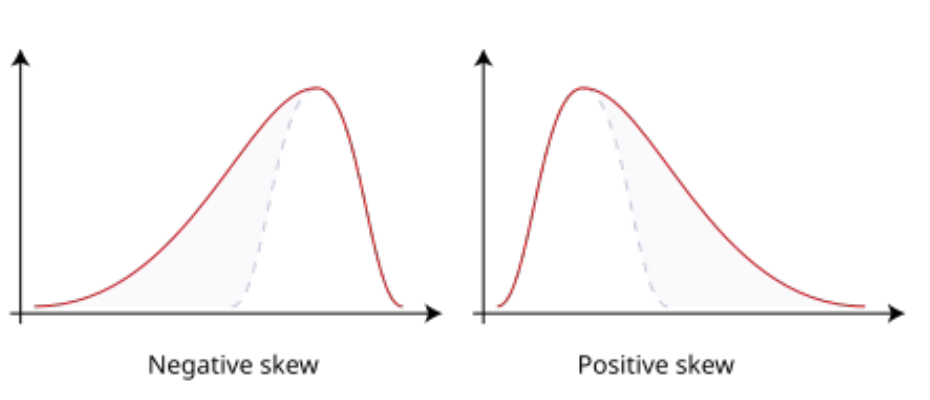
데이터의 비대칭 정도: 왜도(Skewness)
- 데이터 분포가 좌우 대칭에서 벗어나 한쪽으로 치우친 정도를 나타내는 통계량
- 값이 0 근처: 완벽한 혹은 대략적인 좌우 대칭(예: 정규 분포)
- 양수(>0): 오른쪽 꼬리가 길어 큰 값 쪽 이상치 가능성
- 음수(<0): 왼쪽 꼬리가 길어 작은 값 쪽 이상치 가능성
# 'speed' 열의 왜도 계산
df['speed'].skew()
- 실습 데이터의 왜도는 약 0.2869
- 0보다 조금 크므로 대체로 대칭에 가깝지만 오른쪽 꼬리가 약간 긴 분포
데이터의 뾰족한 정도: 첨도(Kurtosis)
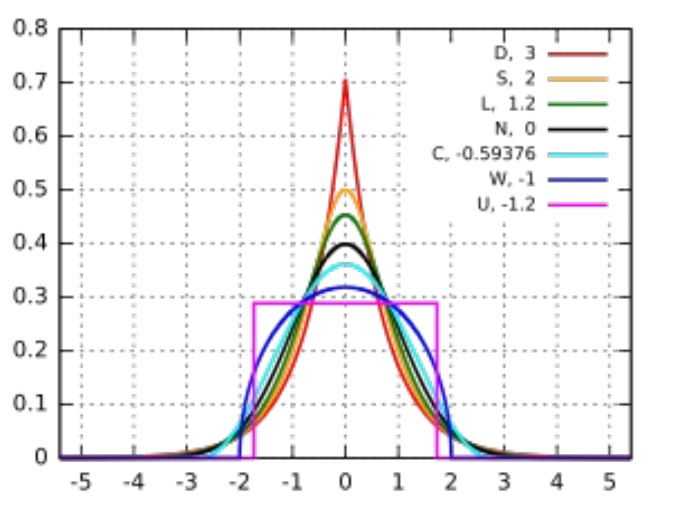
- 데이터의 분포가 중심에 얼마나 뾰족하게 모여 있는지, 혹은 꼬리가 얼마나 두꺼운지를 나타냄
- 초과 첨도: 정규분포의 첨도 3을 빼서 정규분포와 비교
- 양수면 정규분포보다 두꺼운 꼬리를 가지며, 극단적인 값(이상치)의 발생 가능성이 큼
# 'speed' 열의 첨도 계산
df['speed'].kurt()
- pandas의
kurt()는 정규분포를 0으로 놓는 초과 첨도를 계산 - 실습 데이터의 초과 첨도는 약 3.1393으로, 정규분포보다 꼬리가 두껍고 극단적인 값이 나타날 가능성이 큼
퀴즈
단일 변수의 데이터 분포를 살펴보는 주된 목적은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.