군집분석
군집분석이란
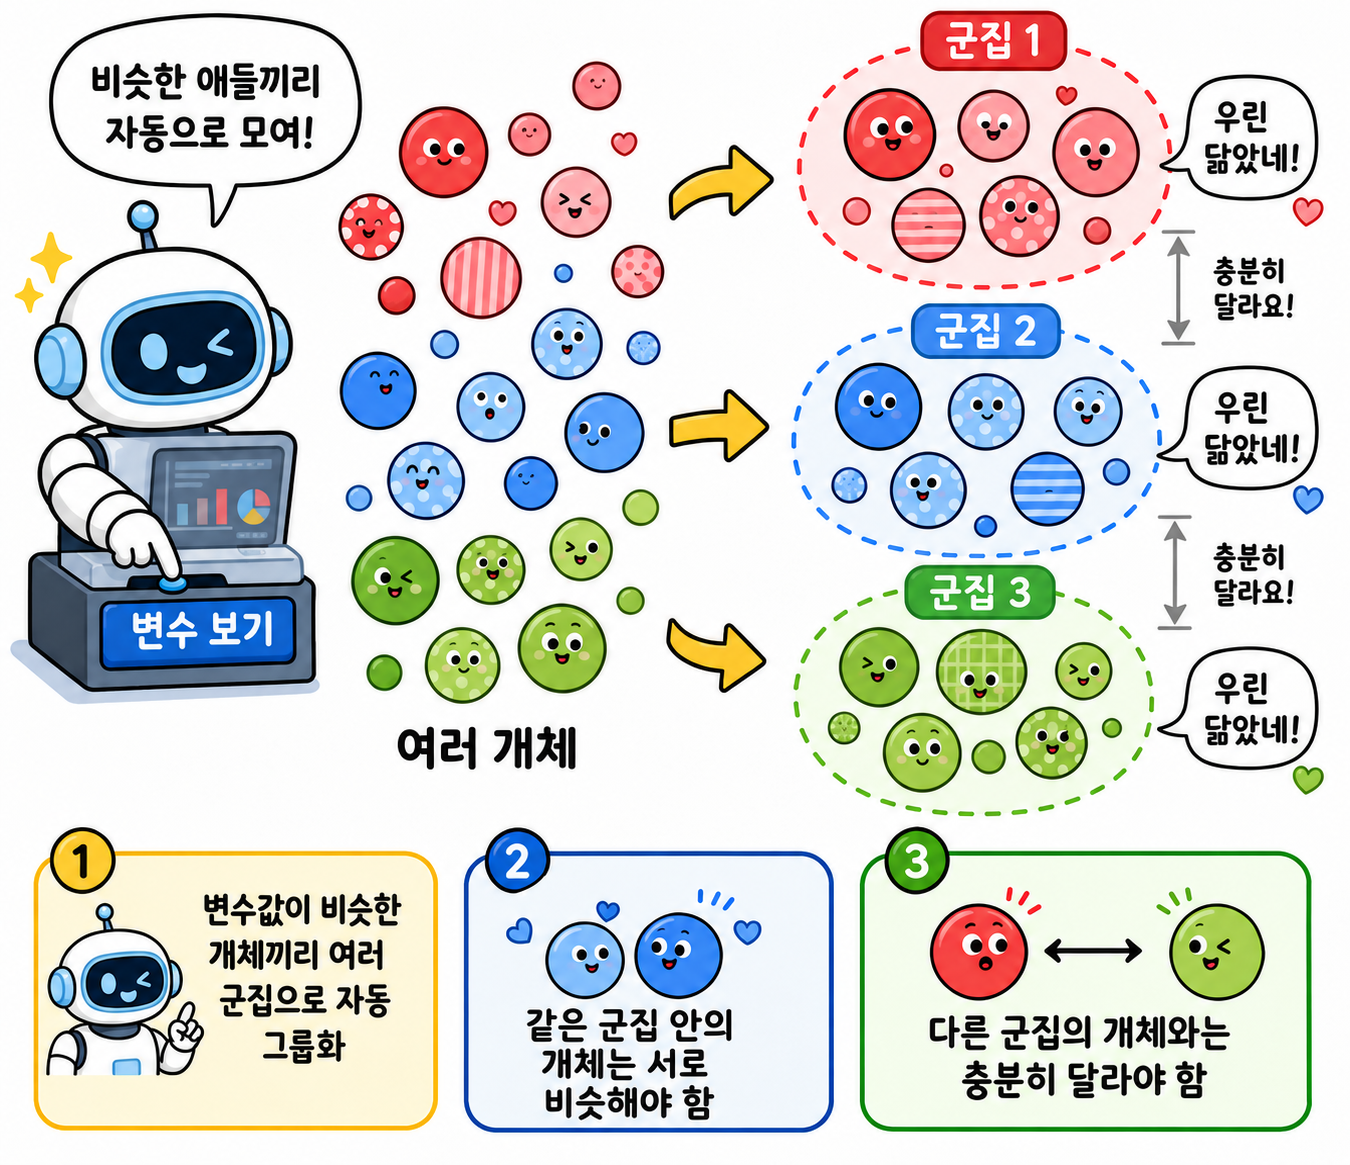
- 군집분석(Clustering): 정답 라벨 없이 비슷한 개체를 묶어 데이터 안의 유형을 발견하는 비지도학습 과제
- 변수값이 비슷한 개체끼리 여러 군집(Cluster)으로 자동 그룹화
- 같은 군집 안의 개체는 서로 비슷해야 함
- 다른 군집의 개체와는 충분히 달라야 함
- 군집에 미리 이름이나 정답이 없으므로, 결과를 보고 사람이 각 군집의 의미를 해석
분류와 군집분석의 차이
- 둘 다 데이터를 여러 집단으로 나누지만, 집단이 미리 주어지는지가 다름
| 분류(Classification) | 군집분석 | |
|---|---|---|
| 학습 방식 | 지도학습 | 비지도학습 |
| 집단 | 미리 정해진 범주(스팸/정상, 재계약/미재계약) | 데이터에서 발견한 군집(1번, 2번, 3번) |
| 데이터 | 각 사례에 정답 범주가 붙어 있음 | 정답 범주가 없음 |
| 목적 | 새로운 사례가 어느 범주인지 맞히기 | 데이터 안에 어떤 유형이 있는지 찾기 |
| 결과의 의미 | 범주의 이름과 뜻이 처음부터 정해져 있음 | 군집은 번호만 있고, 뜻은 사람이 해석 |
| 평가 | 정답과 비교해 정확도 계산 | 정답이 없으므로 군집 내 유사성과 해석 가능성으로 판단 |
- 예: 고객 데이터
- 분류: 과거에 이탈한 고객과 남은 고객의 기록으로 학습해, 새 고객의 이탈 여부를 예측
- 군집분석: 이탈 여부 없이 구매 패턴만으로 고객을 몇 개의 유형으로 나누고, 각 유형의 특징을 해석
- 군집분석으로 찾은 군집에 이름을 붙이고 정답으로 삼으면, 이후에는 분류 문제로 다룰 수 있음
군집분석의 활용
- 공통 질문: "이 데이터 안에는 어떤 유형들이 섞여 있는가?"
- 유형을 알면 유형별로 다른 설명, 다른 대응, 다른 전략이 가능
| 분야 | 활용 예시 |
|---|---|
| 인문학 | 수천 편의 문헌을 주제별로 묶기, 문체 특징으로 작가나 시대 구분, 필사본의 계통 파악 |
| 심리학 | 성격 검사나 증상 척도 프로파일로 하위 유형 발견(예: 우울 증상 패턴의 유형화), 설문 응답 패턴으로 참가자 집단 구분 |
| 사회학 | 사회경제 지표로 지역이나 동네를 유형화, 온라인 네트워크에서 커뮤니티 탐지, 생활시간 조사로 생활양식 유형 도출 |
| 경제학 | 경제 지표로 국가나 산업을 그룹화, 주가 변동 패턴이 비슷한 종목 묶기(포트폴리오 분산), 가계의 소비 패턴 유형화 |
| 경영 | 직원의 역량과 몰입도 프로파일로 인재 유형 구분, 거래처를 거래 규모와 빈도로 세분화, 매장을 입지와 매출 구조로 유형화 |
| 마케팅 | 구매 금액, 빈도, 최근성(RFM)으로 고객 세분화, 비슷한 취향의 사용자를 묶어 상품 추천, 페르소나 도출 |
| 제조 | 공정 센서 데이터로 정상 운전 상태의 유형 파악, 불량품을 결함 패턴별로 그룹화, 어느 군집에도 속하지 않는 설비 이상 감지 |
| 엔지니어링 | 진동이나 전력 신호의 패턴 유형화, 교통 흐름을 시간대별 유형으로 구분, 이미지의 색상을 소수의 대표색으로 압축 |
| 의료 | 유전자 발현 패턴으로 질병의 아형 구분, 비슷한 경과를 보이는 환자 집단 발견 |
| 교육 | 학습 로그로 학습자 유형 구분, 유형별 맞춤 피드백 설계 |
- 어떤 분야든 절차는 같음: 비교할 변수 선택 → 군집분석 → 각 군집의 특징 해석 → 유형별 대응
군집분석의 종류
- "무엇을 군집으로 볼 것인가"라는 기준에 따라 크게 세 가지 접근으로 나뉨
| 접근 | 군집의 기준 | 대표 알고리즘 | 군집 개수 |
|---|---|---|---|
| 중심 기반 | 같은 중심점에 가까운 점들이 한 군집 | K-Means | 미리 지정 |
| 연결 기반 | 가까운 점끼리 차례로 이어 붙인 것이 한 군집 | 계층적 군집분석(Agglomerative) | 나중에 결정 |
| 밀도 기반 | 점이 빽빽하게 모인 영역이 한 군집 | DBSCAN, HDBSCAN | 자동 결정 |
중심 기반 군집분석
- 기본 아이디어
- 각 군집을 하나의 중심점으로 대표
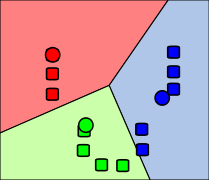
- 군집 개수 k를 정하고, 각 데이터를 가장 가까운 군집 중심에 배정
- 배정 결과로 중심을 다시 계산하는 과정을 반복
- 대표 알고리즘: K-Means (다음 문서에서 실습)
- 결과 표현: 각 데이터가 속한 군집 번호와 군집별 중심점
- 장점
- 단순하고 빠르며 대용량 데이터에도 적용 가능
- 군집 중심을 보면 각 군집의 특징을 해석하기 쉬움
- 단점
- 군집 개수 k를 미리 정해야 함
- 둥근 모양의 군집을 가정하므로 길쭉하거나 복잡한 모양은 잘 못 찾음
- 이상치가 군집 중심을 끌어당겨 결과를 왜곡
연결 기반 군집분석
- 기본 아이디어
- 가까운 점끼리 연결하고, 연결된 것끼리 다시 연결하는 과정을 반복
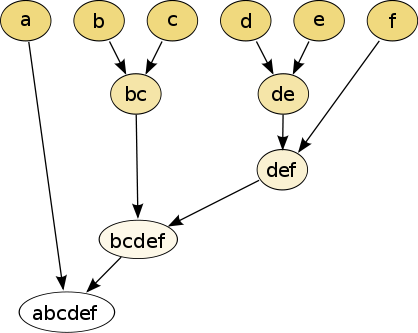
- 연결을 쌓아 가면 자연스럽게 군집의 계층 구조가 만들어지므로 계층적 군집분석(hierarchical clustering)이라고도 부름
- 대표 알고리즘: 병합형 군집분석(Agglomerative Clustering)
- 각 데이터를 하나의 군집으로 시작해 가장 가까운 군집끼리 차례로 합침
- 군집 사이의 거리를 재는 기준(가장 가까운 점, 가장 먼 점, 평균 등)에 따라 결과가 달라짐
- 결과 표현
- 덴드로그램(dendrogram)으로 군집이 합쳐지는 과정을 나무 모양으로 시각화
- 어느 높이에서 자르느냐에 따라 군집 개수가 달라짐
- 장점
- 군집 개수를 처음부터 정하지 않아도 됨
- 큰 군집 안의 작은 군집처럼 계층 구조를 함께 볼 수 있음
- 덴드로그램으로 결과를 직관적으로 설명 가능
- 단점
- 모든 데이터 쌍의 거리를 계산하므로 데이터가 많으면 느림
- 한 번 합친 결정은 되돌리지 않음
밀도 기반 군집분석
- 기본 아이디어
- 가까운 이웃이 충분히 많은 점을 중심으로 군집을 형성
- 밀도가 낮은 지역의 점은 군집에 포함하지 않고 이상치로 봄
- 대표 알고리즘: DBSCAN
- 주요 개념
- 반경: 주변 이웃을 찾는 거리 기준
- 최소 이웃 수: 핵심점(주변에 이웃이 충분히 많은 점)으로 인정되기 위한 최소 데이터 수
- 이상치: 어느 밀집 영역에도 속하지 않는 점
- 장점
- 군집 개수를 미리 정하지 않아도 됨
- 둥근 모양이 아닌 복잡한 형태의 군집도 찾을 수 있음
- 이상치 탐지에 유용
- 단점
- 반경과 최소 이웃 수를 적절히 정해야 하고, 결과가 이 값에 민감
- 군집마다 밀도가 크게 다르면 한 가지 기준으로 모두 찾기 어려움
세 가지 접근의 비교
| 중심 기반 | 연결 기반 | 밀도 기반 | |
|---|---|---|---|
| 군집의 기준 | 중심점까지의 거리 | 가까운 점끼리의 연결 | 점의 밀도 |
| 결과 형태 | 평평한 군집 | 계층 구조(덴드로그램) | 평평한 군집 + 이상치 |
| 군집 개수 | 미리 지정 | 덴드로그램을 보고 결정 | 자동 결정 |
| 군집 모양 | 둥근 모양 가정 | 거리 기준에 따라 다름 | 임의의 모양 |
| 이상치 처리 | 어느 군집에든 배정 | 어느 군집에든 배정 | 이상치로 분리 |
| 속도 | 빠름 | 느림 | 중간 |
| 적합한 상황 | 데이터가 많고 군집 수를 대략 아는 경우 | 계층 구조를 보고 싶은 경우 | 모양이 복잡하거나 이상치가 섞인 경우 |
군집분석의 결과 형태
- 평평한 군집(flat clustering)
- 각 데이터가 하나의 군집 번호를 가짐
- 군집끼리는 대등하고 서로 겹치지 않음
- 중심 기반, 밀도 기반이 주로 이 형태 (밀도 기반은 어느 군집에도 속하지 않는 이상치가 추가됨)
- 계층 구조(hierarchical clustering)
- 큰 군집 안에 작은 군집이 포함되는 나무 구조
- 어느 높이에서 자르느냐에 따라 군집 개수가 달라짐
- 연결 기반이 주로 이 형태
퀴즈
좋은 군집의 기준으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.