차원 축소
차원 축소
- 차원 축소(Dimensionality Reduction): 데이터의 중요한 정보는 최대한 살리면서 변수(차원)의 수를 줄이는 기법
- 예: 학생 성적
- 국어, 영어, 사회, 수학, 물리, 화학 등 과목이 10개 있는 경우
- 국어·영어·사회 점수는 함께 높거나 낮은 경향이 있고, 수학·물리·화학도 마찬가지
- 그렇다면 10개 점수를 "언어 능력", "수리 능력" 두 점수로 요약해도 학생 사이의 차이를 대부분 설명 가능
- 왜 줄이나?
- 시각화: 2개로 줄이면 데이터를 평면 그림으로 볼 수 있음
- 효율과 성능: 변수가 줄면 학습이 빨라지고, 과적합 위험이 줄어듦
- 노이즈 제거: 중요하지 않은 변동을 걸러낼 수 있음
- 주의할 점
- 줄이는 과정에서 정보가 일부 사라짐
- 새로 만든 변수(예: "언어 능력")의 의미가 원래 변수만큼 분명하지 않을 수 있음
차원 축소 방법은 크게 두 갈래로 나눌 수 있다.
| 변수를 요약하기 | 매니폴드 학습 | |
|---|---|---|
| 질문 | 변수 여러 개를 몇 개로 줄일 수 있나? | 비슷한 관측치끼리 가까이 놓을 수 있나? |
| 결과 | 새 변수. 다른 모형의 입력으로도 사용 | 2D 그림. 주로 시각화 용도 |
| 대표 방법 | PCA | t-SNE, UMAP |
주성분 분석
- 주성분 분석(Principal Component Analysis, PCA)
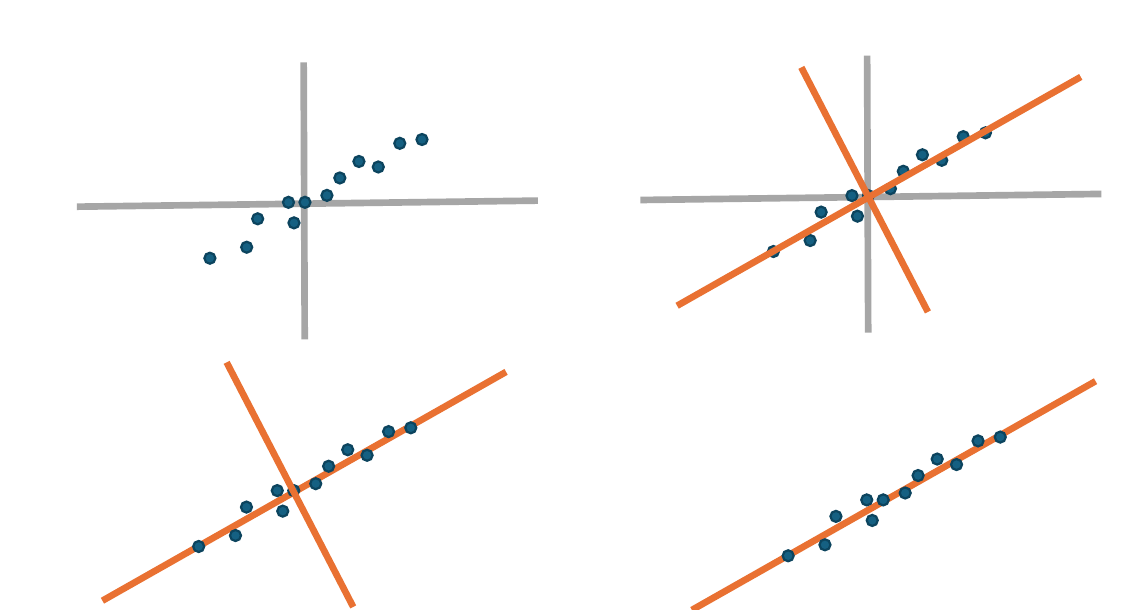
- 여러 변수가 함께 움직이는 방향을 새 축으로 만드는 방법
- 예: 함께 높거나 낮은 국어·영어·사회 점수를 묶어 "언어 능력"이라는 새 변수 하나로 요약
- 차원 축소에서 가장 널리 쓰이는 방법
- 제1주성분(PC1): 데이터가 가장 크게 퍼지는 방향
- 제2주성분(PC2): PC1과 직교하면서 남은 분산을 가장 많이 보존하는 방향
- 원래 변수들을 서로 상관이 없는 새 축으로 바꿔 표현
- 일부 정보 손실은 있지만 설명력으로 손실 정도 확인 가능
다른 성분 분해 방법: ICA, NMF
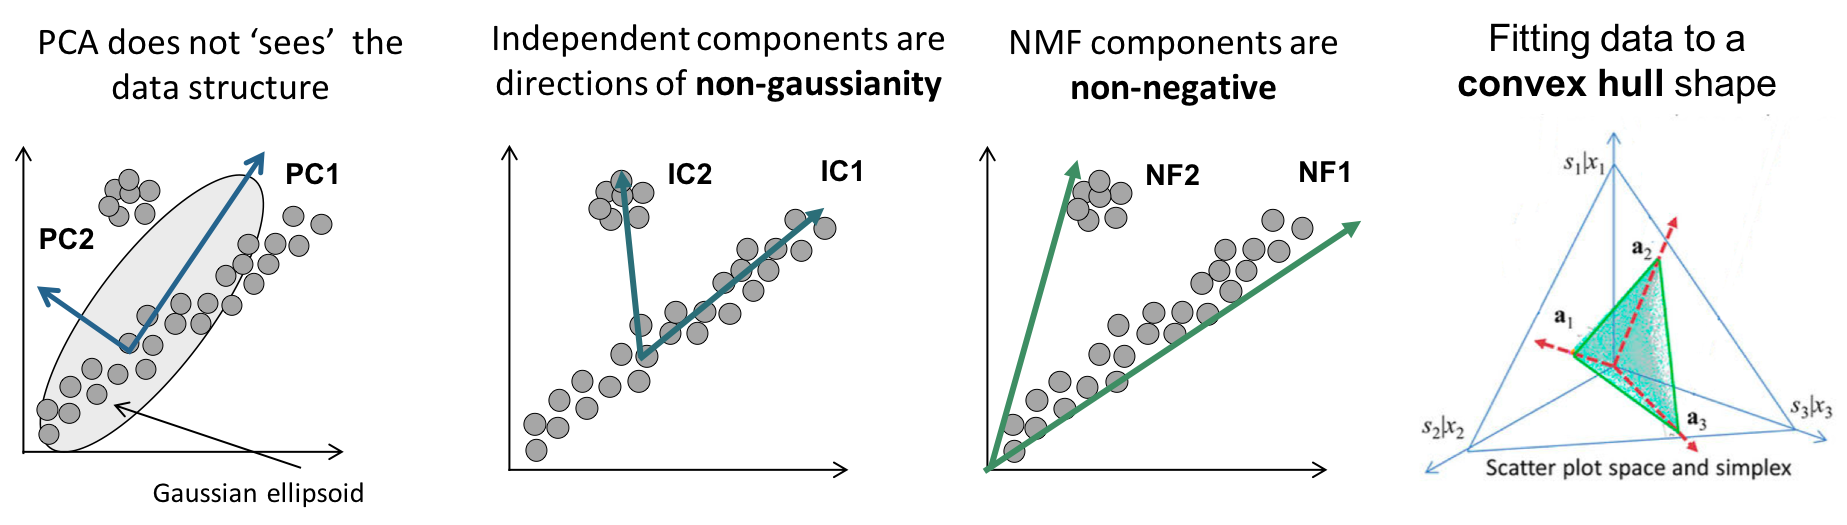
PCA 외에도 데이터를 성분으로 나누는 방법이 있다. 무엇을 "좋은 성분"으로 보는지가 다르다.
- 독립성분 분석(Independent Component Analysis, ICA)
- 관측된 데이터가 서로 독립적인 여러 신호가 섞인 것이라고 보고, 원래 신호를 분리
- 예: 여러 사람이 동시에 말하는 파티장에서 마이크 몇 개로 녹음한 소리를 사람별 목소리로 분리하기
- 비음행렬 분해(Non-Negative Matrix Factorization, NMF)
- 음수가 없는 "부품"들을 더해서 전체를 표현
- 예: 얼굴 사진을 눈, 코, 입 같은 부품의 합으로 보기. 문서를 여러 주제의 합으로 보기
실습
Colab에서 파일을 바로 내려받으려면 다음 셀 실행.
!wget -q -O brand_image.xlsx "https://www.mindscale.kr/content-assets/2cf7f9b5a9c44bad595d67cec564b11f8464d8a4c042d42e2e22abd9f7b6ae00/brand_image.xlsx"
- 실습 데이터: 커피·음식 프랜차이즈 브랜드 25개에 대한 이미지 설문
- 브랜드의 대중적 이미지를 바탕으로 만든 수업용 가상 데이터. 실제 조사 결과가 아님
- 브랜드 하나가 한 행 (총 25행)
- 각 문항은 "이 브랜드는 ~하다"에 대한 동의 정도를 여러 사람에게 물어본 평균 (1: 전혀 아니다 ~ 7: 매우 그렇다)
| 변수 | 내용 |
|---|---|
brand |
브랜드 |
category |
업종 (coffee, burger, chicken_pizza, bakery, salad_sandwich) |
quality |
맛과 재료의 품질이 좋다 |
atmosphere |
매장 분위기가 고급스럽다 |
special |
특별한 날 가고 싶다 |
gift |
기프티콘으로 선물하기 좋다 |
accessible |
매장이 가까이에 많다 |
fast |
주문하면 빨리 나온다 |
casual |
혼자 가볍게 들르기 편하다 |
ordering |
앱·키오스크·배달 주문이 편하다 |
cheap |
가격이 저렴하다 |
🤖 AI 프롬프트
brand_image.xlsx에 factor_analyzer 패키지로 PCA를 적용해라.
brand, category를 제외한 나머지 열을 입력으로 사용해.
표준화한 뒤 FactorAnalyzer(method="principal", rotation=None)로 PC1과 PC2를 만들고,
category별로 색을 다르게 한 산점도를 그려줘.
PCA 결과의 성분 적재량을 표로 보여줘.
Python 코드를 작성하고, 초보자를 위한 한글 주석을 달아줘.
데이터 로딩
import pandas as pd

df_brand = pd.read_excel("brand_image.xlsx")
df_brand.head()
실행 결과
             brand category  quality  atmosphere  special  gift  accessible  \
0        Starbucks   coffee      5.5         5.6      5.5   5.5         5.7
1  A Twosome Place   coffee      5.0         5.1      4.6   4.7         5.1
2            Ediya   coffee      3.3         2.9      2.9   3.3         5.6
3      Mega Coffee   coffee      2.9         2.2      3.5   3.8         5.5
4   Compose Coffee   coffee      3.1         2.7      2.7   2.9         5.1

   fast  casual  ordering  cheap
0   4.5     5.3       5.3    3.1
1   5.3     5.4       5.1    3.6
2   5.0     5.0       4.4    5.1
3   5.8     5.9       6.1    6.1
4   5.7     5.3       5.0    5.9
- 설문 문항 9개를 입력으로 사용
feature_cols = [
    "quality",
    "atmosphere",
    "special",
    "gift",
    "accessible",
    "fast",
    "casual",
    "ordering",
    "cheap",
]

X = df_brand[feature_cols]
표준화
from sklearn.preprocessing import StandardScaler
X_scaled = StandardScaler().fit_transform(X)
PCA 실시
- scikit-learn에도
PCA가 있지만, 뒤에서 할 주성분 회전 기능이 없음 - 그래서 처음부터
factor_analyzer패키지로 PCA 실시
!pip install factor_analyzer "scikit-learn<1.8"
factor_analyzer최신판(0.5.1)은 scikit-learn 1.8 이상에서 오류가 나므로 scikit-learn을 1.8 미만으로 함께 설치
from factor_analyzer import FactorAnalyzer

fa = FactorAnalyzer(
    n_factors=2,  # `n_factors=2`: 주성분 2개 추출
    method="principal", # `method="principal"`: 주성분 방식으로 추출
    rotation=None)  # `rotation=None`: 회전하지 않음
fa.fit(X_scaled)
pc = fa.transform(X_scaled)  # `transform`: 각 브랜드의 주성분 점수 계산

df_pca = df_brand.copy()
df_pca["PC1"] = pc[:, 0]
df_pca["PC2"] = pc[:, 1]
시각화
import seaborn as sns
sns.scatterplot(data=df_pca, x="PC1", y="PC2", hue="category")
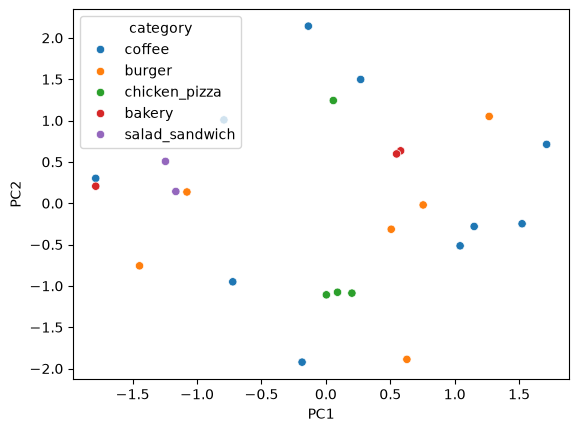
- 업종별로 뚜렷하게 나뉘지 않음
- 같은 업종 안에서도 브랜드마다 이미지가 다르기 때문
적재량
- 성분 적재량(loading): 원래 변수와 주성분 사이의 상관
- 1이나 -1에 가까울수록 그 변수가 주성분과 강하게 연결됨
- 부호가 +면 함께 커지고, -면 반대로 움직임
- 0에 가까우면 거의 관계없음
- 적재량을 보면 각 주성분이 어떤 변수들로 이루어졌는지 알 수 있음
pd.DataFrame(fa.loadings_, index=feature_cols, columns=["PC1", "PC2"]).round(2)
실행 결과
             PC1   PC2
quality    -0.85  0.50
atmosphere -0.91  0.37
special    -0.90  0.35
gift       -0.76  0.57
accessible  0.81  0.51
fast        0.90  0.34
casual      0.77  0.60
ordering    0.73  0.62
cheap       0.95 -0.14
- 모든 변수가 PC1, PC2와 관련이 있어 해석하기 어려움
퀴즈
차원 축소의 기본 목적에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.