K-Means
K-평균 군집분석
- 대표적인 중심 기반 군집분석 알고리즘
- K-Means: "K개의 평균"이라는 뜻
- 각 사례가 다른 군집보다 자신이 속한 군집의 중심점에 가장 가깝게 만듦
- 각 군집의 중심점은 해당 군집에 속한 사례들의 평균
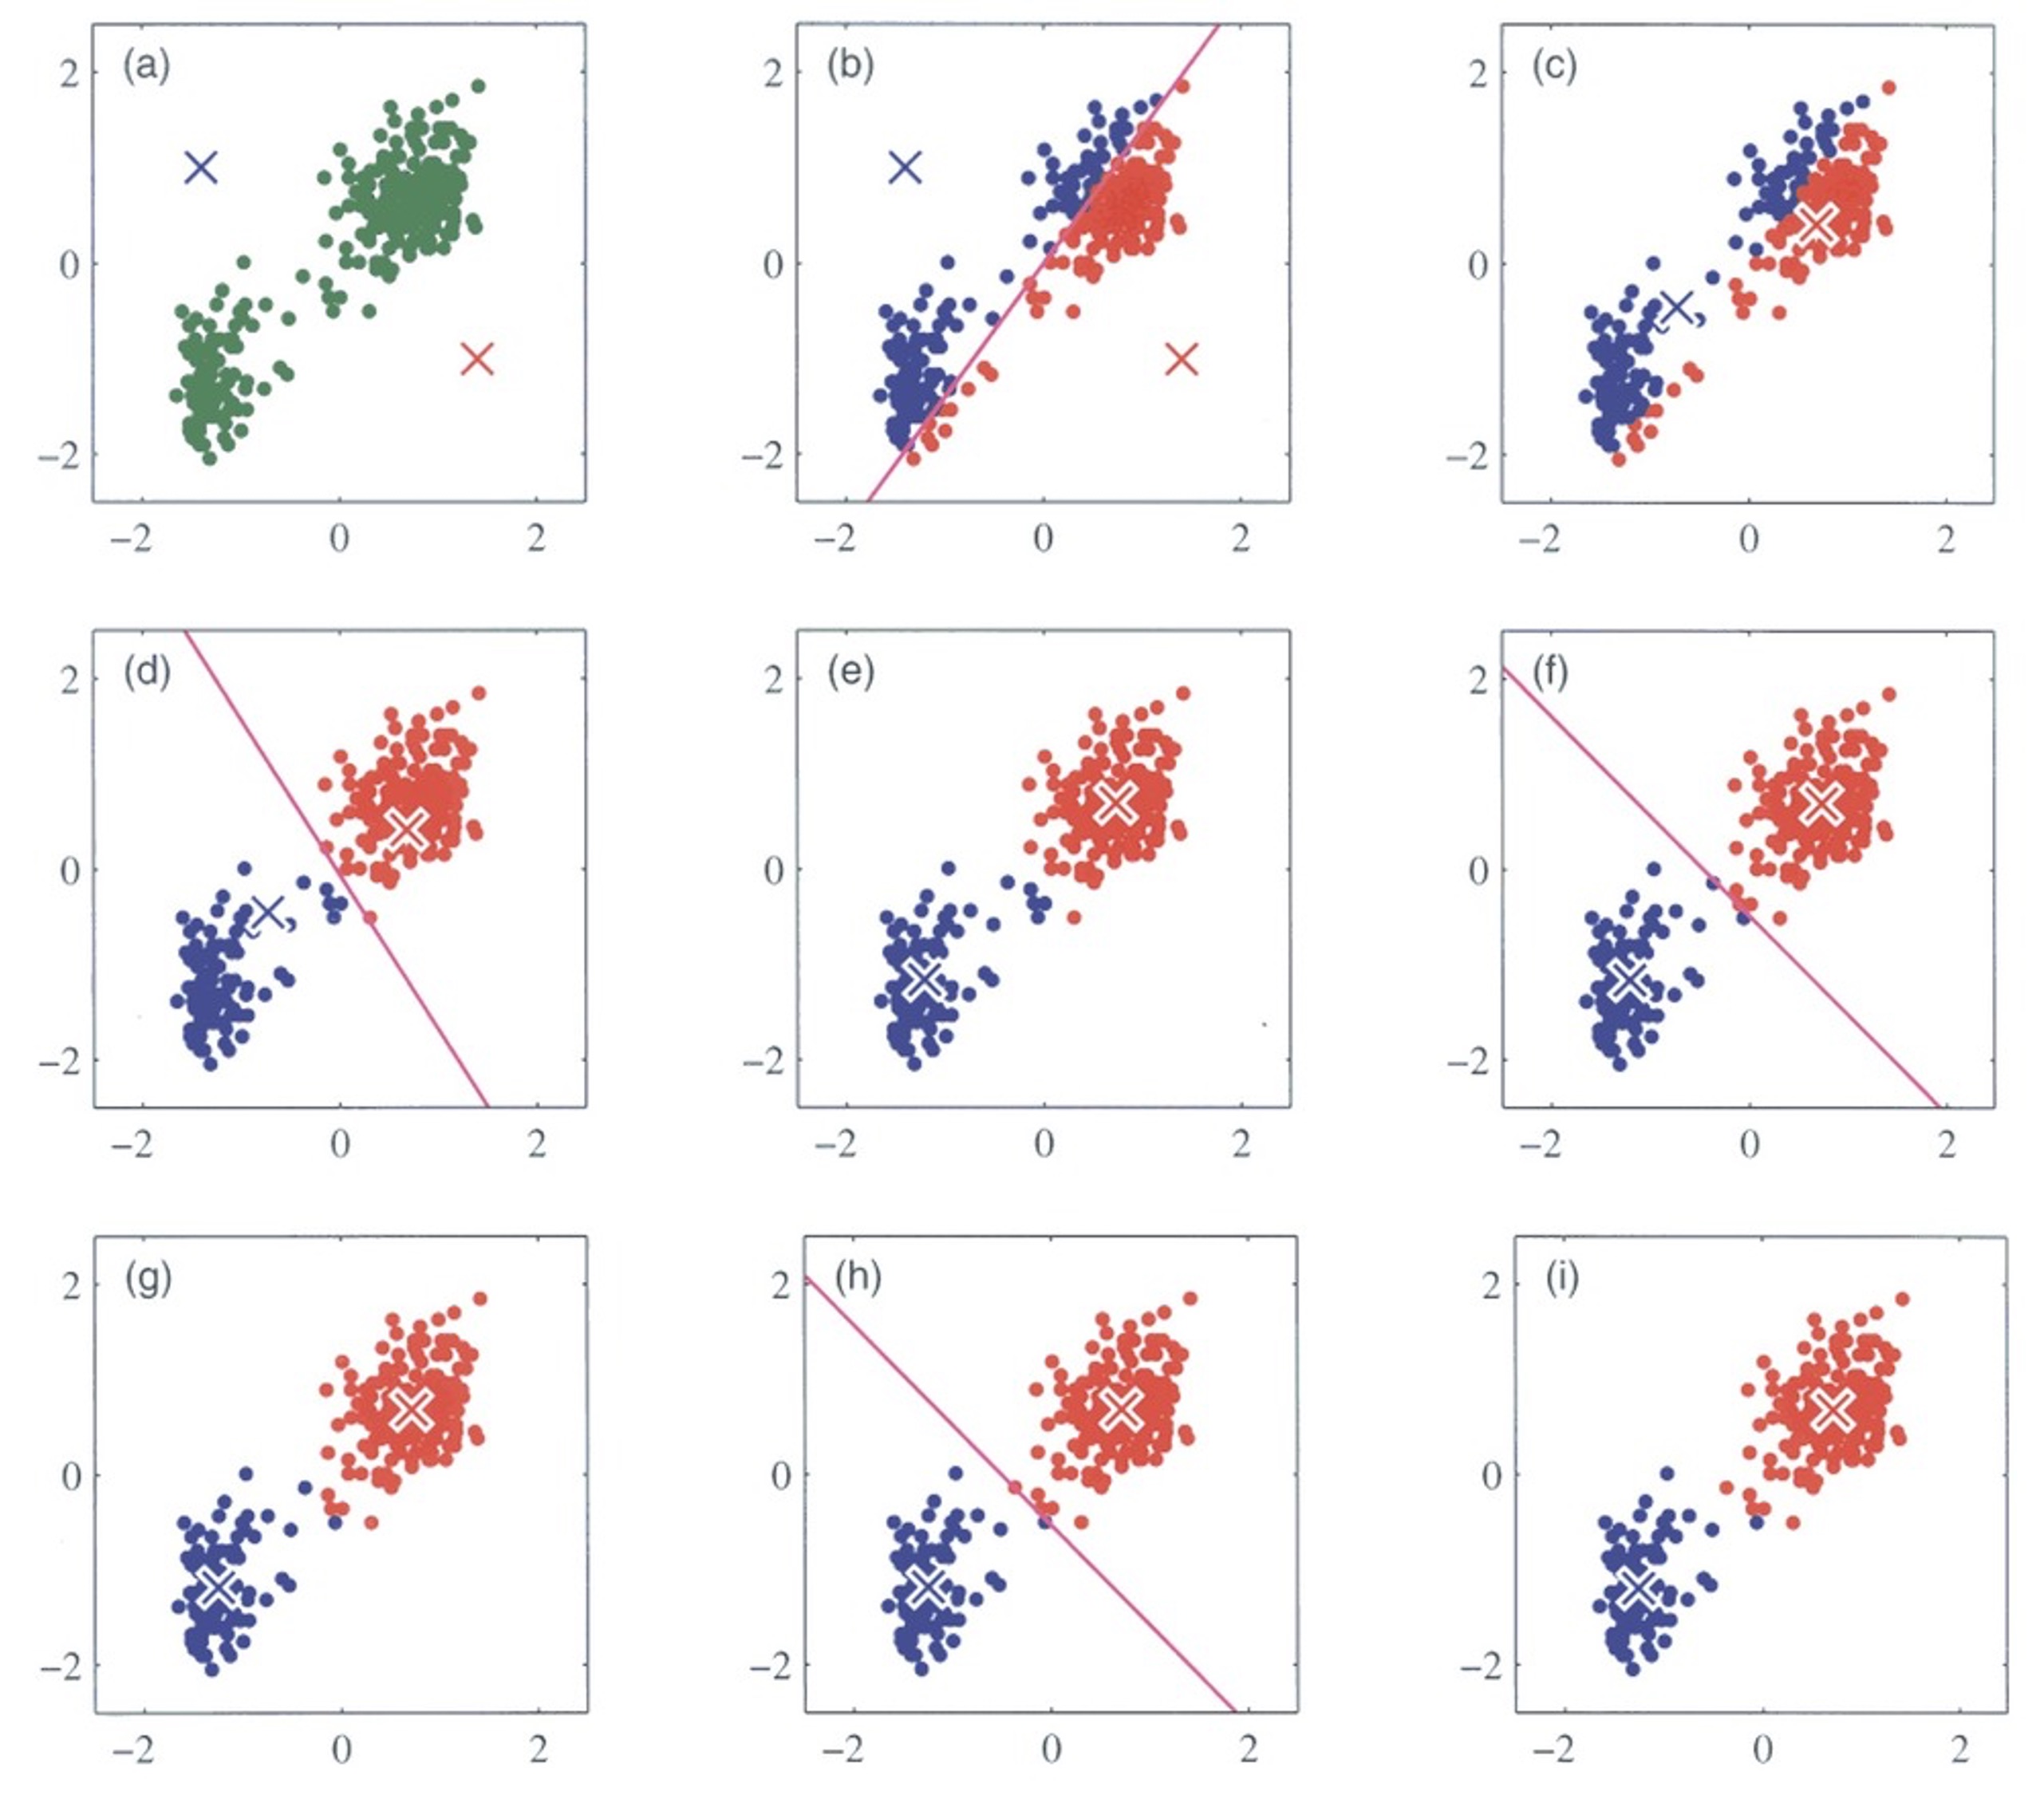
- 예시 절차
- 사례들을 두 개의 군집으로 나눌 경우, 무작위로 두 군집의 중심점을 설정
- 각 사례들을 두 중심점 중 더 가까운 중심점의 군집에 배정
- 각 군집에 속한 사례들을 평균하여 새로운 중심점을 설정
- 더 이상 군집에 변화가 없을 때까지 배정과 중심점 갱신을 반복
실습 프롬프트
🤖 AI 프롬프트
ship_cluster.xlsx의 선박 운항 사례를 K-Means로 군집분석을 해줘.
case_id와 operation_case를 제외한 나머지 열을 입력으로 사용해.
입력 변수는 StandardScaler로 표준화한 뒤 사용해.
군집 수는 3개
각 군집의 평균을 바탕으로 특징을 해석해줘.
파이썬 코드와 초보자를 위한 한글 주석을 작성해줘.
K-Means 실습: 데이터 로딩
Colab에서 파일을 바로 내려받으려면 다음 셀 실행.
!wget -q -O ship_cluster.xlsx "https://www.mindscale.kr/content-assets/b1a55138947347c2e38f37856cb134ddb600f74d4229b40c85b3ad4e7414bd75/ship_cluster.xlsx"
- 실습 패키지 설치
pip install pandas matplotlib seaborn scikit-learn openpyxl numpy
- 임포트와 파일 불러오기
import pandas as pd

df = pd.read_excel('ship_cluster.xlsx')
K-Means 실습: 군집분석에 사용할 변수 선택
feature_cols = [
    'route_distance_nm',
    'avg_payload_ton',
    'daily_engine_hour',
    'service_speed_knot',
    'fuel_use_ton_day',
    'port_stay_hour',
    'maintenance_interval_day',
]

X_cluster = df[feature_cols]
X_cluster.shape  # 사례 수와 입력 변수 수
실행 결과
(135, 7)
- 선박 운항 사례 135건, 군집분석에 사용할 변수 7개
표준화
- K-Means는 두 데이터 점 사이의 거리를 기준으로 비슷한 정도 계산
- 운항거리, 적재량, 연료 사용량처럼 단위와 범위가 다른 여러 변수의 차이를 합쳐 거리 계산
- 변수 범위가 다르면 큰 숫자의 변수가 군집 결과를 좌우
- 표준화는 변수마다 평균 0, 표준편차 1로 맞춰 같은 기준에서 비교
from sklearn.preprocessing import StandardScaler

X_scaled = StandardScaler().fit_transform(X_cluster)
표준화 전후의 차이 비교
- 전체 입력 변수를 표준화한 뒤, 운항거리(
route_distance_nm)와 평균 적재량(avg_payload_ton)의 변화만 비교
| 구분 | 운항거리 | 평균 적재량 |
|---|---|---|
| 표준화 전 | [98, 433]해리 | [1,870, 5,656]톤 |
| 표준화 후 | [-1.99, 1.37] | [-1.61, 2.00] |
- 표준화 후에는 원래 단위가 사라지고, 두 변수 모두 평균이 약 0, 표준편차가 1
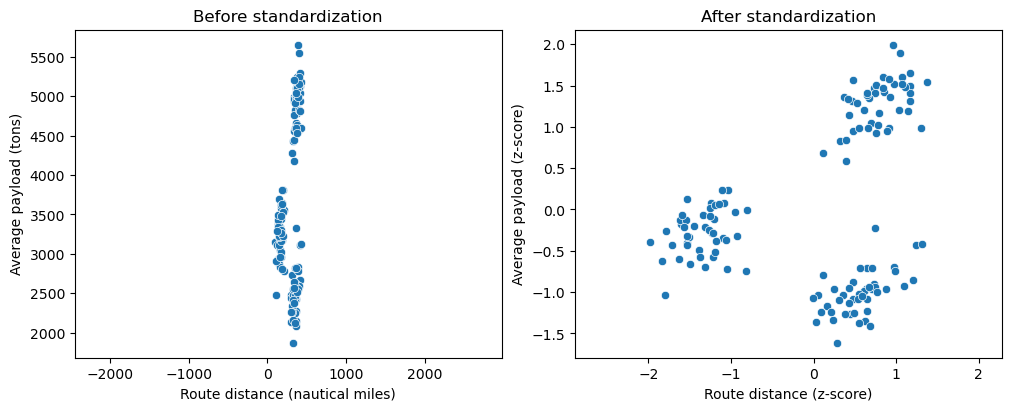
- 표준화 전: 적재량의 수치 범위가 더 커서, 운항 거리에 따른 차이가 드러나지 않음
- 표준화 후: 두 변수 모두 평균에서 몇 표준편차 떨어져 있는지로 비교
K-Means 적용
- 여러 운항 변수를 함께 사용해 군집분석 수행
- 각 운항 사례에 군집 번호 부여
from sklearn.cluster import KMeans

# 군집 수를 3개로 지정하고 군집 번호 생성
kmeans = KMeans(
    n_clusters=3,  # 만들 군집의 개수
    random_state=42, #  처음 중심점을 무작위로 정할 때 사용하는 난수 시드
    n_init=10)
n_init=10: 처음 중심점을 서로 다르게 정해서 K-Means를 10번 실행- K-Means의 결과는 처음 중심점을 어디에 두느냐에 따라 달라질 수 있음
- 운이 나쁘면 군집이 어색하게 나뉜 상태에서 더 이상 바뀌지 않고 멈춤
- 10번 실행한 결과 중 관성(inertia)이 가장 작은, 즉 사례들이 중심점에 가장 가깝게 모인 결과를 최종 결과로 사용
- 값을 키우면 더 안정적인 결과를 얻지만 계산 시간이 늘어남
실행
df['cluster'] = kmeans.fit_predict(X_scaled)
df[['case_id', 'operation_case', 'cluster']].head()
실행 결과
  case_id      operation_case  cluster
0   OP099  offshore_logistics        1
1   OP068      coastal_supply        0
2   OP106  offshore_logistics        1
3   OP020       port_rotation        2
4   OP043       port_rotation        2
cluster: 각 운항 사례에 부여된 군집 번호- 군집 번호는 그룹 구분용이며 크기나 우열을 의미하지 않음
군집별 특징 해석
- 군집별로 원래 변수의 평균을 비교하면 각 군집의 특징 파악 가능
# 숫자 열만 군집별 평균 계산에 사용
df.groupby('cluster').mean(numeric_only=True)
실행 결과
         route_distance_nm  avg_payload_ton  daily_engine_hour  \
cluster
0               374.405350      4913.186214          13.335591
1               351.926277      2503.645820          17.935741
2               161.548970      3270.599089           9.916371

         service_speed_knot  fuel_use_ton_day  port_stay_hour  \
cluster
0                 14.843470         28.957953        6.682877
1                 11.524751         36.907631       16.247339
2                 12.798525         16.280624       12.044409

         maintenance_interval_day
cluster
0                       43.377228
1                       25.505687
2                       34.156764
- 군집 0: 적재량이 많고 항만 체류 시간이 짧은 유형(
avg_payload_ton평균 4,913.19톤,port_stay_hour평균 6.68시간) - 군집 1: 하루 엔진 가동 시간이 길고 연료 사용량이 많은 유형(
daily_engine_hour평균 17.94시간/일,fuel_use_ton_day평균 36.91톤/일) - 군집 2: 운항 거리가 짧고 연료 사용량이 적은 유형(
route_distance_nm평균 161.55해리,fuel_use_ton_day평균 16.28톤/일)
퀴즈
K-Means에서 각 군집의 중심점은 무엇을 의미하나요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.