
활성화 함수
활성화 함수 activation function
뉴런은 입력의 선형 결합 z를 계산한 뒤 활성화 함수 g를 적용해 출력 a를 만듦.
z=i∑wixi+b,a=g(z)- 비선형성 도입: 신경망이 곡선 형태의 복잡한 결정 경계를 표현하도록 함
- 출력 변환: 값을 특정 범위로 제한하거나 필요한 형태로 변환
- 모든 활성화 함수가 출력 범위를 제한하는 것은 아님. ReLU의 양수 출력에는 상한이 없음
- 역전파: 학습 구간에서 미분 또는 준미분(subgradient)을 계산할 수 있어야 함
- ReLU는 0에서 미분되지 않지만, 구현에서는 기울깃값을 정해 역전파
- 계단 함수(step function)는 거의 모든 구간에서 기울기가 0이므로 은닉층 학습에 부적합
- 주요 함수: 시그모이드(sigmoid), 소프트맥스(softmax), 쌍곡탄젠트(tanh), ReLU와 그 변형
비선형 활성화가 필요한 이유
활성화 함수 없이 두 선형층을 연결하면 하나의 아핀 변환으로 합칠 수 있음.
z1z2=W1x+b1=W2z1+b2=(W2W1)x+(W2b1+b2)따라서 선형층을 여러 개 쌓아도 표현력은 하나의 선형층과 같음. 층 사이에 비선형 함수 g를 넣어야 하나의 선형 변환으로 합칠 수 없고, 복잡한 패턴을 표현 가능.
z2=W2g(W1x+b1)+b2은닉층에서 sigmoid 함수의 문제점
σ(x)=(1+e−x)−1,σ′(x)=σ(x)(1−σ(x))- 출력 범위: (0,1)
- 이항 분류의 출력층에서 확률을 표현할 때 주로 사용
- 포화 saturation
- 입력의 절댓값이 크면 함수의 양쪽 끝에서 경사가 거의 0 → 사라지는 경사
- 입력값이 변하더라도 출력값에 거의 차이가 없음
- 중심이 0이 아님 not zero-centered
- 이전 층의 출력이 모두 양수이면, 한 뉴런으로 들어오는 가중치 경사의 부호가 같은 방향으로 묶이기 쉬움
- 최적점으로 곧장 이동하지 못하고 지그재그로 이동해 학습이 느려질 수 있음
- 로지스틱 함수는 출력이 (0,1) 범위 → 다음 레이어의 모든 입력 xi가 양수
- xi는 wi로 f를 미분한 값
- 하나의 학습 사례에서 가중치 wi에 대해 손실 함수 L을 미분하면 부호가 dL/df와 같아짐
- 미니배치에서는 사례별 경사가 합쳐지므로 모든 가중치의 최종 경사가 항상 같은 부호라는 뜻은 아님
쌍곡탄젠트 Hyperbolic Tangent
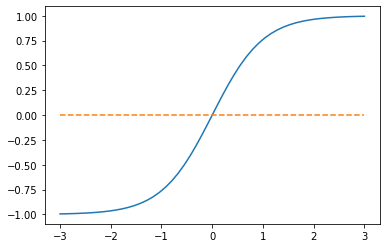
tanh(x)=2σ(2x)−1- 로지스틱 함수와 비슷한 S자 형태지만 출력 범위가 (−1,1)
- 출력의 중심이 0인 zero-centered 함수
- 입력의 절댓값이 크면 기울기가 0에 가까워지는 포화 문제는 남아 있음
Rectified Linear Unit
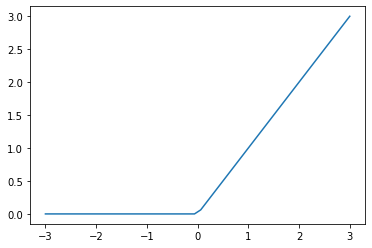
f(x)=max(0,x)={0xx<0x≥0- 출력의 중심이 0이 아닌 not zero-centered 함수
- 계산이 간단해 은닉층에 흔히 사용
- x>0에서 기울기가 1이므로 양수 영역의 포화 문제를 완화
- x=0에서는 미분되지 않지만 학습 구현에서는 기울깃값을 정해 처리
- x<0에서는 출력과 기울기가 모두 0
- 뉴런의 입력이 계속 음수이면 가중치가 더 이상 학습되지 않는 죽은 ReLU(dead ReLU) 발생 가능
- 지나치게 높은 학습률은 죽은 ReLU의 위험을 높일 수 있음
- Leaky ReLU, GELU 등의 보완된 버전들이 있음. → 죽은 ReLU를 완화
활성화 함수 선택
| 위치와 과제 | 주로 사용하는 함수 | 출력 해석 |
|---|---|---|
| 은닉층 | ReLU, Leaky ReLU, GELU | 비선형 특징 |
| 이항 분류 출력층 | sigmoid | 한 클래스일 확률 |
| 서로 배타적인 다항 분류 출력층 | softmax | 클래스별 확률 분포 |
| 범위 제한이 없는 회귀 출력층 | 선형(linear), 즉 활성화 함수 없음 | 실숫값 |
출력층의 활성화 함수는 예측 대상과 손실 함수에 맞춰 선택. 은닉층과 출력층이 반드시 같은 활성화 함수를 사용할 필요는 없음.
퀴즈
선형층 사이에 비선형 활성화 함수를 넣지 않고 여러 층을 쌓으면 어떻게 됩니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.