경사하강법
그래디언트
- 손실 함수 L: 신경망의 예측 y^과 실제값 y의 차이를 측정
- 학습: 손실이 작아지도록 파라미터를 찾는 과정
- 손실은 파라미터의 함수
- 파라미터를 바꿀 때 손실이 어떻게 변하는지 알면 손실을 줄이는 방향을 찾을 수 있음
- 그래디언트(gradient) ∇L: 파라미터를 조금 바꿀 때 손실이 변하는 정도
- 파라미터가 하나이면 손실 곡선의 기울기 ∂L/∂w
- 파라미터가 여러 개이면 각 파라미터에 대한 편미분을 모은 벡터
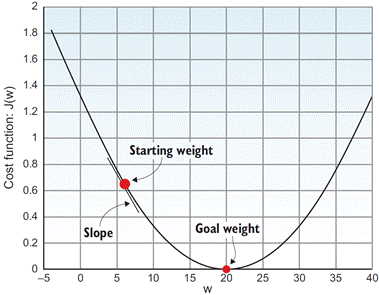
기울기의 부호는 손실이 변하는 방향을 나타냄.
- 기울기가 양수: w가 커지면 손실 증가
- 기울기가 음수: w가 커지면 손실 감소
- 기울기가 0: 곡선의 바닥이나 꼭대기처럼 평평한 지점
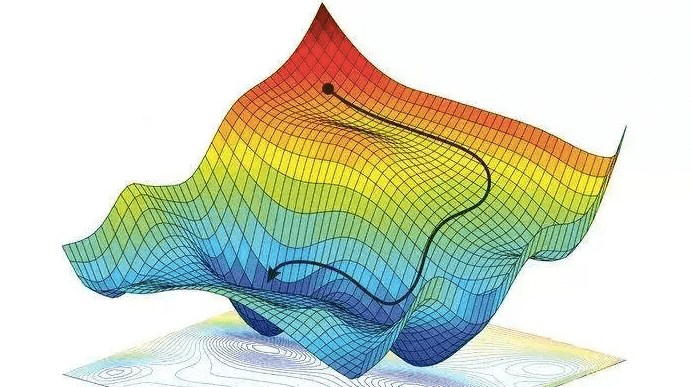
파라미터가 여러 개이면 손실은 여러 차원의 표면. 이때 그래디언트는 손실이 가장 빠르게 증가하는 방향을 가리킴.
경사하강법
경사하강법(gradient descent)은 그래디언트의 반대 방향으로 파라미터를 반복해서 수정해 손실을 줄이는 최적화 방법.
- 현재 파라미터 wt로 예측 y^ 계산
- 정답 y와 비교해 손실 L 계산
- 파라미터에 대한 손실의 그래디언트 ∇L(wt) 계산
- 그래디언트의 반대 방향으로 파라미터 수정
η는 한 번에 이동할 크기를 조절하는 학습률(learning rate).
- 기울기가 양수이면 w 감소, 음수이면 w 증가
- 파라미터가 여러 개이면 손실이 가장 빠르게 감소하는 방향으로 이동
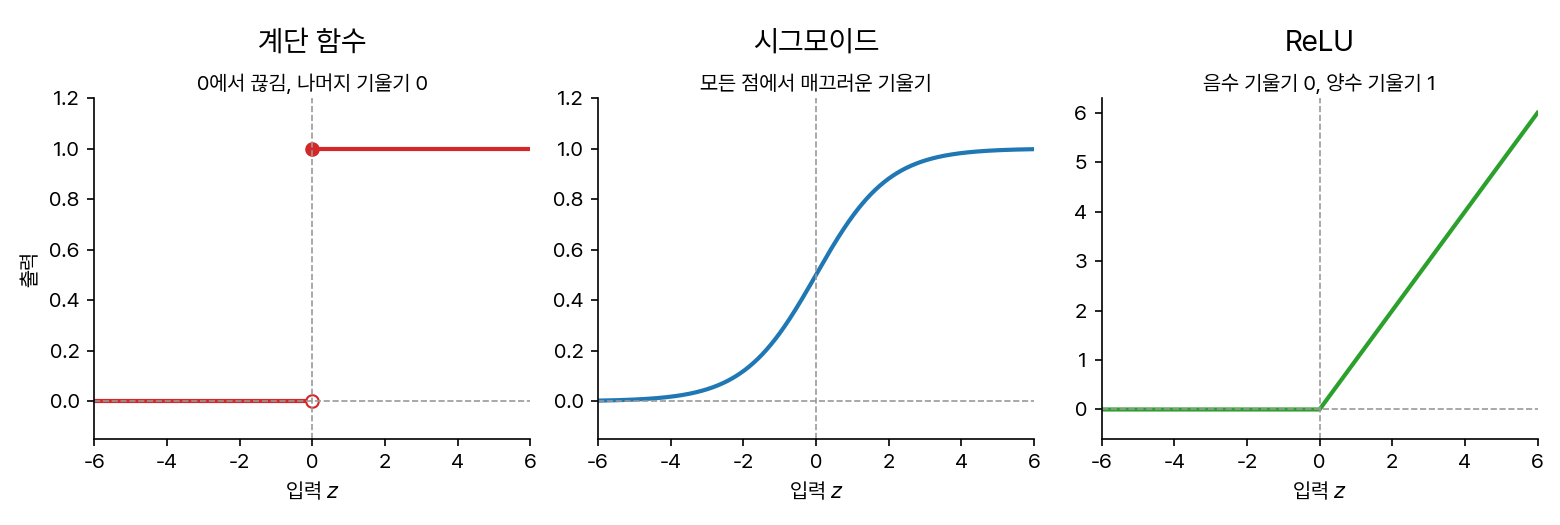
- 미분 가능성: 경사하강법은 그래디언트를 계산해야 하므로 손실이 파라미터에 대해 미분 가능해야 함
- 계단 함수는 기울기가 거의 모든 곳에서 0이라 가중치를 어느 방향으로 바꿔야 할지 알 수 없음
- 그래서 신경망은 시그모이드, ReLU처럼 기울기를 계산할 수 있는 활성화 함수를 사용
계산 예시
다음 데이터에 원점을 지나는 직선 y^=wx를 적합. 손실은 평균 제곱 오차이고 학습률은 0.1.
| x | y |
|---|---|
| 1 | 3 |
| 2 | 6 |
| 3 | 9 |
| 4 | 12 |
사례 하나의 손실과 그래디언트.
L=(y−wx)2,∂w∂L=−2x(y−wx)네 사례의 손실과 그래디언트를 평균해 한 번의 업데이트에 사용.
1단계
w=0에서 예측과 그래디언트를 계산.
| y | x | y^ | y−y^ | L | ∂L/∂w | |
|---|---|---|---|---|---|---|
| 3 | 1 | 0 | 3 | 9 | -6 | |
| 6 | 2 | 0 | 6 | 36 | -24 | |
| 9 | 3 | 0 | 9 | 81 | -54 | |
| 12 | 4 | 0 | 12 | 144 | -96 | |
| 평균 | 67.5 | -45 |
그래디언트가 -45이므로 w를 증가시키면 손실 감소.
w←0−0.1×(−45)=4.52단계
w=4.5에서 같은 계산 반복.
| y | x | y^ | y−y^ | L | ∂L/∂w | |
|---|---|---|---|---|---|---|
| 3 | 1 | 4.5 | -1.5 | 2.25 | 3 | |
| 6 | 2 | 9 | -3 | 9 | 12 | |
| 9 | 3 | 13.5 | -4.5 | 20.25 | 27 | |
| 12 | 4 | 18 | -6 | 36 | 48 | |
| 평균 | 16.88 | 22.5 |
그래디언트가 22.5이므로 w를 감소시키면 손실 감소.
w←4.5−0.1×22.5=2.253단계
w=2.25에서 다시 계산.
| y | x | y^ | y−y^ | L | ∂L/∂w | |
|---|---|---|---|---|---|---|
| 3 | 1 | 2.25 | 0.75 | 0.56 | -1.5 | |
| 6 | 2 | 4.5 | 1.5 | 2.25 | -6 | |
| 9 | 3 | 6.75 | 2.25 | 5.06 | -13.5 | |
| 12 | 4 | 9 | 3 | 9 | -24 | |
| 평균 | 4.22 | -11.25 |
같은 계산을 반복한 결과.
| 업데이트 | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| w | 0 | 4.5 | 2.25 | 3.375 | 2.81 | 3.09 |
| 평균 손실 | 67.5 | 16.88 | 4.22 | 1.05 | 0.26 | 0.07 |
- w는 손실이 가장 작은 값인 3을 넘었다가 돌아오기를 반복하며 3에 가까워짐
- 3과의 차이는 업데이트마다 절반으로 줄고 부호가 바뀜
학습률
학습률은 그래디언트에 곱해 파라미터의 이동 폭을 결정.
- 너무 작으면 손실이 천천히 감소
- 너무 크면 최소점 주변을 지나치거나 손실이 발산할 수 있음
- 적절한 크기는 모델, 데이터, 배치 크기, 옵티마이저에 따라 달라짐
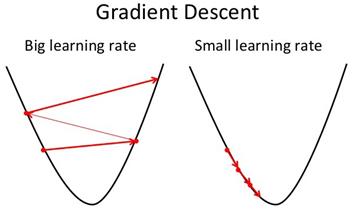
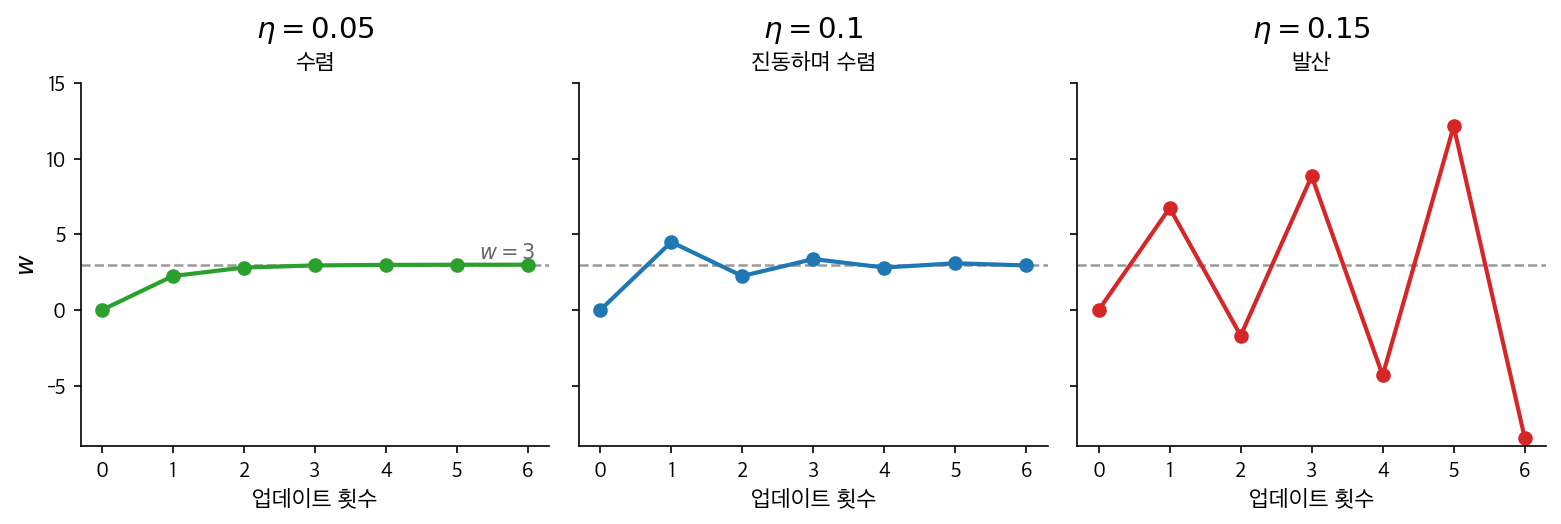
계산 예시에서 평균 그래디언트는 −15(3−w). 따라서 업데이트 한 번에 3과의 차이가 (1−15η)배가 됨.
wt+1−3=(1−15η)(wt−3)- η=0.05: 차이가 0.25배 → 한쪽에서 3에 수렴
- η=0.1: 차이가 −0.5배 → 3을 넘나들며 수렴
- η=0.15: 차이가 −1.25배 → 3에서 점점 멀어지며 발산
손실 표면의 어려움
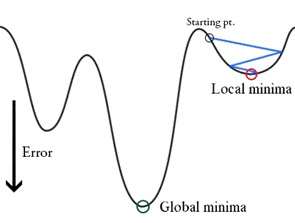
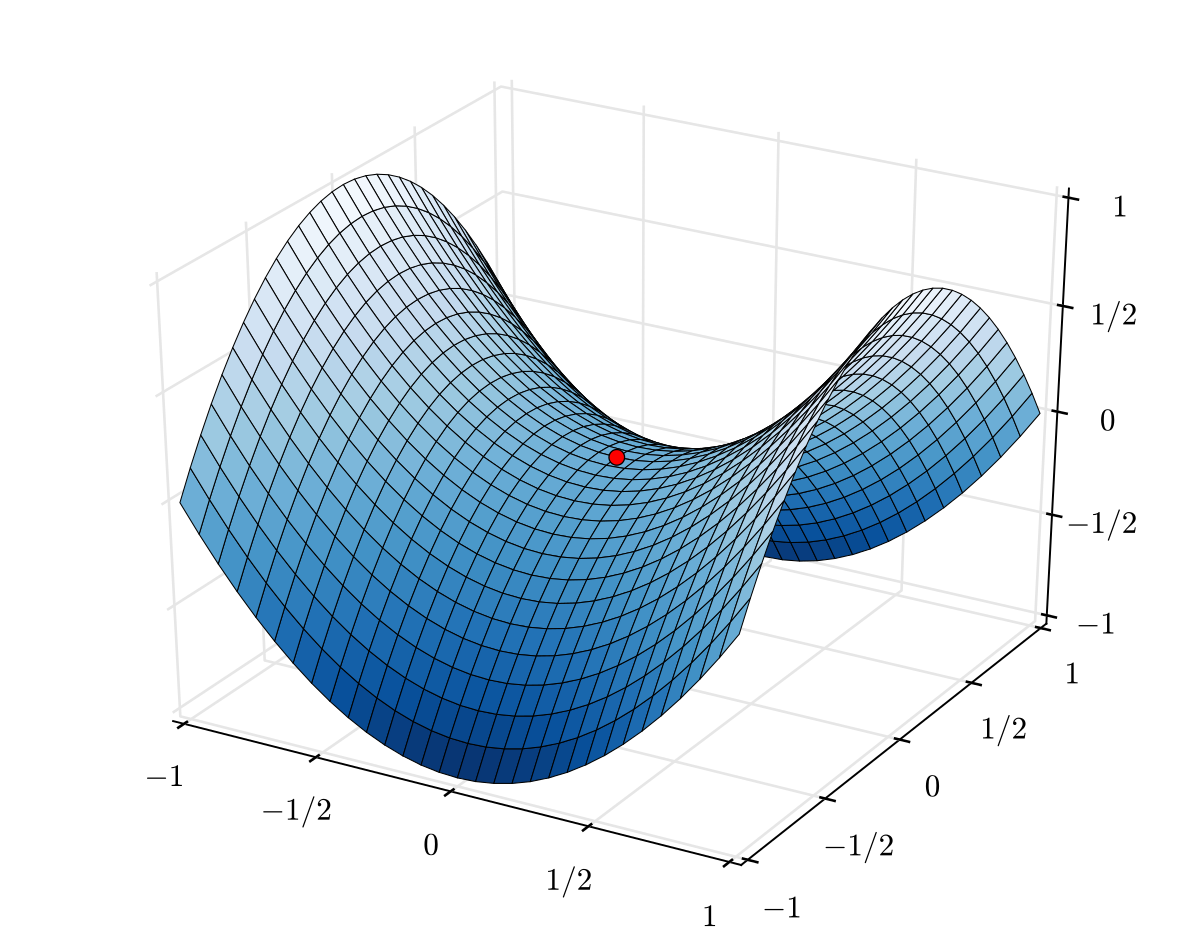
신경망의 손실 표면은 여러 차원의 비선형 형태. 국소 최소점, 안장점, 평탄한 구간에서는 학습이 느려질 수 있음.
- 국소 최소점(local minimum): 주변보다는 낮지만 전체에서 가장 낮지는 않은 지점
- 안장점(saddle point): 한 방향으로는 최소, 다른 방향으로는 최대인 지점
- 그래디언트가 0에 가까워도 반드시 최소점은 아님. 최대점, 안장점, 평탄한 구간에서도 그래디언트가 0에 가까울 수 있음
미니배치와 에포크
한 번의 파라미터 업데이트에 사용하는 데이터 수에 따라 계산 방식이 달라짐.
- 배치 경사하강법(batch gradient descent): 전체 훈련 데이터로 그래디언트 계산. 업데이트당 계산량이 크지만 같은 파라미터에서는 일정한 그래디언트 생성
- 확률적 경사하강법(stochastic gradient descent): 사례 하나로 그래디언트 계산. 업데이트가 빠르지만 방향의 변동이 큼
- 미니배치 경사하강법(mini-batch gradient descent): 일부 사례로 그래디언트 계산. 병렬 계산 효율과 그래디언트 변동 사이의 균형 제공
- 이것도 확률적 경사하강법으로 부르기도 함
- 딥러닝에서 대부분은 미니배치 경사하강법을 사용
- 어떤 사례가 뽑혔는지에 따라 값이 달라지므로 방향에 변동이 생김
- 이 변동은 앞에서 본 국소 최소점, 안장점, 평탄한 구간을 벗어나는 데 도움을 줄 수 있지만 탈출을 보장하지는 않음
훈련 반복을 세는 단위:
- 배치 크기(batch size): 한 번의 업데이트에 사용하는 사례 수
- 스텝(step): 파라미터 업데이트 한 번
- 에포크(epoch): 훈련 데이터 전체를 한 번씩 모두 사용하는 단위
- 1에포크의 스텝 수 = 훈련 데이터 수 ÷ 배치 크기 (나머지가 있으면 올림)
- 예: 훈련 데이터 12,665개, 배치 크기 32 → 1에포크에 396 스텝
퀴즈
경사하강법은 파라미터를 어떻게 수정합니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.