
정칙화
정칙화(regularization): 모델이 훈련 데이터에 지나치게 맞는 현상을 완화해 일반화 성능을 높이는 방법
정칙화 방법
- 가중치 감쇠(weight decay): 파라미터를 갱신할 때 가중치 크기를 줄이는 방법
- 드롭아웃(dropout): 훈련 중 일부 활성값을 무작위로 0으로 만드는 방법
- 정규화 계층(normalization layer): 중간 활성값의 위치와 크기를 조정해 훈련을 안정화하는 방법
- 레이블 스무딩(label smoothing): 정답 레이블의 목표 확률을 완화하는 방법
검증 성능을 기준으로 훈련 시점을 선택하는 방법은 조기 종료와 모델 체크포인트에서 학습.
실습 준비
import keras
가중치 감쇠
- 기본 경사하강법의 가중치 갱신:
- 가중치 감쇠를 적용한 갱신:
- η: 학습률
- λ: 가중치 감쇠 계수. 클수록 한 번의 갱신에서 가중치를 더 많이 줄임
- Keras 최적화 알고리즘의
weight_decay인자로 설정 - 모멘텀이 없는 기본 SGD에서는 L(w)+2λ∑iwi2를 손실로 사용한 경사 갱신과 동일
- Adam과 같은 적응형 최적화 알고리즘에서는 L2 벌점과 가중치 감쇠가 일반적으로 동일하지 않음
Lp 노름
- 노름(norm): 벡터의 길이 또는 크기를 일반화한 값
- p≥1일 때 Lp 노름:
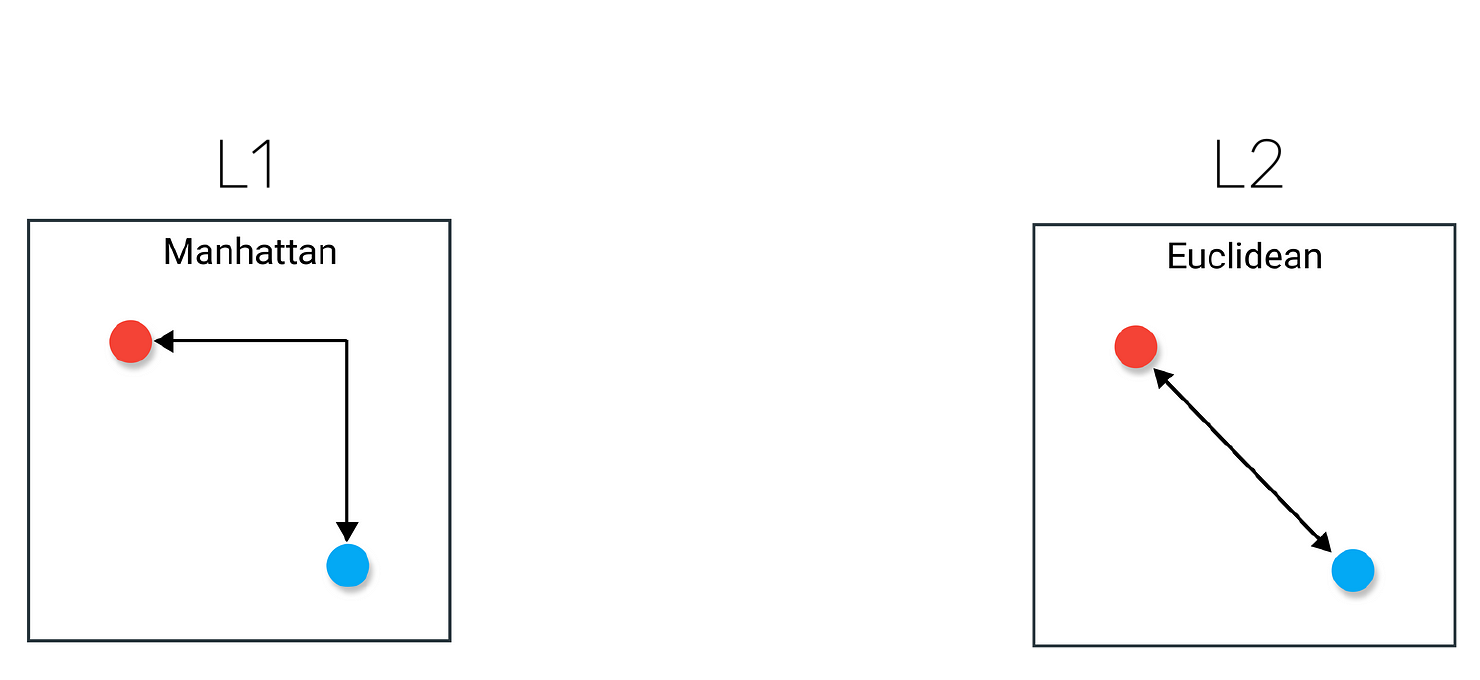
L1과 L2 정칙화
- L1 정칙화: 절댓값의 합을 벌점으로 추가
- L2 정칙화: 제곱합을 벌점으로 추가
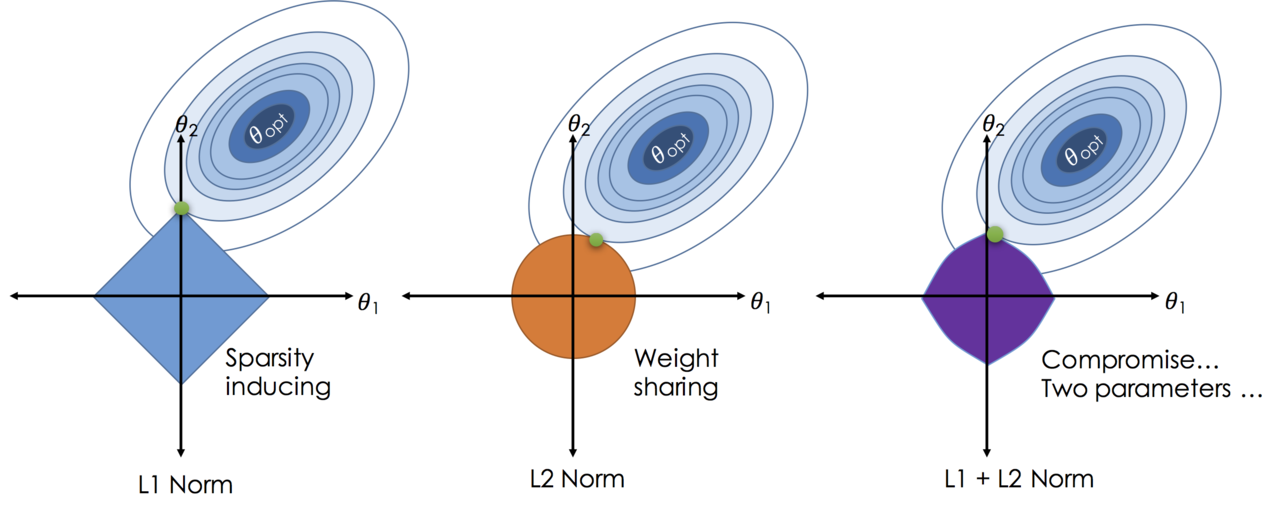
- L1 정칙화는 일부 가중치가 정확히 0이 되는 희소한 모형을 유도하기 쉬움
- L2 정칙화는 가중치를 전반적으로 작게 만들지만 보통 정확히 0으로 만들지는 않음
- 선형 회귀에서 L1 정칙화를 적용한 모형은 LASSO, L2 정칙화를 적용한 모형은 Ridge 회귀
- 라이브러리에 따라 L2 벌점의 1/2을 생략하므로 계수의 정의를 함께 확인
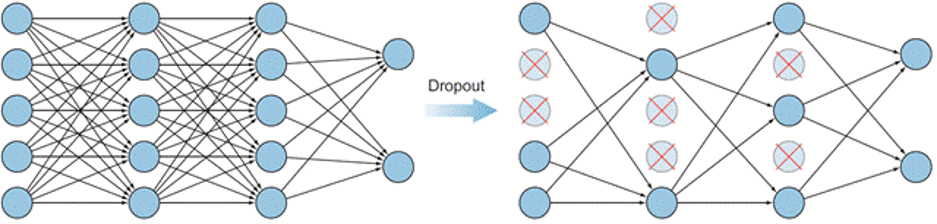
드롭아웃
- 드롭아웃 계층이 받은 활성값 중 일부를 훈련 단계마다 무작위로 0으로 대체
- 모델이 일부 특징이나 경로에 지나치게 의존하는 현상을 완화
- 드롭아웃 비율 r은 0 이상 1 미만으로 설정
- Keras는 훈련 중 남은 활성값을 1/(1−r)배로 보정하는 역 드롭아웃 사용
- 예측 시에는 모든 활성값을 그대로 사용하고 별도로 크기를 조정하지 않음
Keras 적용
model = keras.models.Sequential(
    [
        keras.layers.Rescaling(1 / 255),  # 픽셀값을 [0, 1] 범위로 조정
        keras.layers.Flatten(),
        keras.layers.Dense(128, activation="relu"),  # 은닉 유닛 128개
        keras.layers.Dropout(0.5),  # 활성값의 50%를 무작위로 0으로 설정
        keras.layers.Dense(10),  # 클래스 10개의 로짓 출력
    ]
)
정규화
- 정규화(normalization): 특징의 중심이나 크기를 조정하는 여러 변환을 가리키는 표현
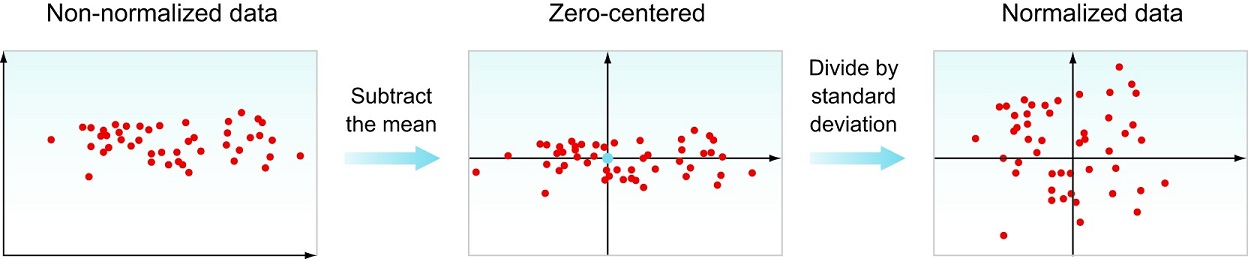
- 대표적인 특징 스케일링 방법인 표준화(standardization):
- x: 변환할 값
- μ: 훈련 데이터에서 계산한 특징의 평균
- σ: 훈련 데이터에서 계산한 특징의 표준편차
- 표준화에 사용한 훈련 데이터에서는 변환된 특징의 평균이 0, 표준편차가 1
- 서로 다른 단위나 크기를 가진 특징을 비슷한 척도에서 다루기 쉬움
- 문헌과 라이브러리에 따라 normalization의 범위가 다름
- 좁은 의미에서는 값을 [0,1]로 옮기는 최소-최대 스케일링(min-max scaling)만을 normalization이라고 부르기도 함
- 정규화(normalization)와 정칙화(regularization)는 목적과 연산이 다른 개념
입력 정규화
- 이미지의 픽셀값은 보통 [0,255]에서 [−1,1]이나 [0,1] 범위로 조정
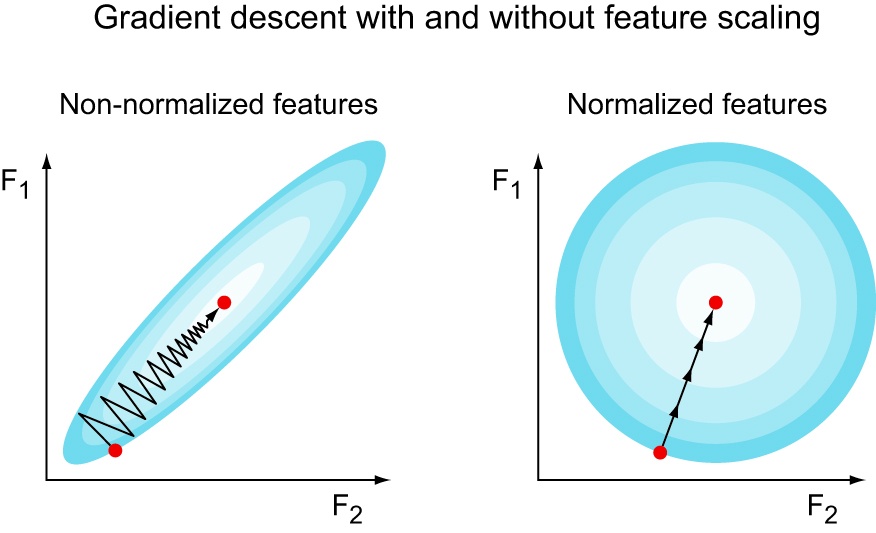
- 특징마다 값의 크기가 크게 다르면 손실 표면의 축별 기울기 크기도 달라져 갱신 경로가 진동 가능
- 특징의 척도를 비슷하게 조정하면 경사하강법이 더 안정적으로 수렴 가능
배치 정규화
- 배치 정규화(batch normalization)는 계층이 받은 활성값을 미니배치의 통계로 표준화한 뒤, 학습 가능한 크기 γ와 위치 β를 적용
- 훈련 시 현재 미니배치의 평균 μB와 분산 σB2를 사용하고 이동 평균과 이동 분산을 함께 갱신
- 예측 시 현재 입력 배치의 통계가 아니라 훈련 중 누적한 이동 평균과 이동 분산을 사용
정규화 축
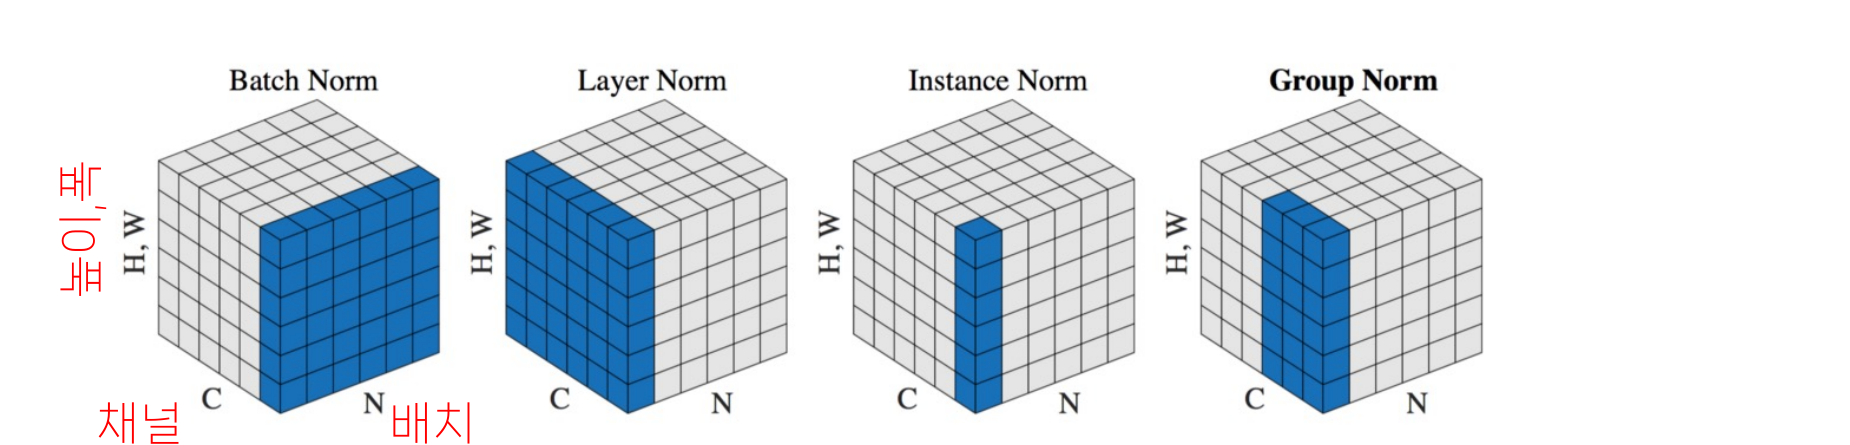
- 이미지 활성값의 축을
(N, C, H, W)로 나타낼 때의 일반적인 구분:- 배치 정규화(Batch Norm): 채널마다
N,H,W에 걸쳐 통계 계산 - 계층 정규화(Layer Norm): 사례마다 지정된 특징 축에 걸쳐 통계 계산. 그림에서는
C,H,W를 사용 - 인스턴스 정규화(Instance Norm): 사례와 채널마다
H,W에 걸쳐 통계 계산 - 그룹 정규화(Group Norm): 사례마다 채널을 그룹으로 나누고 그룹 안의 채널,
H,W에 걸쳐 통계 계산
- 배치 정규화(Batch Norm): 채널마다
- 실제 정규화 축은 입력 텐서의 형태와 계층의
axis설정에 따라 달라짐
내부 공변량 변화 가설
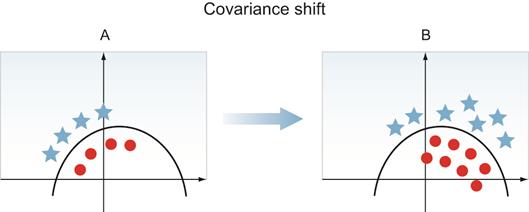
- 다층 신경망에서는 앞 계층의 출력이 다음 계층의 입력
- 앞 계층의 파라미터가 갱신되면 다음 계층이 받는 입력의 분포도 변화
- 초기 배치 정규화 논문은 이 현상을 내부 공변량 변화(internal covariate shift)라고 부르고, 이를 줄여 학습을 돕는다고 설명
- 후속 연구에서는 입력 분포의 안정성이 배치 정규화의 성능 향상을 충분히 설명하지 못하며, 더 매끄러운 손실 표면과 안정적인 기울기가 중요한 원인이라고 제시
배치 정규화의 효과
- 활성값의 중심과 크기를 조절해 포화 영역에 머무는 현상을 완화 가능
- 더 큰 학습률에서도 안정적인 훈련이 가능한 경우가 많아 수렴 속도 향상 가능
- 기울기 소실이나 폭발을 완화하고 최적화 경로를 안정화 가능
- 미니배치 통계의 변동이 잡음으로 작용해 부수적인 정칙화 효과 가능
- 정칙화 효과는 배치 크기와 모델에 따라 달라지므로 드롭아웃을 항상 대체하지는 않음
Keras 적용
model = keras.models.Sequential(
    [
        keras.layers.Rescaling(1 / 255),  # 픽셀값을 [0, 1] 범위로 조정
        keras.layers.Flatten(),
        keras.layers.Dense(128, activation="relu"),  # 은닉 유닛 128개
        keras.layers.BatchNormalization(),
        keras.layers.Dense(10),  # 클래스 10개의 로짓 출력
    ]
)
레이블 스무딩
레이블 스무딩은 정답 클래스에 1, 나머지 클래스에 0을 요구하는 단단한 목표를 완화하는 방법.
원-핫 인코딩
- 원-핫 인코딩(one-hot encoding): 범주형 값을 범주 수와 같은 길이의 벡터로 표현
- 해당 범주의 원소 하나만 1(hot), 나머지 원소는 0(cold)
- 신문 기사를 정치, 사회, 경제, 문화 네 범주로 분류하는 예:
- 정치: (1,0,0,0)
- 사회: (0,1,0,0)
- 경제: (0,0,1,0)
- 문화: (0,0,0,1)
- 기준 범주 하나를 제외한 K−1개 열로 표현하는 방식은 더미 코딩(dummy coding)
- 정치를 기준 범주로 제외하면 정치가 (0,0,0), 사회가 (1,0,0)
- 더미 코딩은 기준 범주가 필요한 선형 모형에서 주로 사용하며, 레이블 스무딩에는 K개 원소의 원-핫 벡터 사용
스무딩 계산
- 잘못 표시되거나 예외적인 훈련 사례에 모델이 과도하게 확신하는 현상을 완화
- 원-핫 레이블과 모든 클래스의 확률이 같은 균등 분포를 혼합
- 클래스 수가 K이고 스무딩 비율이 α일 때의 변환:
- K=4, α=0.15인 예: (1,0,0,0)→(0.8875,0.0375,0.0375,0.0375)
Keras 적용
keras.losses.BinaryCrossentropy(label_smoothing=0.15)  # 이항 분류 레이블을 15% 스무딩
keras.losses.CategoricalCrossentropy(label_smoothing=0.15)  # 다항 분류 레이블을 15% 스무딩
BinaryCrossentropy는 스칼라 정답 0과 1을 각각 0.5 쪽으로 완화CategoricalCrossentropy는 원-핫 레이블에 위의 K개 클래스 변환을 적용keras.losses.SparseCategoricalCrossentropy에는label_smoothing인자가 없음- 정수 레이블을 스무딩하려면 원-핫 벡터로 변환한 뒤
CategoricalCrossentropy사용
퀴즈
정칙화의 주된 목적은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.