
오토인코더
지도 학습 vs. 비지도 학습
- 지도 학습 supervised learning
- 일종의 정답이 있는 상태에서, 모델로 하여금 그 정답을 예측하도록 학습
- X → Y 관계의 데이터에서 X로 Y를 예측(이미지 분류, 객체 인식 등)
- X와 Y, 두 가지 데이터가 필요
- Y에 해당하는 데이터가 반드시 필요하나 구하기 어려울 수도 있음
- 예: 맛집 리뷰(X)가 진짜(Y)인가?
- 비지도 학습 unsupervised learning
- 데이터 구조와 관계를 파악하여 유용한 정보를 추출하는 것
- 예) 인터넷 옷 쇼핑몰에서 비슷한 디자인 추천
- 지도학습과 달리 데이터에 Y가 없음
- 활용 결과를 바탕으로 판단
이미지 압축
- 이미지 압축은 사진이나 그림 파일의 크기를 줄이는 기술
- 저장 공간을 절약하고, 이미지를 빠르게 전송할 수 있음
- 흔히 사용하는 GIF와 JPG에도 이미지가 압축되어 있음
- 기존의 압축 방식은 고정된 알고리즘을 사용
JPEG의 압축 방법(1)
- 색공간 변환(RGB → YCbCr): Y는 밝기, Cb, Cr은 색상.
- 크로마 서브샘플링(chroma subsampling): 사람은 밝기에 민감하므로 Y는 보존, Cb, Cr을 압축
- 인접한 픽셀에서 일부 색상만 남김
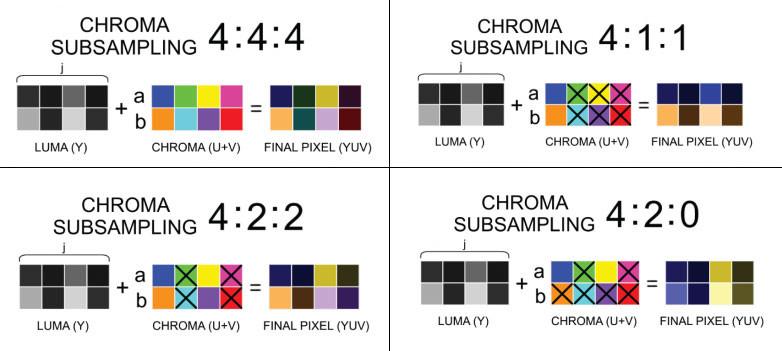
JPEG의 압축 방법(2)
- 블록 분할(block splitting): 채널을 일정 크기(예: 8x8)의 블록으로 분할
- 이산 코사인 변환(discrete cosine transform): 각 블록의 이미지를 주파수로 변환
- 양자화(Quantization): 주파수 영역의 계수들을 상수로 나눈 후, 반올림
- 실수 → 정수로 바뀜
- 고주파 영역을 큰 상수로 나누어 압축율을 높임
- 일반적인 비손실 압축 알고리즘(Run-length encoding, Huffman coding 등)을 적용
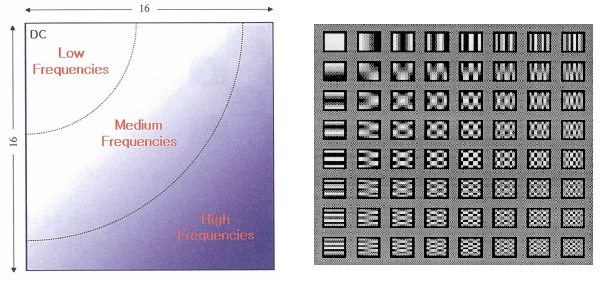
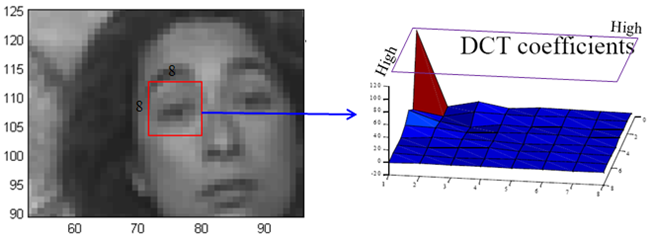
JPEG 압축 방식의 문제점
- 손실 압축이므로 이미지의 화질이 열화됨
- 이미지의 종류와 상관없이 일괄적으로 고주파 영역을 깎아냄
- 이미지의 '의미'가 보존되지 않음
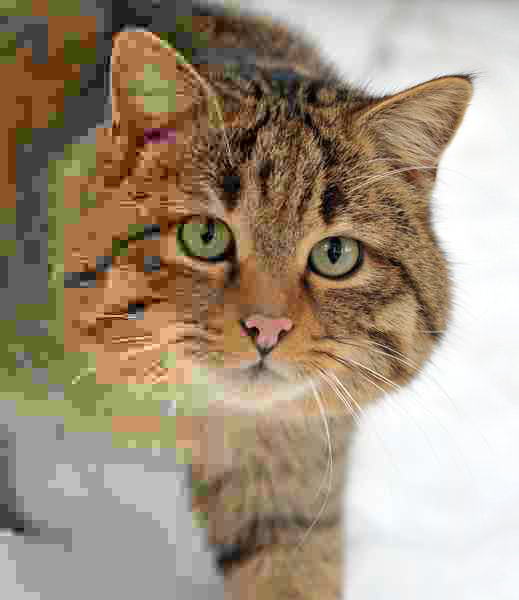
오토인코더 autoencoder
- 비지도 학습을 이용하면 이미지의 특성을 이용하여 압축할 수 있음
- 오토인코더: 신경망 기반 비지도학습 모델
- 이미지를 입력받아 간략한 표현(압축된 형태)을 생성한 뒤, 그 표현을 사용해 원본 이미지를 복원
- 오토인코더는 인코더와 디코더로 구성
- 인코더 encoder: 이미지를 간단한 표현으로 압축하는 역할
- 디코더 decoder: 압축된 표현을 다시 원래 이미지로 복원하는 역할
- 학습 과정에서는 원본 이미지와 복원된 이미지 사이의 차이를 줄이는 방향으로 모델이 개선
- 비지도 학습을 이용한 이미지 압축의 경우, 오토인코더는 원본 이미지만 가지고 학습을 진행
- 학습이 끝난 후에는 인코더로 이미지를 압축, 디코더로 이미지를 복원
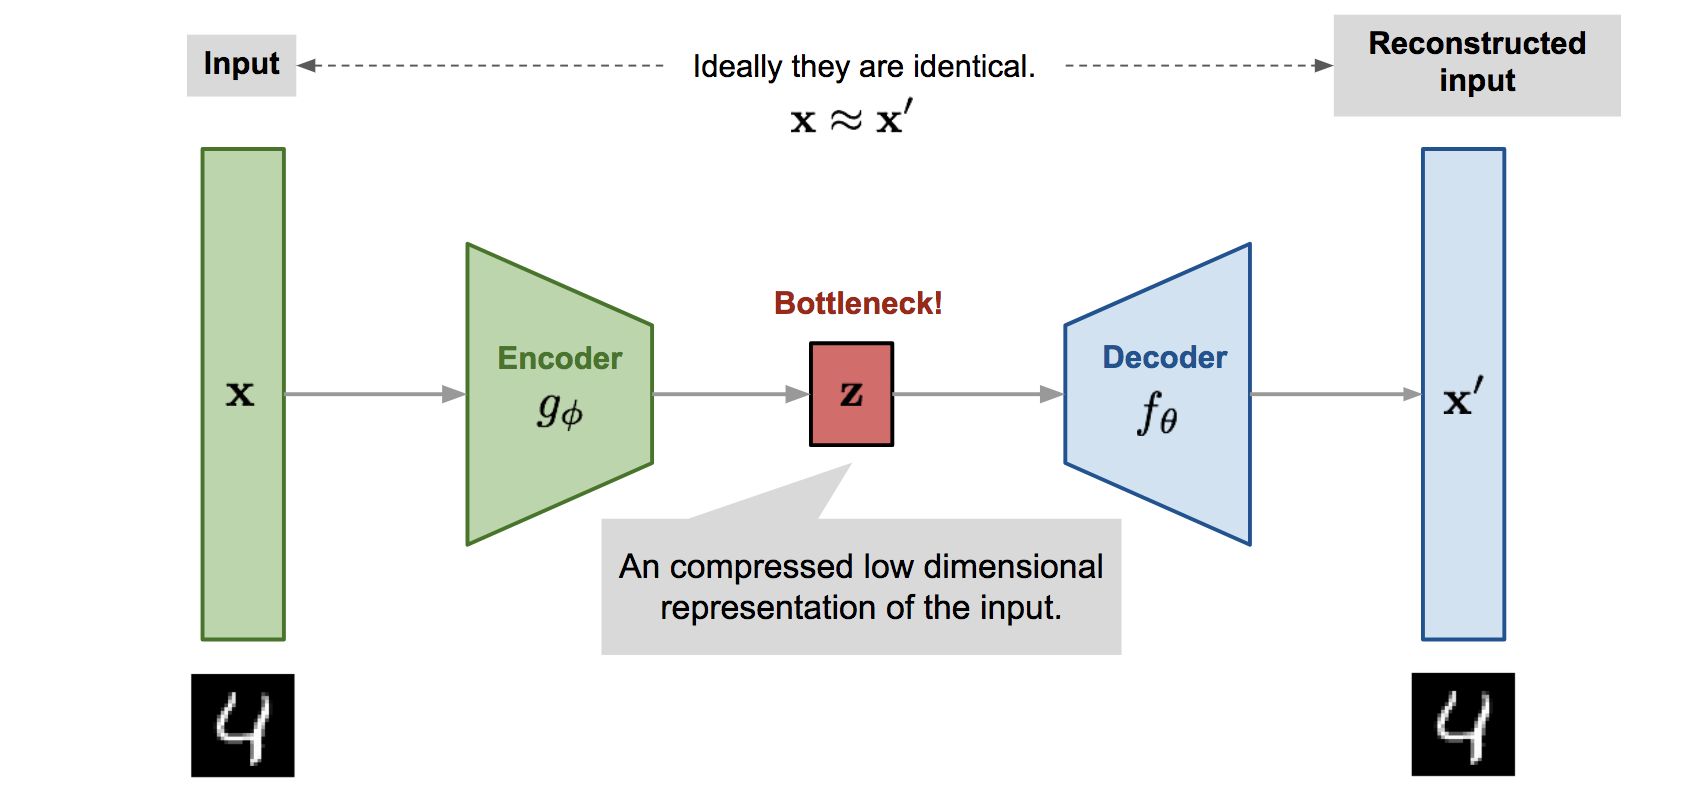
오토인코더
- 오토인코더의 학습에는 사람이 붙여준 레이블이 없음
- 지도학습에서는 이미지 X와 레이블 Y가 필요
- 오토인코더와 같은 비지도 학습에서는 이미지 X만 필요
- 지도와 비지도는 이 레이블 Y가 있느냐 없느냐를 나타냅니다.
- 오토인코더는 이미지의 화질을 떨어트리지 않으면서 효율적으로 압축하기 위해 이미지가 가진 패턴들을 학습해야 함
- 오토인코더는 응용하기에 따라 이미지 압축 외의 용도로도 쓸 수 있음
- 예) 노이즈 제거
- 원본 이미지에 노이즈를 넣어서 오토인코더에 입력
- 압축을 했다가 푼 다음에 복원된 결과물이 노이즈가 없는 원본과 비슷하도록 학습
- 이렇게 하면 오토인코더를 거치면 노이즈가 제거되도록 학습시킬 수 있음
준비
keras.utils.set_random_seed(42)

(x_train, _), (x_test, _) = keras.datasets.mnist.load_data()

input_dim = 784
latent_dim = 32 # 압축 차원: 784 -> 32
인코더
encoder = keras.Sequential([
    keras.layers.Rescaling(1/255), # 입력 값의 범위를 0~1로
    keras.layers.Flatten(), # 이미지 평탄화
    keras.layers.Dense(128, activation="relu"),
    keras.layers.Dense(latent_dim, activation="relu", name="compressed")
], name="encoder")
디코더
decoder = keras.Sequential([
    keras.layers.Dense(128, activation="relu", input_shape=(latent_dim,)),
    keras.layers.Dense(input_dim, activation="sigmoid"),
    keras.layers.Reshape((28, 28))
], name="decoder")
오토인코더
inputs = keras.Input(shape=(28, 28), name="image")
z = encoder(inputs)
outputs = decoder(z)

autoencoder = keras.Model(inputs, outputs, name="mnist_autoencoder")

autoencoder.compile(optimizer="adam", loss="binary_crossentropy")
훈련
y_train = x_train / 255.0
y_test = x_test / 255.0

history = autoencoder.fit(
    x_train,
    y_train, # 입력과 정답이 같음(스케일링만 추가)
    epochs=5,
    batch_size=256,
    shuffle=True,
    validation_data=(x_test, y_test)
)
압축과 복원
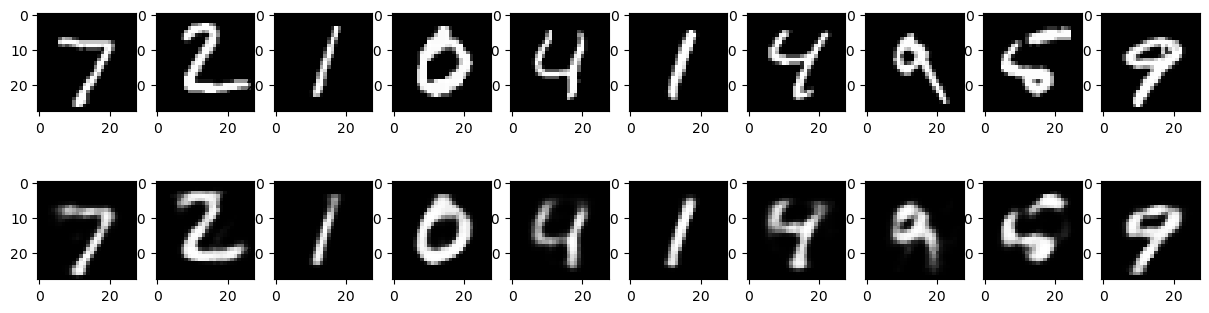
compressed = encoder.predict(x_test[:10])  # 압축
reconstructed = autoencoder.predict(x_test[:10]) # 복원
시각화
import matplotlib.pyplot as plt

n = 10
plt.figure(figsize=(15, 4))

for i in range(n):
    ax = plt.subplot(2, n, i + 1)
    plt.imshow(x_test[i].reshape(28, 28), cmap="gray")
    ax = plt.subplot(2, n, i + 1 + n)
    plt.imshow(reconstructed[i].reshape(28, 28), cmap="gray")
퀴즈
지도 학습과 비지도 학습을 구분하는 핵심 기준은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.