합성곱 신경망
이미지와 Dense 레이어의 한계
이미지는 높이, 너비, 채널을 가진 (H,W,C) 형태. 다층 신경망으로 이미지를 분류하려면 Flatten으로 이미지를 길이 H×W×C인 벡터로 펼친 뒤 Dense 레이어에 입력. 이 방식에는 세 가지 한계가 있음.
파라미터가 너무 많음
Dense 레이어는 모든 입력을 각 뉴런에 연결하므로 출력 뉴런이 U개이면 (H×W×C)×U+U개의 파라미터가 필요.
| 입력 | 레이어 | 파라미터 수 |
|---|---|---|
| 28×28 흑백 이미지 | Dense(128) | 100,480 |
| 224×224 컬러 이미지 | Dense(1000) | 150,529,000 |
| 크기와 무관한 흑백 이미지 | 3×3 합성곱 필터 32개 | 320 |
| 크기와 무관한 컬러 이미지 | 3×3 합성곱 필터 32개 | 896 |
- Dense의 파라미터 수는 이미지가 커질수록 함께 증가
- 파라미터가 많으면 계산량과 메모리가 늘고, 적은 데이터에서는 과대적합 위험이 커짐
이웃한 픽셀의 관계를 사용하지 않음
Flatten은 픽셀값을 삭제하지 않지만 높이·너비 축을 하나의 축으로 펼침. Dense 레이어는 펼친 벡터에서 어떤 픽셀끼리 이웃했는지 구분하지 않음.
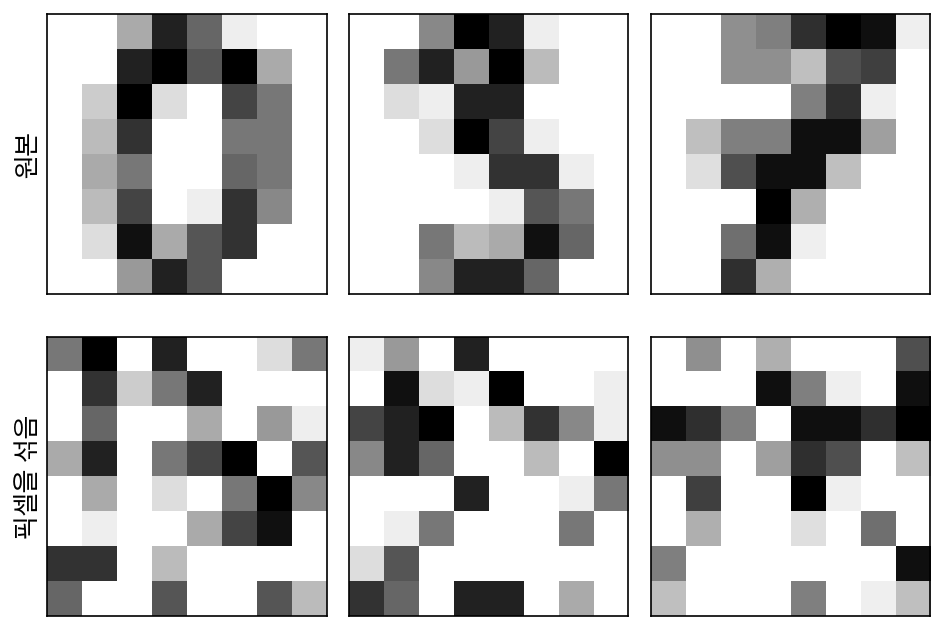
- 모든 이미지의 픽셀을 같은 규칙으로 섞으면 사람은 숫자를 알아볼 수 없음
- Dense 레이어는 가중치의 순서만 바뀐 같은 모델을 학습할 수 있으므로 섞기 전과 성능이 같음
- Dense 레이어가 이미지의 공간 구조를 활용하지 못한다는 뜻
위치가 바뀌면 다시 학습해야 함
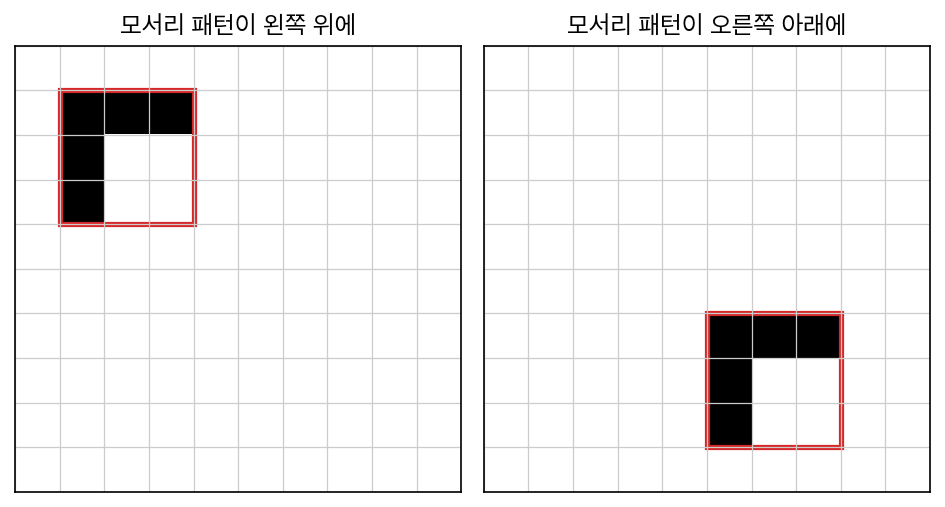
- 이미지에서는 같은 패턴이 여러 위치에 나타남
- Dense 레이어는 위치마다 다른 가중치를 사용하므로 왼쪽 위에서 배운 패턴을 오른쪽 아래에 그대로 적용하지 못함
- 패턴이 나타날 수 있는 위치마다 학습 데이터가 필요
이미지의 성질과 CNN의 설계
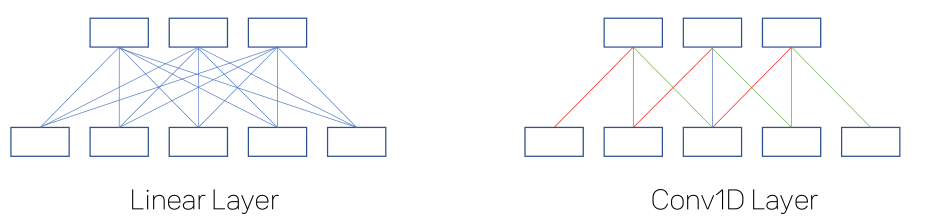
합성곱 신경망(convolutional neural network, CNN)은 이미지의 성질을 구조에 반영해 Dense 레이어의 한계를 줄인 신경망.
| 이미지의 성질 | CNN의 설계 |
|---|---|
| 가까운 픽셀끼리 관련이 큼 | 작은 필터의 지역 연결 |
| 같은 패턴이 여러 위치에 나타남 | 모든 위치에서 같은 필터를 사용하는 가중치 공유 |
| 작은 패턴이 모여 큰 패턴이 됨 | 합성곱 레이어를 여러 층으로 쌓기 |
| 조금 이동하거나 작아져도 같은 물체 | 풀링 |
이미지 처리의 블러나 엣지 검출 필터는 사람이 값을 정함. CNN은 필터의 값을 데이터에서 학습.
합성곱 레이어
- 합성곱 신경망은 작은 지역 패치에 필터를 반복 적용해 특징을 추출
- 필터(filter) 또는 커널(kernel)은 데이터에서 학습하는 가중치
- 같은 필터를 이미지의 여러 위치에서 공유하므로 지역 패턴을 효율적으로 탐색
- 필터 하나는 하나의 피처 맵을 생성하며, 필터 수는 출력 채널 수와 같음
- 수용 영역(receptive field): 특정 뉴런의 값에 영향을 주는 원본 입력 영역
- 피처 맵(feature map): 필터가 각 위치에서 계산한 합성곱 출력
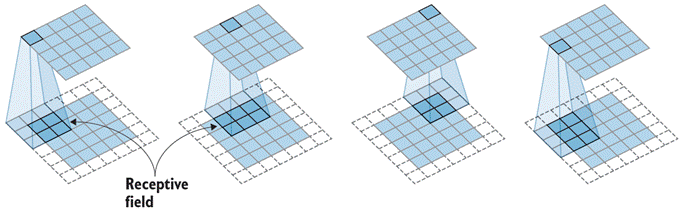
합성곱 계산 예시
필터를 입력의 3×3 패치에 겹쳐 같은 위치의 값끼리 곱한 뒤 모두 더함. 필터를 한 칸씩 옮기며 반복하면 피처 맵 완성.
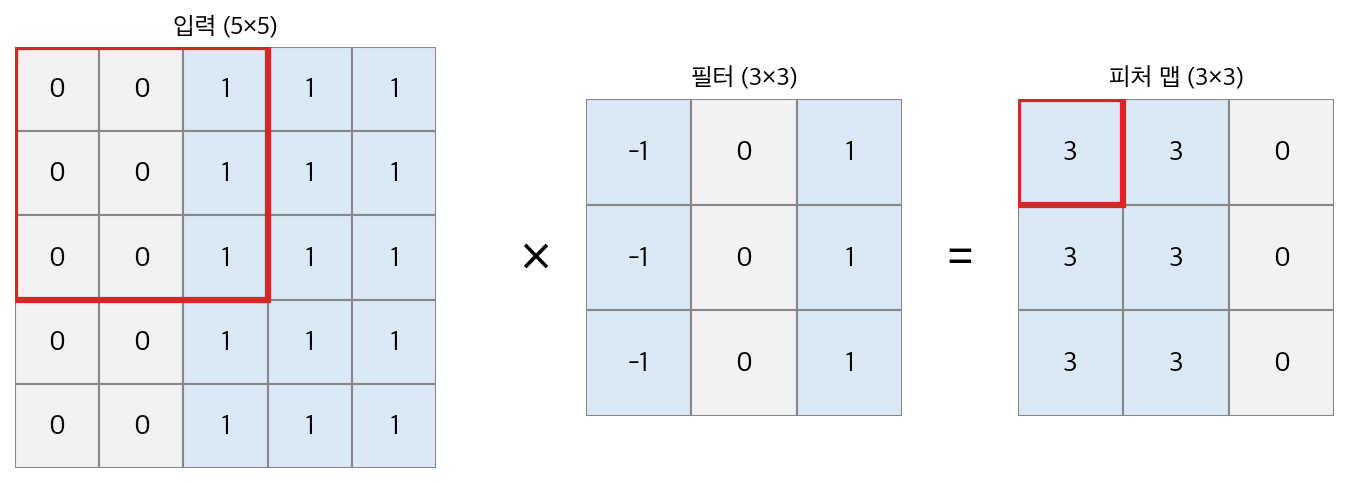
- 빨간 패치의 계산: 각 행에서 0×(−1)+0×0+1×1=1, 세 행의 합은 3
- 필터의 왼쪽 열은 −1, 오른쪽 열은 1이므로 왼쪽보다 오른쪽이 밝은 세로 경계에서 큰 값 출력
- 값이 일정한 영역에서는 0 출력
- 같은 필터가 모든 위치에 적용되므로 경계가 이미지 어디에 있어도 같은 방식으로 반응
채널과 파라미터 수
- 입력 채널이 Cin개이면 필터 하나의 크기는 k×k×Cin
- 채널마다 곱해 더한 값을 다시 모두 더해 피처 맵 하나 생성
- 필터가 Cout개이면 출력 채널도 Cout개
- 합성곱 레이어의 파라미터 수: (k×k×Cin+1)×Cout
- 예: 흑백 입력에 3×3 필터 32개 → (3×3×1+1)×32=320
- 이미지의 높이와 너비는 파라미터 수에 영향을 주지 않음
부분 특징에서 전체 특징으로
- 얕은 레이어는 선, 방향, 모서리 같은 낮은 수준의 특징을 추출
- 다음 레이어는 앞에서 찾은 특징을 조합해 눈, 코, 입처럼 더 큰 패턴을 표현
- 깊은 레이어는 부분 특징을 다시 조합해 얼굴이나 사물 전체에 가까운 특징을 표현
- 실제로 학습되는 특징은 데이터와 학습 목표에 따라 달라짐
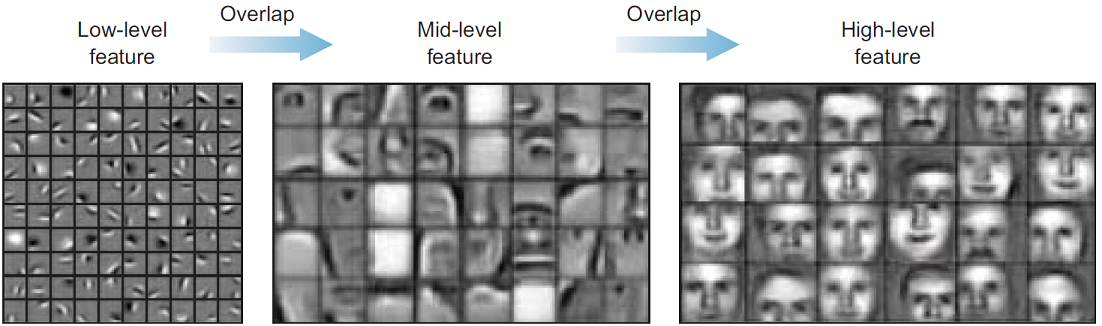
층을 쌓을수록 수용 영역이 넓어지기 때문에 가능한 변화.
- 3×3 합성곱 한 층: 원본의 3×3 영역을 봄
- 3×3 합성곱 두 층: 두 번째 층의 값 하나는 첫 층의 3×3 값에 의존하고, 그 값들은 원본의 5×5 영역에 의존
- 3×3 합성곱 세 층: 원본의 7×7 영역
- 풀링으로 공간 크기를 줄이면 이후 레이어의 수용 영역이 더 빠르게 넓어짐
풀링 pooling
- 풀링은 피처 맵의 지역 값을 요약해 공간 크기를 줄이는 다운샘플링
- 학습하는 가중치가 없으며 합성곱 레이어 수를 자동으로 줄이지 않음
- 공간 크기가 줄어 이후 레이어의 연산량과 Dense 레이어의 파라미터 수를 줄일 수 있음
- 세부 위치 정보가 손실되므로 위치가 중요한 작업에서는 성능에 영향을 줄 수 있음
- 최대 풀링(max pooling)은 지역의 최댓값을 선택
- 평균 풀링(average pooling)은 지역의 평균값을 계산
4×4 피처 맵에 2×2 풀링을 적용하면 겹치지 않는 2×2 지역마다 값 하나를 남겨 2×2 출력 생성.
| 입력 (4×4) | 최대 풀링 (2×2) | 평균 풀링 (2×2) |
|---|---|---|
| 1430361225141023 | [6354] | [3.51.522.5] |
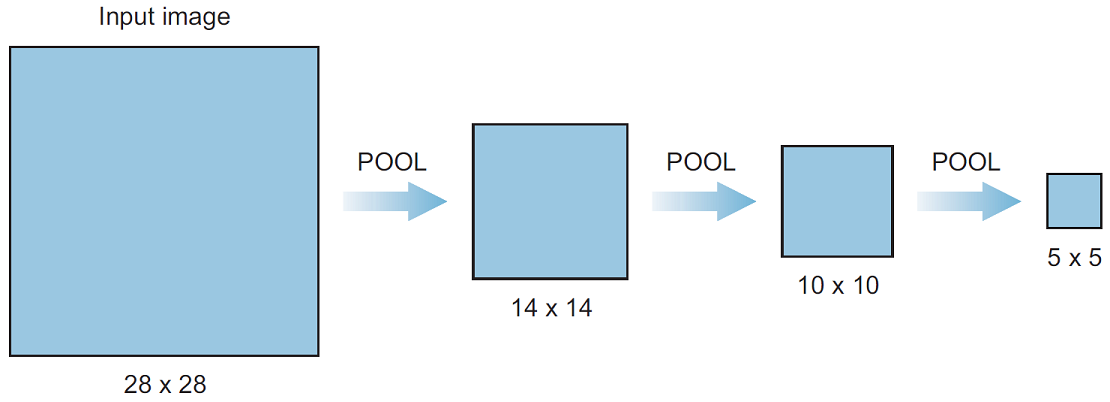
이미지를 작게 줄여도 같은 글자로 알아볼 수 있듯이, 풀링은 세부 위치를 일부 버리고 특징이 있는지를 남김. 그래서 특징의 위치가 조금 바뀌어도 출력이 크게 달라지지 않음.
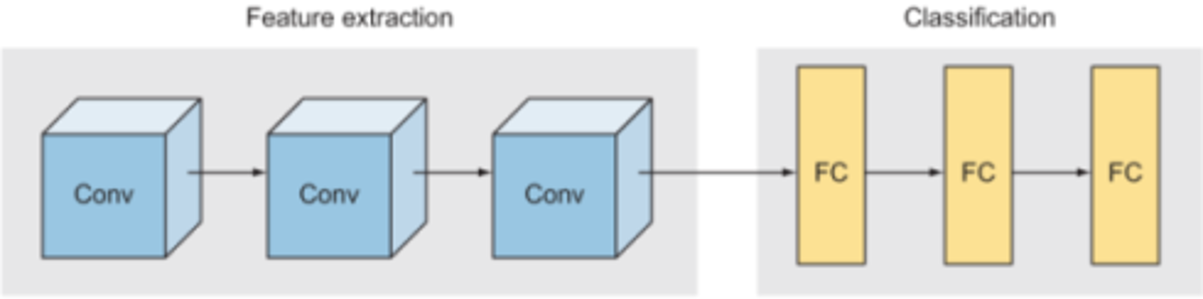
CNN의 기본 구조
- 특징 추출 부분: 합성곱, 활성화 함수, 필요에 따른 풀링
- 분류 부분:
Flatten또는 전역 풀링으로 특징을 모은 뒤 Dense 레이어로 예측 Flatten은 한 가지 연결 방법이며 모든 CNN에 필수인 것은 아님
퀴즈
모든 이미지의 픽셀 위치를 같은 규칙으로 섞은 뒤 Flatten과 Dense 레이어로 이루어진 모델을 학습하면 어떻게 되는가?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.