
딥러닝 프레임워크
머신러닝을 위한 기본 라이브러리
머신러닝에서는 목적에 따라 여러 라이브러리를 함께 사용.
- 넘파이(NumPy): 다차원 배열과 벡터화된 수치 연산 제공. 데이터 전처리와 결과 검증에도 널리 사용
- 딥러닝에 필요한 GPU 텐서, 자동 미분, 신경망 훈련 루프는 직접 제공하지 않음
- 판다스(pandas): 표 형태 데이터의 불러오기, 저장, 정렬, 결측값 처리, 필터링 제공
- 사이킷런(scikit-learn): 전처리, 전통적 머신러닝 모델, 모델 선택, 평가 도구 제공
CPU와 GPU
중앙처리장치(CPU)는 소수의 강력한 코어로 운영체제 실행, 조건 분기, 순차 작업 등 다양한 계산을 처리. CPU도 멀티코어와 벡터 명령을 이용해 병렬 계산 가능.
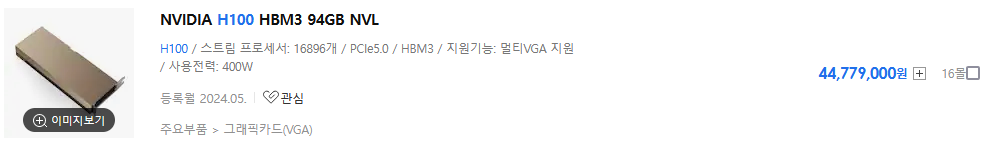
그래픽 처리 장치(GPU)는 많은 연산 장치로 같은 종류의 계산을 대량으로 수행하는 데 유리. 딥러닝의 행렬곱과 합성곱은 이러한 병렬 처리에 잘 맞음.
- CPU: 복잡한 제어 흐름과 작은 작업에 유리
- GPU: 충분히 큰 텐서의 반복적인 수치 계산에 유리
- 데이터 전송과 연산 준비에도 시간이 들므로 작은 작업에서는 GPU가 항상 빠른 것은 아님
기억 장치
컴퓨터의 기억 장치(memory)는 속도, 용량, 위치가 서로 다름.
- 레지스터(register): 프로세서 내부의 매우 작고 빠른 저장 공간
- 캐시 메모리(cache memory): 프로세서가 자주 쓰는 데이터를 보관하는 고속 저장 공간
- 주기억 장치(RAM): 실행 중인 프로그램과 데이터를 보관하는 메모리
- 스토리지(storage): 전원이 꺼져도 데이터를 유지하는 HDD 또는 SSD
- 비디오 메모리(VRAM): GPU가 계산에 사용하는 메모리
Apple Silicon은 CPU와 GPU가 통합 메모리를 공유.
모델 가중치에 필요한 최소 메모리는 다음과 같이 추정.
가중치 메모리=파라미터 수×파라미터당 바이트 수예를 들어 파라미터가 700억 개인 모델의 가중치만 저장해도 BF16 또는 FP16에서는 약 140 GB, INT8에서는 약 70 GB, 4비트 양자화에서는 이론상 약 35 GB 필요. 실제 추론에는 임시 텐서와 캐시가 더 필요하며, 훈련에는 그래디언트, 옵티마이저 상태, 활성화값이 추가되어 더 많은 메모리 필요.
딥러닝 프레임워크
딥러닝 프레임워크는 텐서 연산, GPU 같은 가속기 사용, 자동 미분, 신경망 계층, 최적화 도구를 하나의 학습 흐름으로 제공.
- 텐서플로(TensorFlow): 구글이 개발. 모델 학습부터 다양한 실행 환경으로 내보내는 도구까지 제공
- 파이토치(PyTorch): 메타가 시작한 오픈 소스 프로젝트. 파이썬과 자연스럽게 연결되는 텐서 연산, 자동 미분, 신경망 API 제공
- JAX: 구글이 개발. NumPy와 비슷한 연산에 자동 미분, 컴파일, 벡터화 같은 함수 변환 결합
- 케라스(Keras): 모델 정의와 훈련을 간결하게 작성하는 고수준 API. Keras 3는 TensorFlow, PyTorch, JAX를 백엔드로 지원
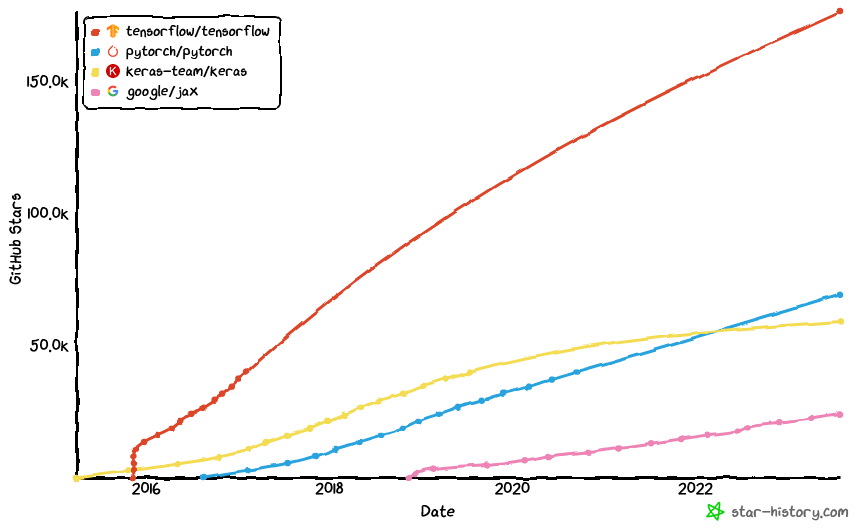
많은 공개 연구 코드와 사전학습 모델 도구가 PyTorch 구현을 제공하므로 최신 모델을 재현할 때 PyTorch가 유리한 경우가 많음.
퀴즈
딥러닝 프레임워크가 하나의 학습 흐름에 제공하는 기능 조합으로 가장 알맞은 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.