
제어 문제
가치 기반 강화학습
- 각 상태나 행동이 얼마나 좋은지를 나타내는 "가치"를 학습하는 방법
- 에이전트는 가치가 높은 행동을 선택하려고 한다.
- 대표 방법: Q-learning, SARSA, Deep Q-Network
작동 방식
- 행동을 해보고 보상을 관찰
- "이 상태에서 이 행동은 얼마나 좋은가"를 업데이트
- 시간이 지나며 더 높은 가치를 주는 행동을 선택
특징
- 비교적 직관적이고 안정적인 경우가 많음
- 가능한 행동이 명확한 문제에 적합
- 연속적인 행동 공간에서는 적용이 어려울 수 있음
정책 기반 강화학습
- 가치함수를 먼저 추정하기보다, 어떤 행동을 선택할지에 대한 정책 자체를 학습하는 방법
- 정책은 상태를 입력받아 행동을 선택하는 규칙이다.
- 대표 방법: Policy Gradient, Actor-Critic, PPO
작동 방식
- 현재 정책으로 행동을 선택
- 누적 보상을 계산
- 보상이 높았던 행동은 더 자주 선택되도록 조정
- 보상이 낮았던 행동은 덜 선택되도록 조정
특징
- 연속적인 행동을 다루기 좋음
- 복잡한 전략을 직접 학습할 수 있음
- 학습이 불안정하거나 많은 데이터가 필요할 수 있음
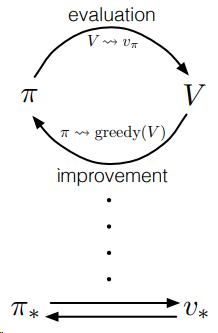
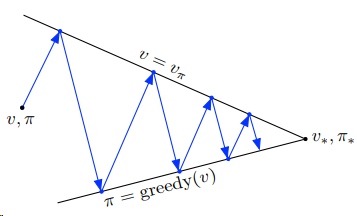
일반화된 정책 반복 Generalized Policy Iteration
- 세부 사항에 관계없이 정책 평가와 정책 개선 프로세스가 상호 작용하여 최적 정책을 찾는 일반적 아이디어
- 정책에 대한 평가
- 가치 함수에서 탐욕적으로 정책을 개선
몬테카를로 제어와 SARSA
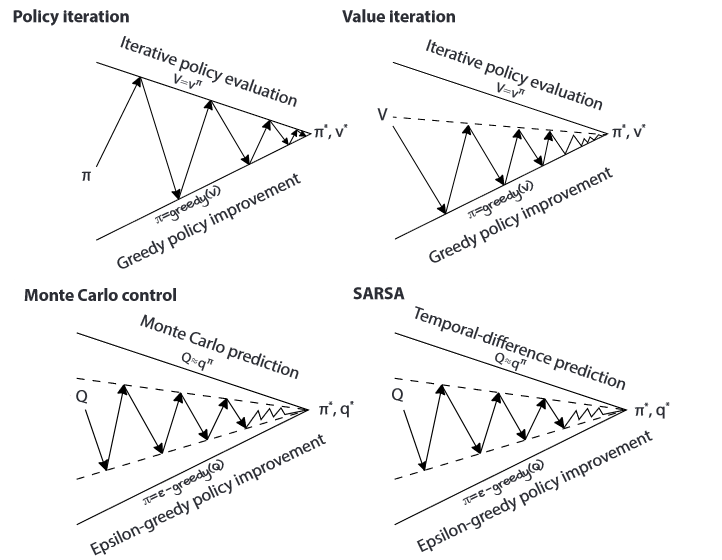
- 마코프 결정 과정(MDP)에 대해 모르면 정책 반복을 쓸 수 없음
- 몬테카를로 제어
- 첫 방문 몬테카를로를 사용해서 행동 가치함수 Q(s,a)를 추정
- 입실론 탐욕법 전략으로 탐색
- SARSA: 몬테카를로 예측 대신 시간차 학습을 사용
- St,At,Rt,St+1,At+1에서 이름을 따옴(별 의미 없음) -> "On-Policy TD 제어"
MC 제어
class MCControl(MCPrediction):
    def __init__(self, env, gamma=0.9, epsilon=0.1):
        super().__init__(env, gamma)
        self.epsilon = epsilon  # Exploration rate
        self.Q = np.zeros((env.observation_space.n, env.action_space.n))
        self.returns = defaultdict(list)

    def select_action(self, policy, state):
        if np.random.rand() < self.epsilon:
            return self.env.action_space.sample()
        else:
            return np.argmax(self.Q[state])

    def update_value(self, episode):
        G = 0
        for t in reversed(range(len(episode))):
            state, action, reward, next_state, done = episode[t]
            G = self.gamma * G + reward
            if (state, action) not in [(x[0], x[1]) for x in episode[:t]]:
                self.returns[(state, action)].append(G)
                self.Q[state][action] = np.mean(self.returns[(state, action)])

    def improve_policy(self):
        policy = {}
        for state in range(self.env.observation_space.n):
            policy[state] = np.argmax(self.Q[state])
        return policy

    def evaluate_policy(self, policy, num_episodes=1000):
        nS = self.env.observation_space.n
        nA = self.env.action_space.n
        self.Q_track = np.zeros((nS, nA, num_episodes))
        for e in range(num_episodes):
            episode = self.generate_episode(policy)
            self.update_value(episode)
            self.Q_track[:, :, e] = self.Q.copy()
        return self.Q, self.Q_track

    def control(self, policy, num_episodes=1000):
        for _ in range(num_episodes):
            episode = self.generate_episode()
            self.update_value(episode)
        return self.improve_policy()
실험
agent = MCControl(env)
pi = random_policy(env)
agent.evaluate_policy(pi)
pi = agent.improve_policy()
pi
SARSA
class SARSA(MCControl):
    def __init__(self, env, gamma=0.9, alpha=0.1, epsilon=0.1):
        super().__init__(env, gamma, epsilon)
        self.alpha = alpha

    def generate_episode(self, policy):
        episode = []
        state, info = self.env.reset()
        action = self.select_action(policy, state)
        done = False
        while not done:
            next_state, reward, done, _, _ = self.env.step(action)
            next_action = self.select_action(policy, next_state)
            episode.append((state, action, reward, next_state, next_action, done))
            state, action = next_state, next_action
        return episode

    def update_value(self, episode):
        for t in range(len(episode)):
            state, action, reward, next_state, next_action, done = episode[t]
            td_target = reward + (self.gamma * self.Q[next_state][next_action] * (not done))
            td_error = td_target - self.Q[state][action]
            self.Q[state][action] += self.alpha * td_error

    def control(self, policy, num_episodes=1000):
        for _ in range(num_episodes):
            episode = self.generate_episode(policy)
            self.update_value(episode)
        return self.improve_policy()
퀴즈
가치 기반 강화학습의 핵심 설명으로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.