
입실론 탐욕법
입실론 탐욕법 epsilon greedy method
- 가장 가치가 높은 행동을 주로 선택하는 활용 중심 전략
- 매번 일정 비율(ε, epsilon)만큼 탐색하고 그 외에는 활용
- 예시:
- 주사위를 굴려서 1이 나오면 무작위로 아무 슬롯머신이나 당겨보고, 그 외에는 이제까지 가치가 가장 높은 슬롯 머신을 당긴다
- 20%의 고객에게는 A안과 B안 중에 무작위로 보여주지만, 나머지 80%의 고객에게는 이제까지 가치가 가장 높은 디자인을 보여준다
아래 코드는 멀티 암드 밴딧 강의에서 정의한 EpsilonFirstAgent와 env를 이어서 사용한다.
입실론 탐욕법
class EpsilonGreedyAgent(EpsilonFirstAgent):
    def select_action(self, episode):
        if np.random.rand() < self.epsilon:
            return self.env.action_space.sample()  # 탐색
        else:
            return np.argmax(self.Q)  # 활용

agent = EpsilonGreedyAgent(env, epsilon=0.1)
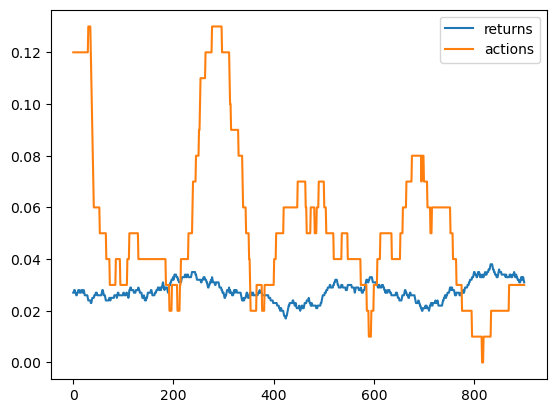
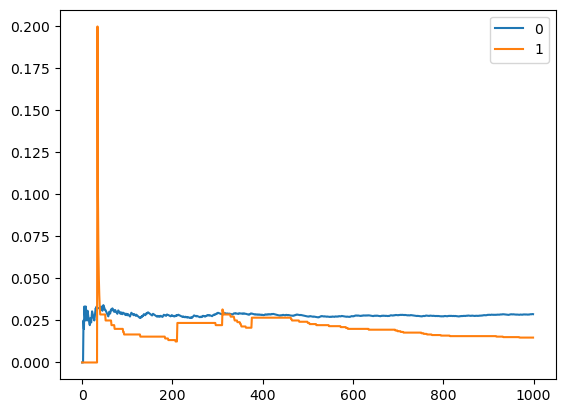
returns, Q_history, actions = agent.run()
시각화
감쇠 입실론 탐욕법
- 행위자가 환경에 대해 충분히 탐색하지 못한 초기에는 탐색을 많이
- 후반에는 탐색을 적게 하는 방법
- 탐색 비율(ε)을 서서히 감쇠(decaying)
- 감쇠 방법
- 1/N
- 사인 함수
- 에피소드마다 같은 폭으로 줄임
- 에피소드마다 같은 비율로 줄임
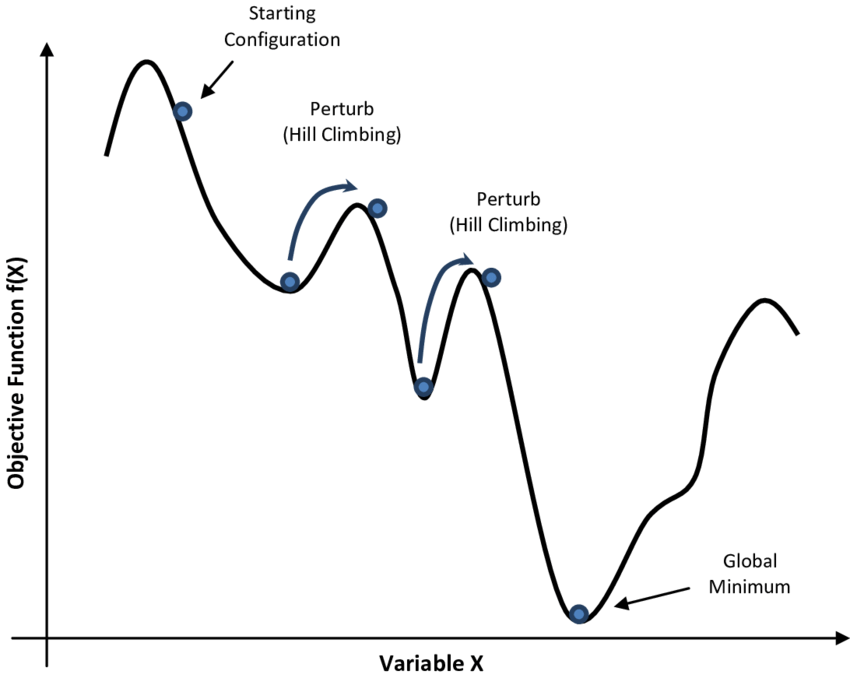
모의 담금질 Simulated Annealing
- 전역 최적화를 찾기 위한 확률적 기법
- 물리학의 담금질: 금속을 고온으로 가열한 후 서서히 냉각하여 물질의 구조를 안정화하는 과정
- SA 알고리즘은 초기 고온에서 시작하여 서서히 온도를 낮추며 최적해를 찾아가는 방식
감쇠 입실론 탐욕법 (선형적)
class LinearlyDecayingEpsilonGreedyAgent(EpsilonGreedyAgent):
    def __init__(self, env, initial_epsilon, min_epsilon, decay_rate,
                 n_episodes=1000):
        super().__init__(env, initial_epsilon, n_episodes)
        self.initial_epsilon = initial_epsilon
        self.min_epsilon = min_epsilon
        self.decay_rate = decay_rate
        self.epsilon = initial_epsilon
        self.total_steps = 0
        # 계속
감쇠 입실론 탐욕법 (선형적)
def decay_epsilon(self):
    self.epsilon = max(self.min_epsilon, self.epsilon - self.decay_rate)

def select_action(self, episode):
    self.decay_epsilon()
    self.total_steps += 1
    if np.random.rand() < self.epsilon:
        return self.env.action_space.sample()  # 탐색
    else:
        return np.argmax(self.Q)  # 활용
감쇠 입실론 탐욕법 실험
agent = LinearlyDecayingEpsilonGreedyAgent(
    env,
    initial_epsilon=0.1,  # 처음에는 10%의 경우에 탐색
    min_epsilon=0.01,     # 최종적으로 1%의 경우에만 탐색
    decay_rate=0.001,     # 0.1%p씩 탐색 비율을 줄임
)
returns, Q_history, actions = agent.run()
감쇠 입실론 탐욕법 (지수적)
class ExponentiallyDecayingEpsilonGreedyAgent(LinearlyDecayingEpsilonGreedyAgent):
    def decay_epsilon(self):
        self.epsilon = max(self.min_epsilon, self.epsilon * (1 - self.decay_rate))
- 같은 %p만큼 탐색을 줄이는 대신, 일정 비율로 줄임
상황이 변할 경우
- 평균 공식에서 가치는 새로운 데이터에 1/N만큼만 영향
- 데이터가 쌓일수록 N이 증가하므로 새로운 데이터에 받는 영향이 감소
- 기존 데이터가 많이 누적되면 상황이 변하더라도 반영이 잘 되지 않음
- 여름에 많은 데이터가 쌓여 있을 경우 겨울이 되어도 새로운 데이터가 상대적으로 적으므로 B의 가치가 A의 가치를 빨리 따라잡지 못함
| 계절 | A의 가치 | B의 가치 |
|---|---|---|
| 여름 | 20 | 10 |
| 겨울 | 12 | 15 |
지수이동평균 exponential moving average
Vn←Vn−1+α(Rn−Vn−1)- 새로운 데이터가 주는 영향을 1/N에서 α로 고정 (0<α<1)
- 기존 데이터가 남긴 영향은 점점 지수적으로 사라짐
- α가 클수록 새로운 데이터에 민감
- 입실론 탐욕법 + 지수이동평균의 파라미터
- ε: 크면 탐색을 많이, 작으면 활용을 많이
- α: 크면 최근 데이터에 민감
- 전체 보상이 극대화되도록 두 가지를 조정
낙관적 초기화
- 각 대안의 초기 가치를 낙관적으로 크게 산정
- 적게 탐색한 대안은 초기 가치가 많이 반영되어 있으므로 가치가 높음
- 입실론 탐욕법은 가치가 높은 대안을 주로 활용
- 자연스럽게 적게 탐색한 대안을 더 많이 탐색
낙관적 초기화
class OptimisticInitializationAgent(EpsilonGreedyAgent):
    def __init__(self, env, optimistic_estimate, initial_count, n_episodes=1000):
        super().__init__(env, 0, n_episodes)
        self.optimistic_estimate = optimistic_estimate
        self.initial_count = initial_count
        self.Q = np.full(env.action_space.n, self.optimistic_estimate)
        self.N = np.full(env.action_space.n, self.initial_count, dtype=int)
        # Q는 낙관적 추정치로, N은 초기 값으로 채움
퀴즈
ε=0.1인 입실론 탐욕법의 행동 선택 방식으로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.