
멀티 암드 밴딧
Multi-Armed Bandit
-
슬롯머신이 여러 개 있을 때
-
슬롯머신마다 "터지는" 비율이 다름
-
어떤 슬롯머신을 "당길" 것인가?
-
MAB 문제는 강화학습의 일종
-
상태 또는 문맥은 1가지
-
각 행동은 즉시 보상을 주며 다음 환경 상태에 영향을 주지 않음
-
여러 시점에 걸쳐 주어진 대안 중 하나를 반복 선택
-
목표는 전체 기간의 누적 보상을 최대화하는 것
탐색과 활용의 균형
- 탐색: 새로운 시도를 해보는 것
- 활용: 기존에 알려진 최선을 반복하는 것
- 탐색만 하는 전략:
- 모든 슬롯머신을 골고루 당겨본다
- 각 슬롯머신의 수익률을 가장 정확히 파악할 수 있음
- 돈은 모든 슬롯머신의 평균만큼만 벌 수 있음
- 활용만 하는 전략:
- 슬롯머신을 하나 정해서 무조건 그것만 당겨본다
- 다른 슬롯머신의 수익률은 알 수 없음
- 운 좋게 잘 터지는 슬롯머신을 고를 경우 대박, 그렇지 않으면 망함
- 강화학습에서는 탐색과 활용이 모두 보상이 따르는 행동이므로 탐색을 늘리면 그만큼 활용을 적게 하게 됨
MAB 문제의 활용
- 홈페이지/광고 디자인(홈페이지나 광고의 디자인을 무엇으로 할까?)
- 제품 추천(고객에게 어떤 제품을 추천할 것인가?)
- 약물 적용(환자에게 어떤 약을 적용할 것인가?)
- 기존에는 전문가 의견, A/B 테스트와 같은 방법 사용
- A/B 테스트: 고객 또는 환자를 A군과 B군으로 나누어 다른 방법을 적용
MAB 환경
class MultiArmedBandit(gym.Env):
    def __init__(self, p_dist, r_dist):
        self.p_dist = np.array(p_dist)  # 확률
        self.r_dist = np.array(r_dist)  # 보상
        self.action_space = gym.spaces.Discrete(len(p_dist))  # 행동
        self.observation_space = gym.spaces.Discrete(1)  # 상태(1가지 밖에 없음)

    def step(self, action):
        p = self.p_dist[action]
        r = np.random.binomial(1, p) * self.r_dist[action]
        return 0, r, False, False, {}
후회 regret
- 강화학습의 목표: 가치(할인된 보상의 합)의 기댓값을 최대화
- MAB는 한 행동이 이후 상태에 영향을 주지 않음 → 보상만 고려
- 후회(regret): 한 번의 행동의 기회비용
- 전체(total) 후회: 에피소드 전체에서 후회의 합계
- 누적 보상의 최대화 = 전체 후회의 최소화
입실론 퍼스트 epsilon first method
- 일정 비율(ε, epsilon)만큼 탐색
- 이후로는 가장 가치가 높은 행동만 한다 (활용)
- 일상적으로 많이 하는 방법
- 예시:
- 슬롯머신을 각각 100번씩 당겨본 후, 그 후로는 가치가 가장 높은 슬롯머신만 당긴다
- 홈페이지 디자인 A안과 B안을 1만명의 고객에게 무작위로 보여준 후, 가치가 더 높은 디자인을 골라 모든 고객에게 보여준다
입실론 퍼스트
class EpsilonFirstAgent:
    def __init__(self, env, epsilon, n_episodes=1000):
        self.env = env
        self.epsilon = epsilon
        self.n_episodes = n_episodes
        self.Q = np.zeros(env.action_space.n)
        self.N = np.zeros(env.action_space.n, dtype=int)
        self.Q_history = np.empty((n_episodes, env.action_space.n))
        self.returns = np.empty(n_episodes)
        self.actions = np.empty(n_episodes, dtype=int)
입실론 퍼스트
def select_action(self, episode):
    n_explore = int(self.n_episodes * self.epsilon)
    if episode < n_explore:
        return self.env.action_space.sample()  # 탐색
    else:
        return np.argmax(self.Q)  # 활용

def update_estimates(self, action, reward):
    self.N[action] += 1
    self.Q[action] = self.Q[action] + (reward - self.Q[action]) / self.N[action]
    # 평균의 다른 계산법(뒷장에서 설명)
입실론 퍼스트
def run(self):
    for e in tqdm.trange(self.n_episodes):
        action = self.select_action(e)
        _, reward, done, _, _ = self.env.step(action)
        self.update_estimates(action, reward)
        self.Q_history[e] = self.Q
        self.returns[e] = reward
        self.actions[e] = action
        if done:
            self.env.reset()
    return self.returns, self.Q_history, self.actions
평균의 다른 계산법
- 일반적인 평균 계산법
- 강화학습에서 많이 사용하는 평균 계산법
self.Q[action] = self.Q[action] + (reward - self.Q[action]) / self.N[action]
- 합계를 구하지 않고 평균 구함
- 수학적으로는 동일하나 합계를 저장해둘 필요가 없는 장점
- 컴퓨터 계산 특성상 합계가 너무 커져서 생기는 overflow 등 문제를 피할 수 있음
평균 계산법의 해석
vn=vn−1+n1(Rn−vn−1)- vn−1: 기존의 가치
- Rn: 새로운 보상
- 새로운 보상 > 기존의 가치 → 가치를 UP
- 새로운 보상 < 기존의 가치 → 가치를 DOWN
입실론 퍼스트 실험
env = MultiArmedBandit(p_dist=[0.3, 0.1], r_dist=[0.1, 0.2])
agent = EpsilonFirstAgent(env, epsilon=0.1)
returns, Q_history, actions = agent.run()
시각화
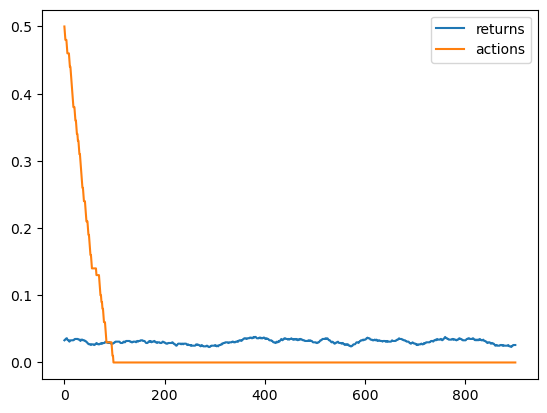
- 100개씩 묶어 평균
def moving_average(x, window=100):
    return np.convolve(x, np.ones(window), 'valid') / window
- 시각화
import matplotlib.pyplot as plt

plt.plot(moving_average(returns), label='returns')
plt.plot(moving_average(actions), label='actions')
plt.legend()
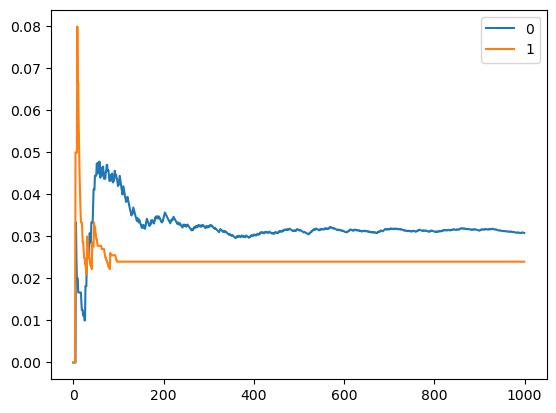
행동 가치 추정치의 변화
plt.plot(Q_history[:, 0], label='0')
plt.plot(Q_history[:, 1], label='1')
plt.legend()
입실론 퍼스트의 문제점
- 충분히 탐색을 하지 못할 가능성
- 100번으로는 슬롯머신의 가치를 충분히 정확히 추정하기에 부족하다면?
- 시간에 따라 변화하는 상황에 대응하지 못함
- 여름에 실험한 결과는 겨울에 통하지 않는다면?
퀴즈
멀티 암드 밴딧(Multi-Armed Bandit)에 대한 설명으로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.