
강화학습과 다른 방법들
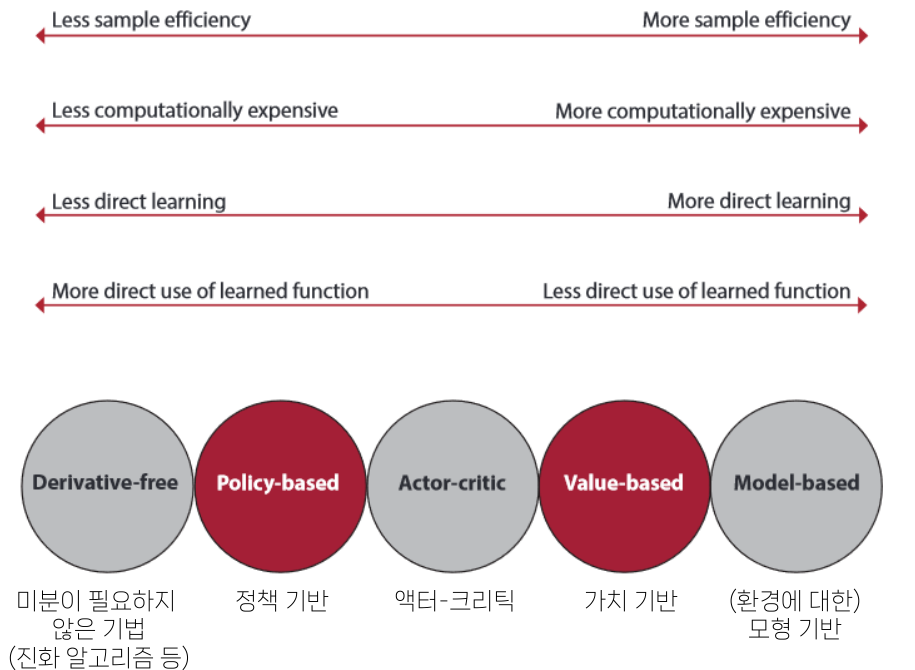
강화학습의 방법들
- 미분이 필요하지 않은 기법(진화 알고리즘 등)
- 정책 기반
- 액터-크리틱
- 가치 기반
- (환경에 대한) 모형 기반
진화 알고리즘 Evolutionary Algorithms
- 자연 선택과 유전적 진화의 원리를 모방하여 최적화 문제를 해결하는 메타휴리스틱 방법
- 다양한 분야에서 복잡한 최적화 문제를 해결하는 데 사용
- 개체(Individuals): 해를 나타내는 하나의 단위
- 유전자(Gene): 개체의 특성을 나타내는 최소 단위
- 집단(Population): 여러 개체의 모임
- 적합도(Fitness): 각 개체의 성능을 평가하는 척도
진화 알고리즘
- 선택(Selection): 적합도가 높은 개체들을 선택하여 다음 세대로 전달
- 교차(Crossover): 선택된 개체들 간에 유전자를 교환하여 새로운 개체(자식)를 만듦
- 변이(Mutation): 자식 개체의 유전자를 임의로 변경하여 다양성을 유지
- 대체(Replacement): 새로운 세대의 개체들로 기존 세대의 개체들을 대체
- 전체 대체: 전 세대를 모두 대체
- 부분 대체: 일부만 교체
진화 알고리즘의 장단점
- 강한 탐색
- 강화 학습은 경험을 수집하고 행위자에게 보상이 더 큰 정책을 학습 -> 행위자가 한 행동에 결과가 좌우
- 진화 알고리즘은 무작위적으로 변이를 일으킴
- 선택 및 변이의 강도를 통해 탐색의 정도를 조절할 수 있음
- 큰 표집 비용
- 강화학습은 단일 행위자가 환경과 상호작용하면서 학습
- 진화 알고리즘은 다수의 행위자를 환경에 풀어놓고 변이를 통해 더 나은 행위자가 나오기를 기대 -> 더 많은 계산이 필요
- 집단의 크기를 줄이면 계산량이 줄지만, 덜 적합한 자식들이 증가할 수 있음(유전적 부동)
모방 학습 Imitation Learning
- 인간 또는 전문가의 행동을 모방하여 학습
- 직접적인 보상 신호 없이도 효율적으로 학습할 수 있음
- 접근 방식
- 행동 복제
- 역 강화학습(IRL)
- 생성적 적대 모방 학습(GAIL)
행동 복제 Behavior Cloning
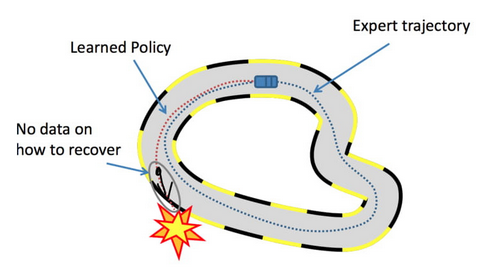
- 가장 단순한 모방 학습 방법
- 지도 학습을 사용하여 시연 데이터로부터 직접적으로 정책을 학습
- 주어진 상태에서 전문가가 선택한 행동을 예측하도록 모델을 훈련
- 시연 데이터에 포함되지 않은 상태에 대해서는 잘 일반화하지 못할 수 있음
역 강화학습 Inverse Reinforcement Learning
- 전문가의 행동이 어떤 숨겨진 보상 함수를 극대화하기 위한 것이라고 가정
- 전문가의 시연으로부터 보상 함수를 추정
- 추정된 보상 함수를 사용하여 최적의 정책을 학습
- 단, 추정할 수 있는 보상 함수가 유일하지 않음
- 예: 모든 행동에 똑같은 보상으로 주면, 어떤 행동도 최적 행동임
- 보상 함수의 형태를 제한
- 예: 선형 보상 함수
생성적 적대 모방 학습 Generative Adversarial Imitation Learning
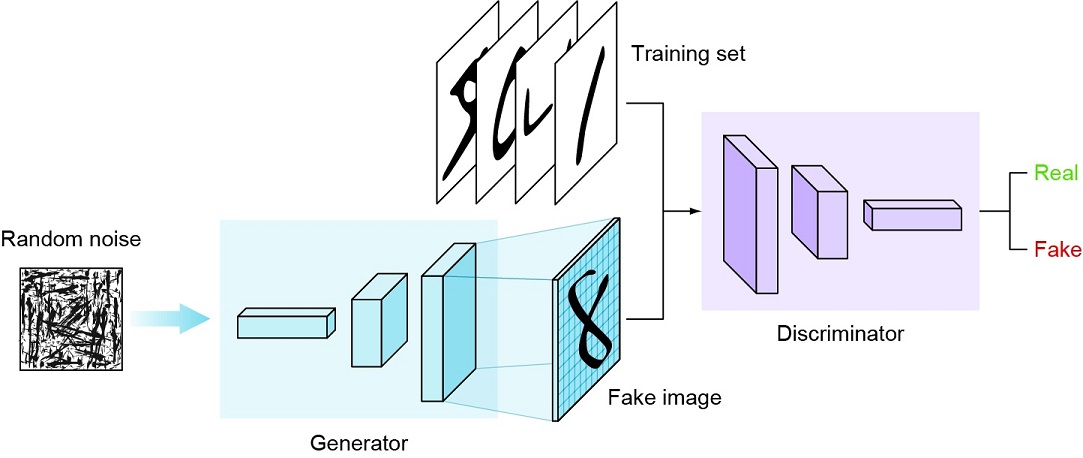
- 생성적 적대 신경망(GAN)의 아이디어를 모방 학습에 적용
- GAIL은 전문가의 시연과 행위자의 행동을 구분하려는 판별자(discriminator)와 행위자의 정책을 최적화하려는 생성자(generator)로 구성
- 행위자는 판별자가 전문가와 행위자를 구분하지 못하도록 학습하여 전문가의 행동을 모방
퀴즈
슬라이드에서 강화학습 방법의 범주로 제시된 것을 모두 고르세요.
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.