
알파고
Finite Two Person Zero-Sum Sequential Game
- finite: 일정 시점에 종료되는
- two person: 두 행위자가 참여
- zero-sum: 두 행위자의 수익의 합이 0
- sequential: 각 행위자가 번갈아가며 행동
- 예시: 바둑, 체스, 오목 등
미니맥스 전략 minimax strategy
- 상대가 최선의 행동(max)을 한다는 가정 아래, 이를 최소화(min)시키는 행동을 선택
- 아래 보수 행렬에서 A의 이익/손실 = B의 손실/이익인 경우
- A에게 최선의 선택은 A2(최악의 경우가 -1로 최소)
- B에게 최선의 선택은 B2(최악의 경우가 0으로 최소)
- 모든 경우의 수를 따져야 함
- 바둑과 같이 경우의 수가 많은 게임에는 사용 불가
| A의 보수 행렬(payoff matrix) | B1 | B2 | B3 |
|---|---|---|---|
| A1 | +3 | -2 | +2 |
| A2 | -1 | 0 | +4 |
| A3 | -4 | -3 | +1 |
내시 균형 Nash Equilibrium
- 서로가 상대방의 전략에 최선의 대응을 하고 있는 상태
- 완전 정보 조건 하에서 미니맥스 전략은 내시 균형
- 앞의 보수 행렬에서
- A는 행동을 어떻게 바꿔도 손해 -> 바꿀 수 없음
- B가 이익을 늘리기 위해 B1으로 행동을 바꾸면 A가 A1으로 바꿔서 맞대응 -> B는 결과적으로 손해 -> 바꿀 수 없음
- 죄수의 딜레마: 서로 협조하는 것이 최대의 이익을 가져오지만 서로 배신하는 것이 내시 균형인 경우
몬테카를로 트리 탐색
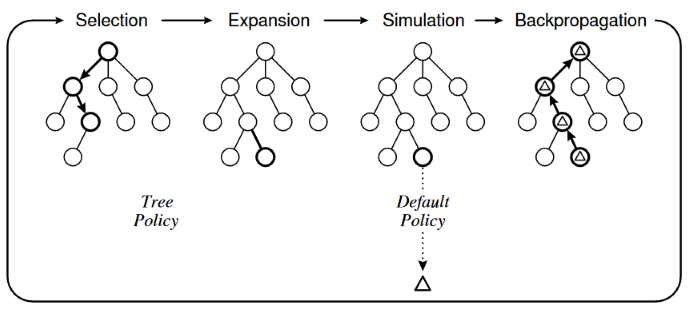
- 트리 정책(tree policy)과 기본 정책(default policy, 또는 롤아웃 정책)으로 구분
- 트리 정책에 따라 다음에 탐색할 노드를 선택(selection)
- 선택된 노드에서 새로운 자식 노드를 생성하여 트리를 확장(expansion)
- 선택된 수에서 기본 정책에 따라 게임을 진행(simulation, rollout)
- 시뮬레이션의 결과가 상위 노드로 역전파(backpropagation)
UCT Confidence Bounds applied for Trees
- 가장 널리 쓰이는 트리 정책으로, 다음의 값이 가장 큰 행동을 선택
- Q(s,a): 상태-행동 가치(그 수를 두었을 때 이긴 비율, 0~1)
- C: 탐색-활용을 제어하는 하이퍼파라미터(보통 2를 사용)
- N(s): 상태 s를 탐색한 횟수
- N(s,a): 상태 s에서 행동 a를 탐색한 횟수
- 이긴 비율이 높고 지금까지 탐색을 덜 한 행동을 선택
AlphaGo
- AlphaGo Fan: 2015년 유럽 챔피언 판 후이 2단과 대국에 사용
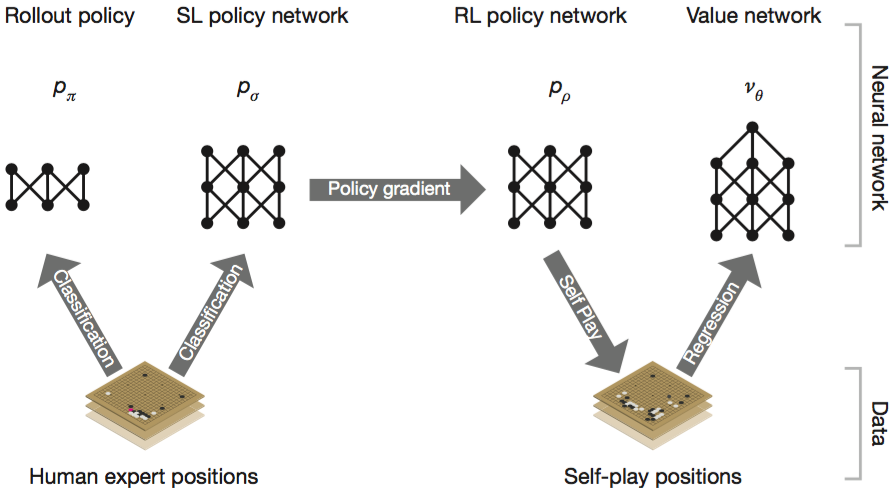
- 지도학습 정책망: 프로 6단~9단 사이의 대국 기보 16만개로부터 3천만 가지 바둑판의 상태를 학습. 다음에 어디에 둘 지를 예측
- MCTS에서 트리의 폭을 제한
- 롤아웃망: 시뮬레이션을 빠르게 하기 위해 단순한 구조를 사용
- self-play(알파고끼리 대국)을 하여 정책망을 강화학습 학습
- 정책망을 바탕으로 가치망을 학습
- AlphaGo Lee: 2016년 이세돌 9단과 대국
- AlphaGo Zero: 정책망과 가치망을 통합, 롤아웃 제거
- AlphaZero: 바둑, 장기, 체스 등에 모두 적용가능한 모델
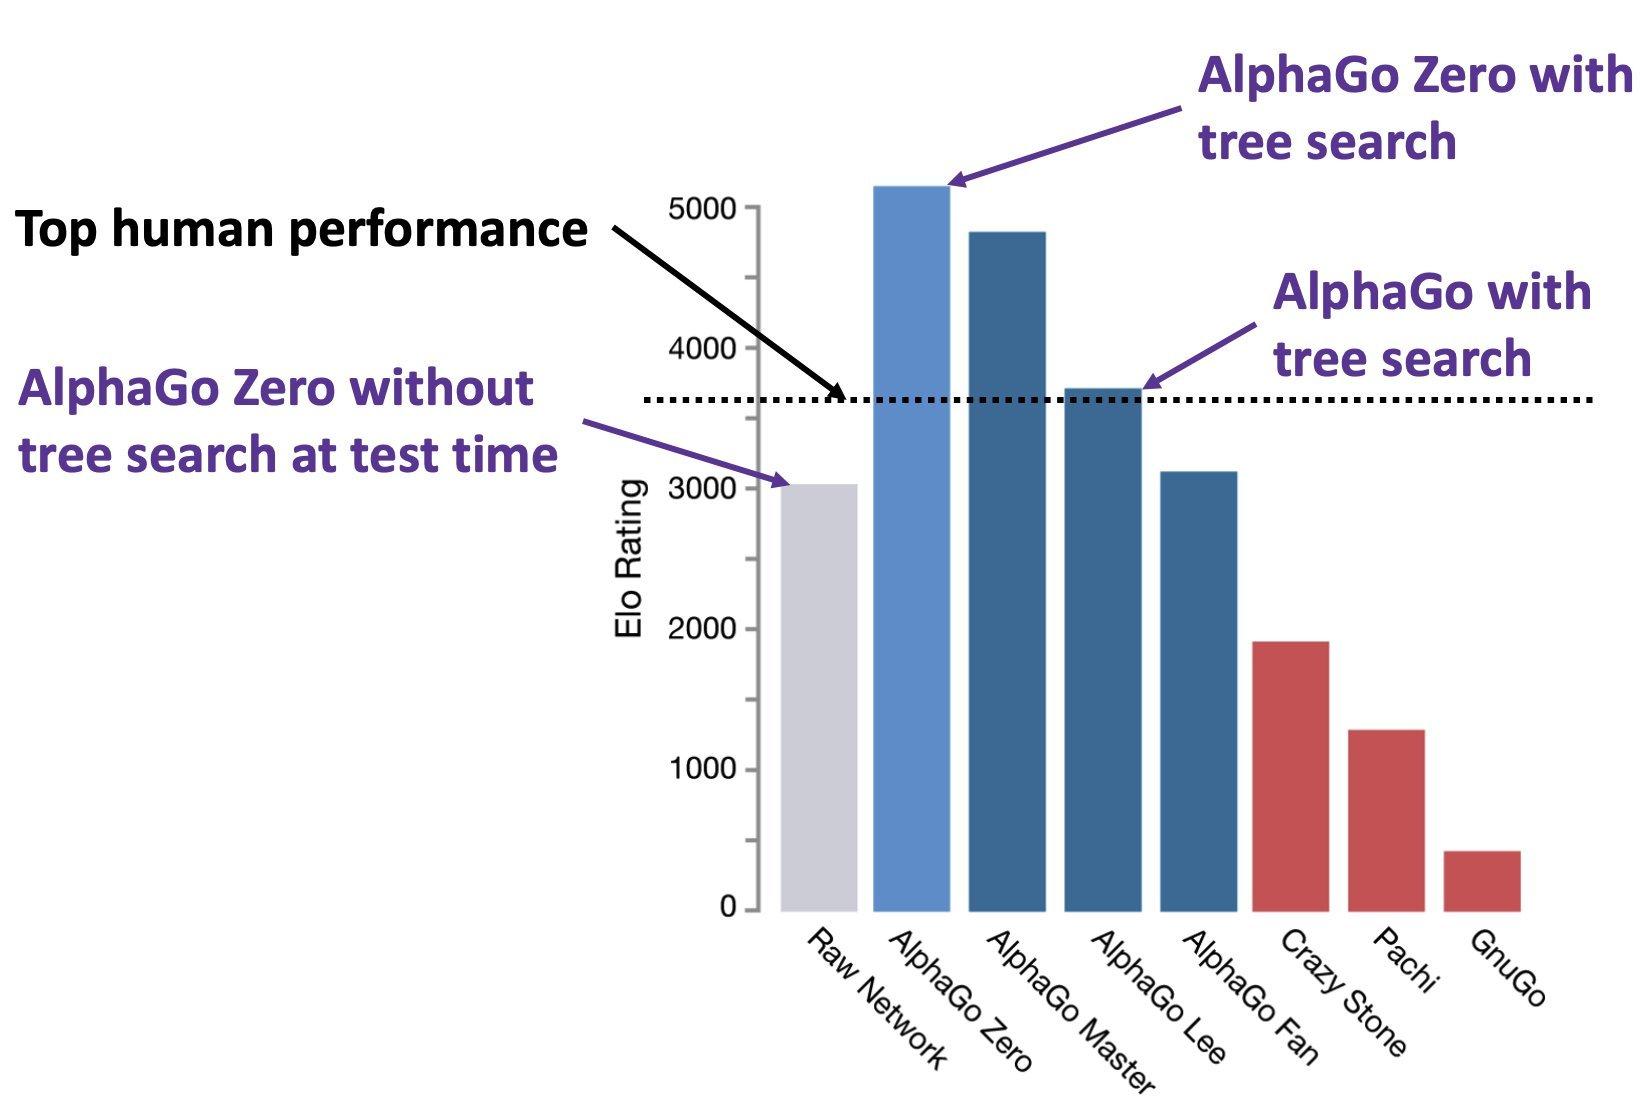
알파고의 엘로 평점
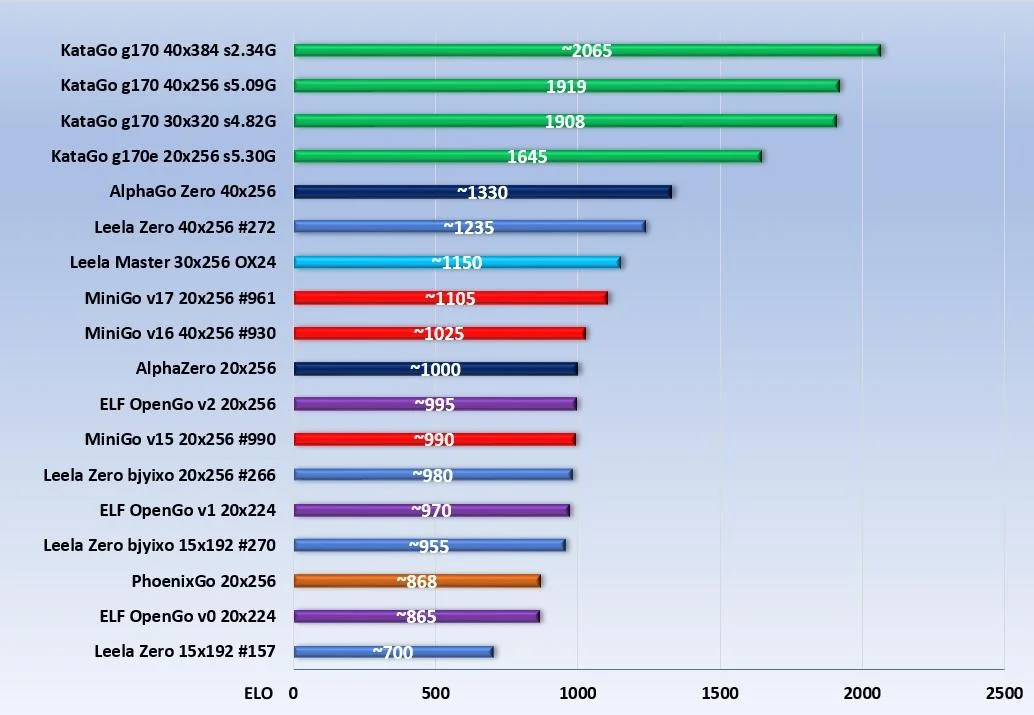
엘로 평점 시스템 Elo rating system
- 물리학자 아르파드 엘로(Arpad Elo)가 개발한 평점 시스템
- R: 평점
- K: 상수
- S: 이긴 횟수
- E: 이긴 횟수의 기댓값
승리 횟수의 기댓값
EA=1+10−(RA−RB)/4001- EA: A가 이길 확률
- RA: A의 평점
- RB: B의 평점
- 로지스틱 함수와 같음
엘로 평점 시스템의 특징
- 평점으로부터 승리 확률을 예측할 수 있음
- 모든 선수의 실력을 한 차원에 배열할 수 있다는 가정(unidimensional)
- 약한 상대에게 지면 평점이 많이 깎이나, 이겨도 조금 밖에 오르지 않음
- 평점이 오를 수록 더 올리기는 어려워짐
퀴즈
Finite Two Person Zero-Sum Sequential Game의 설명으로 올바른 것을 모두 고르세요.
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.