
GRPO
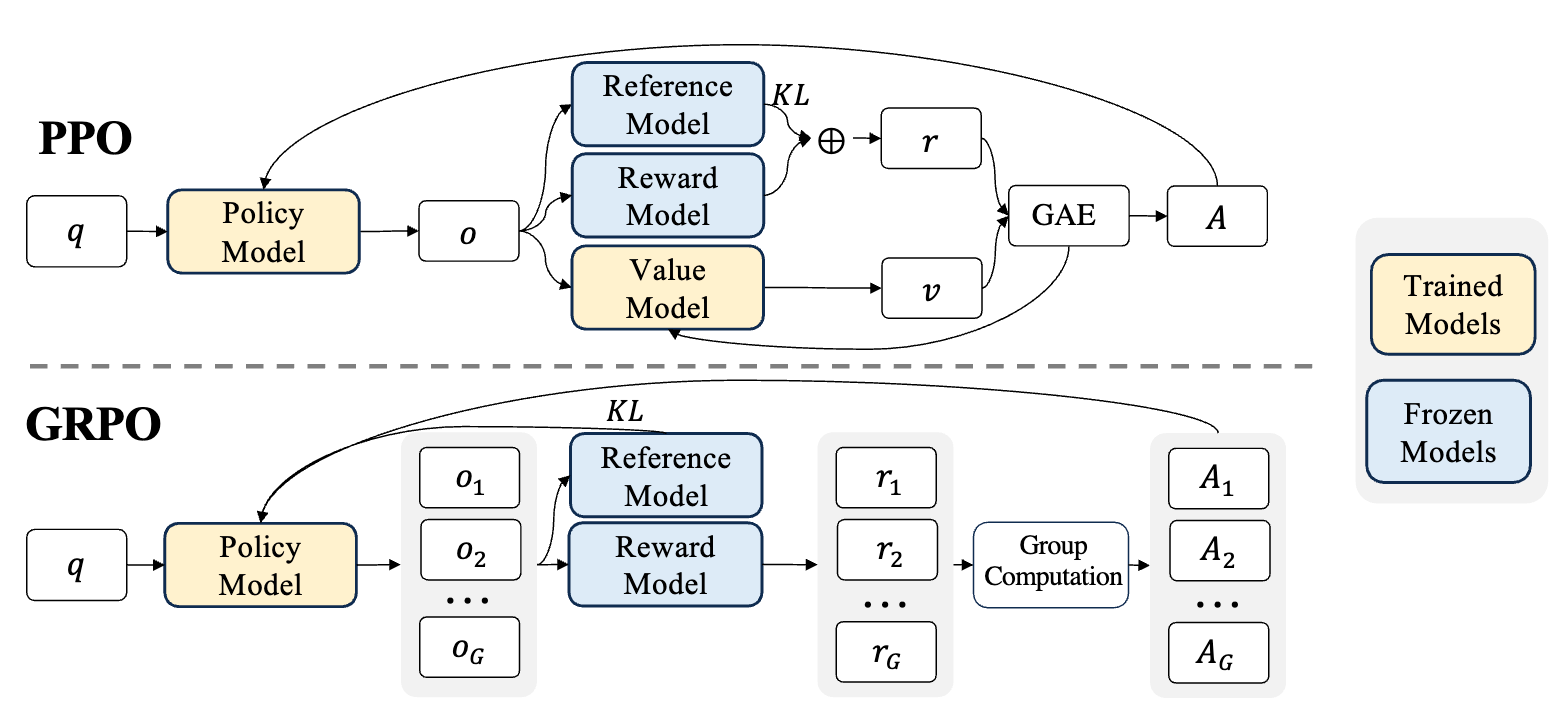
그룹 상대 정책 최적화(Group Relative Policy Optimization, GRPO)는 DeepSeek가 2024년 발표한 논문 DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models에서 소개한 LLM 강화학습 방법. 지도 미세조정(Supervised Fine-Tuning, SFT)을 마친 언어 모델의 수학 추론 능력을 높이기 위해 사용하며, 근접 정책 최적화(Proximal Policy Optimization, PPO)를 LLM 학습에 맞게 단순화한 방식.
핵심은 크리틱 또는 가치 함수 모델을 별도로 학습하지 않는 것. 같은 질문에서 여러 답변을 생성하고 보상을 비교해 기준선(baseline)을 구성. PPO의 별도 가치 모델을 제거해 메모리와 계산 비용 절감.
PPO에서 GRPO로
PPO는 액터-크리틱(actor-critic) 방식의 강화학습 알고리즘. LLM 미세조정에서는 현재 정책 πθ가 이전 정책 πθold에서 지나치게 벗어나지 않도록 클리핑한 다음 아래 대리 목적 함수를 최대화.
JPPO(θ)=E∣o∣1t=1∑∣o∣min(ρtAt,clip(ρt,1−ϵ,1+ϵ)At)비율 ρt의 정의:
ρt=πθold(ot∣q,o<t)πθ(ot∣q,o<t)q는 질문, o는 생성된 답변, At는 시간 t의 어드밴티지. PPO는 보상과 학습된 가치 함수 Vψ를 이용해 일반화 어드밴티지 추정(Generalized Advantage Estimation, GAE)으로 At를 계산.
LLM 강화학습에서는 보상 모델의 과최적화를 막기 위해 기준 모델(reference model)과의 KL 페널티를 보상에 추가.
rt=rφ(q,o≤t)−βlogπref(ot∣q,o<t)πθ(ot∣q,o<t)rφ는 보상 모델, πref는 기준 정책. 기준 정책에는 보통 초기 SFT 모델을 사용하며, β는 KL 페널티의 강도 조절 계수.
PPO의 가치 함수는 보통 정책 모델과 비슷한 크기의 별도 모델. LLM에서는 메모리와 계산량이 크게 증가. 또한 보상 모델이 주로 답변의 마지막 토큰에만 점수를 주므로 모든 토큰 위치의 정확한 가치 함수 학습도 어려움.
GRPO의 핵심 아이디어
GRPO는 가치 함수 모델을 제거하고 같은 질문에서 생성한 답변 그룹의 평균 보상을 기준선으로 사용. 질문 q마다 이전 정책 πθold에서 답변 G개를 샘플링.
o1,o2,…,oG∼πθold(⋅∣q)각 답변의 보상을 계산한 뒤 그룹 내에서 좋은 답변에는 양의 어드밴티지, 나쁜 답변에는 음의 어드밴티지를 부여. 절대 점수 하나가 아니라 같은 문제에서 생성한 후보 답변의 상대적 품질을 기준으로 모델을 업데이트.
GRPO 목적 함수는 PPO의 클리핑 구조를 유지하되 어드밴티지를 그룹 상대 보상으로 계산하고 KL 정규화 항을 직접 포함.
JGRPO(θ)=EG1i=1∑G∣oi∣1t=1∑∣oi∣{min(ρi,tA^i,t,clip(ρi,t,1−ϵ,1+ϵ)A^i,t)−βDKL(πθ∥πref)}여기서
ρi,t=πθold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)여기서 A^i,t는 같은 질문의 답변 그룹 내부에서 상대 보상으로 계산한 어드밴티지.
논문에서 사용하는 KL 항의 추정량:
DKL(πθ∥πref)=πθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)−logπθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)−1양수가 보장되는 KL 추정량. GRPO는 KL 페널티를 보상과 섞지 않고 목적 함수에 직접 더해 그룹 상대 어드밴티지 계산을 단순하게 유지.
결과 감독 GRPO
결과 감독(outcome supervision)은 답변 전체가 끝난 뒤 보상 하나만 부여하는 방식. 질문 q마다 답변 G개를 생성하고 보상 모델에서 점수 r1,r2,…,rG를 산출.
그룹 평균을 빼고 표준편차로 나누어 보상을 정규화.
r~i=std(r)ri−mean(r)결과 감독에서는 답변 oi에 속한 모든 토큰의 어드밴티지를 같은 값으로 둡니다.
A^i,t=r~i답변 전체의 평가가 좋으면 모든 구성 토큰의 선택 확률을 높이고, 나쁘면 낮추는 방향으로 학습.
과정 감독 GRPO
과정 감독(process supervision)은 답변 전체가 아니라 풀이 과정의 각 단계에 보상을 부여하는 방식. 여러 추론 단계를 거치는 수학 문제에서는 중간 풀이까지 평가해 마지막 정답만 볼 때보다 촘촘한 학습 신호 제공.
답변 oi는 Ki개의 추론 단계로 구성되고, index(j)는 j번째 단계의 마지막 토큰 위치. 과정 보상 모델은 각 단계 끝에서 보상을 계산.
riindex(1),riindex(2),…,riindex(Ki)이 보상도 그룹 전체의 평균과 표준편차로 정규화.
r~iindex(j)=std(R)riindex(j)−mean(R)각 토큰의 어드밴티지는 해당 토큰 이후에 남은 단계 보상의 합으로 계산.
A^i,t=index(j)≥t∑r~iindex(j)특정 토큰 선택이 이후의 좋은 풀이로 이어지면 더 큰 양의 신호를, 이후 단계가 나쁘게 평가되면 음의 신호를 부여.
반복적 GRPO
강화학습 중 정책 모델이 계속 바뀌면 처음 학습한 보상 모델만으로 현재 정책을 충분히 감독하기 어려울 수 있음. 이를 보완하는 반복적 GRPO(iterative RL with GRPO)도 논문에서 제시.
반복적 GRPO의 흐름:
- 현재 정책 모델을 기준 모델로 설정
- 작업 프롬프트 배치 샘플링
- 각 질문에 대해 이전 정책에서 답변 G개 생성
- 보상 모델로 각 답변의 보상 계산
- 그룹 상대 어드밴티지 계산
- GRPO 목적 함수를 최대화하도록 정책 모델 업데이트
- 정책 모델의 샘플링 결과로 보상 모델 학습 데이터를 만들고, 과거 데이터 일부를 섞는 리플레이(replay) 방식으로 보상 모델을 계속 학습
논문에서는 과거 데이터의 10%를 리플레이에 포함. 정책 모델과 보상 모델이 함께 최신 분포를 따라가도록 구성.
PPO와 GRPO 비교
| 항목 | PPO | GRPO |
|---|---|---|
| 기준선 | 학습된 가치 함수 Vψ | 같은 질문의 답변 그룹 평균 보상 |
| 추가 모델 | 가치 모델 필요 | 가치 모델 생략 |
| 어드밴티지 | GAE로 계산 | 그룹 내부 상대 보상으로 계산 |
| KL 제어 | 보상에 KL 페널티를 추가 | 목적 함수에 KL 항을 직접 추가 |
| LLM 학습 비용 | 정책 모델, 보상 모델, 가치 모델이 필요해 비용이 큼 | 가치 모델을 제거해 메모리와 계산량을 줄임 |
GRPO의 핵심 관점은 "좋은 답변인지"라는 절대 평가보다 "같은 질문의 다른 답변보다 좋은지"라는 상대 평가를 학습 신호로 사용하는 것. 보상 모델도 보통 같은 질문의 답변 비교 데이터로 학습하므로 그룹 상대 방식은 LLM 선호 학습의 데이터 구조와 잘 맞음.