
딥러닝
표 기반 tabular 강화학습
- 상태 또는 상태-행동별로 가치 등을 표 형식으로 저장 (지금까지 한 방법)
- 강화 학습을 적용하려는 많은 작업에서 상태 공간은 조합적이고 거대
- 예: 가능한 바둑판의 상태는 우주에 있는 원자의 수보다 많음
- 무한한 시간과 용량이 있어도 최적의 정책이나 최적의 가치함수를 찾을 수 없음
- 상태 공간이 연속적이어도 표로 나타낼 수 없음
함수 근사 function approximation
- 제한된 계산 자원을 사용하여 좋은 근사 해를 찾을 필요가 있음
- 소수의 사례로부터 다수의 사례로 일반화할 수 있도록 함수를 근사
- 표 기반 강화학습이 가능한 경우에도 함수 근사는 도움이 됨
- 표 기반의 경우 비슷한 상태라도 서로 독립적이기 때문에 가치 추정을 위해 별도 샘플 필요
- 함수 근사를 할 경우 비슷한 상태의 사례로부터 일반화되기 때문에 효율성이 증가
- 함수 근사는 지도 학습에서 많이 연구됨 -> 강화학습에도 응용할 수 있음
- 단, 강화 학습에는 기존 지도 학습에서는 없는 여러 가지 문제들이 있음
- 함수 근사의 방법에는 여러 가지가 있으나 일반적으로 신경망 기반의 딥러닝을 사용 -> 심층 강화학습(deep reinforcement learning)
NFQ Neural Fitted Q iteration
- 인공신경망을 강화학습의 함수 근사에 적용한 초기 알고리즘
- Fitted Value Iteration -> Fitted Q Iteration -> Neural FQI 로 발전
- 배치(batch) 강화학습: 데이터를 수집 후에 일괄적으로 학습하는 방식
- 온라인(on-line) 강화학습: 데이터 수집과 학습이 동시에 이뤄짐(앞에서 한 방식)
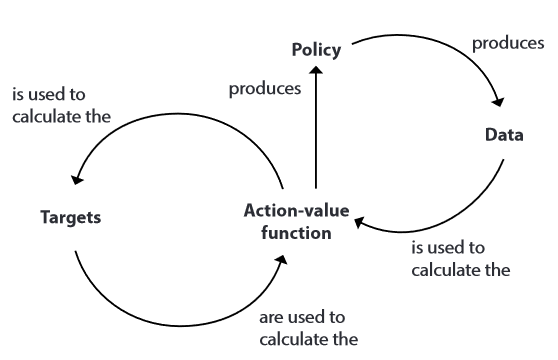
- 기본 아이디어:
- 환경과 상호작용을 통해 데이터를 만듦
- 만들어진 데이터로 행동 가치 함수 Q를 신경망으로 학습
- 위 과정의 반복
행동 가치 함수의 구현
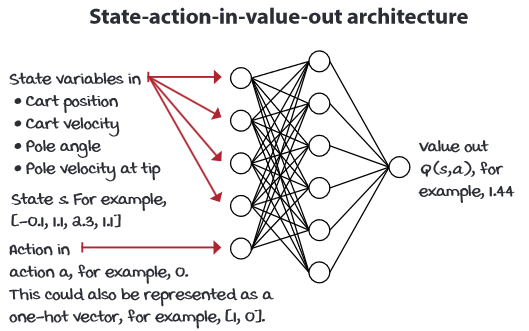
- 행동 가치 함수 qπ(s,a)는 상태와 행동을 입력으로 하므로 신경망 모형도 상태와 행동을 입력으로 구현하는 것이 직관적(state-action-in-value-out)
- 여러 행동의 가치를 구하려면 반복적으로 모형에 입력해야 하므로 비효율적
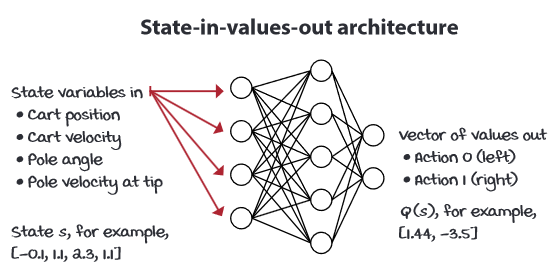
- 상태를 입력하면 모든 행동의 가치를 출력하도록 모형을 구현하여 효율을 높일 수 있음(state-in-values-out)
NFQ와 역전파 알고리즘
- 지도학습에서는 데이터의 레이블을 예측
- 강화학습에서 TD 목표(=보상+다음 상태의 수익)는 모델 자체에서 나옴
- 다음 상태의 수익에 대한 추정치는 오차 역전파의 대상에서 제외
함수 근사의 문제 (1) 훈련의 불안정성
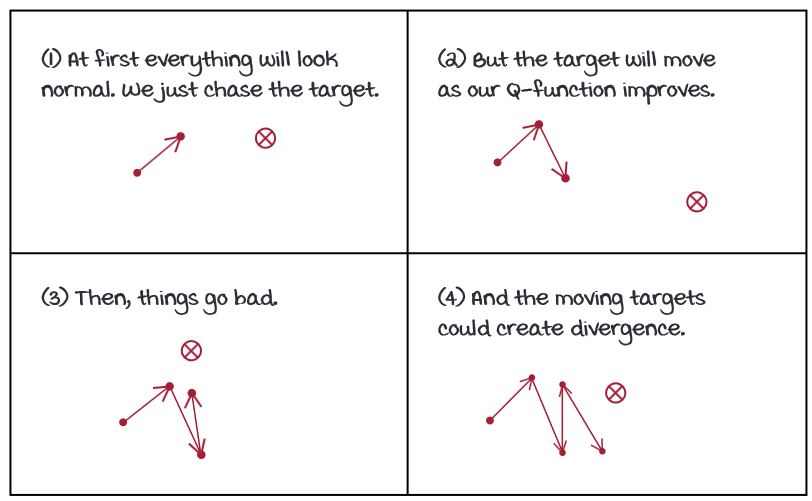
- Q 학습의 목표(target)에 따라 업데이트
- 목표는 다음 상태의 추정치에 의존
- 근사 Q 함수의 가중치를 업데이트하면 다음 상태의 추정치도 변함 -> 목표도 변함
- 가중치 업데이트에 따라 목표가 계속 변하므로 학습 과정이 불안정해짐
함수 근사의 문제 (2) iid 가정 위배
- iid: 독립적이며 동일한 분포에서 나왔다(independent and identically distributed)
- 대부분의 통계/머신러닝 기법은 표본이 iid 가정을 함
- 표본이 같은 정책과 궤적에서 나옴, 이전의 행동이 이후의 상태에 영향 -> 독립적이지 않음
- 학습 과정에서 정책이 변함 -> 동일한 분포가 아님
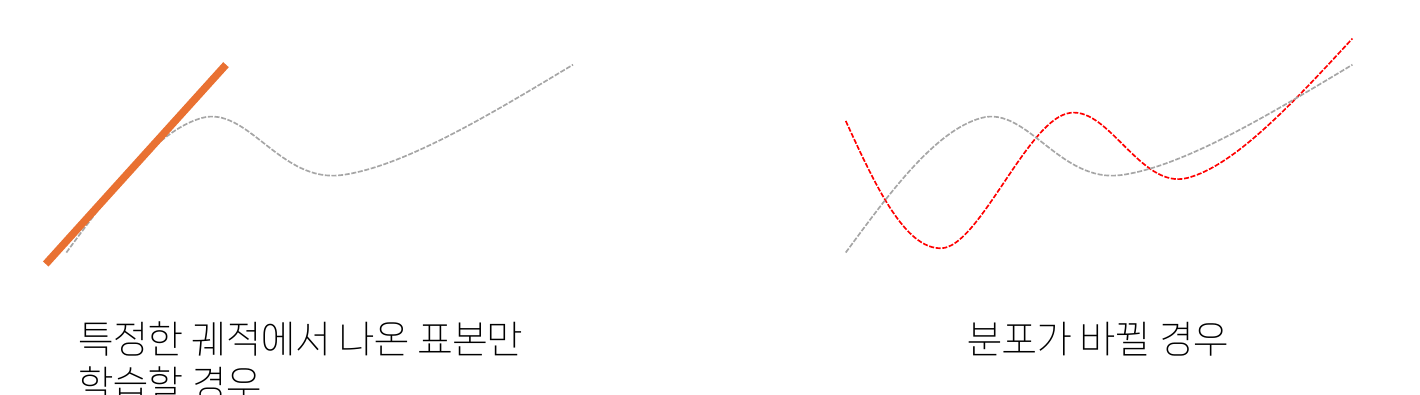
함수 근사의 문제에 대한 NFQ의 해결책
- 동일한 배치를 신경망에 여러 번 학습시킨다
- 배치의 크기를 키우고, 하나의 배치에 다양한 사례를 포함시킨다
Deep Q Network
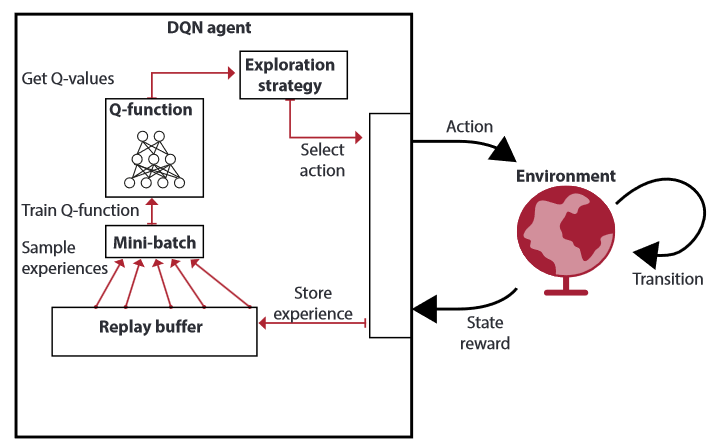
- 구글 딥마인드가 발표한 최초의 딥러닝 + 강화학습 모형
- 목표를 고정시켜 학습이 불안정해지는 것을 방지
- 동일한 신경망을 "온라인 망 Q"과 "목표망(Target Network) Q−" 두 벌로 만듦
- 목표망은 고정 시키고, 온라인 망을 학습
- 일정 간격(예: 1000번)마다 목표망을 온라인으로 덮어씀
- 상관이 강한 상태들 사이에서 작은 차이를 반영할 수 있도록 신경망의 크기도 키움
경험 리플레이 Experience Replay
- 경험 샘플을 순서대로 학습시키면, 서로 독립적이지 않음
- 리플레이 버퍼에 저장한 후, 일부를 무작위로 뽑아 Q 함수 학습에 사용
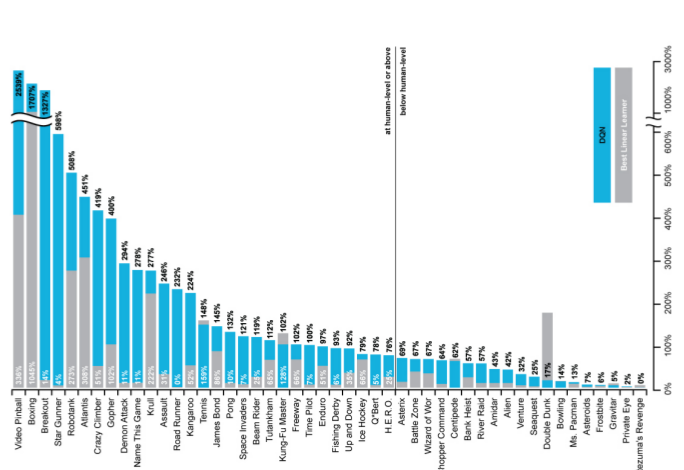
DQN vs. Human
- 컴퓨터 게임에서 DQN(파란색) vs. 인간(회색)
DQN에서 게임과 관련된 기법들
- DQN 논문은 게임을 대상으로 연구 -> 관련된 기법들 적용
- 보상 깎기(Clipping Rewards)
- 게임마다 점수가 다르므로 무조건 가점은 +1, 감점은 -1로 바꿔줌
- 프레임 건너뛰기(Skipping Frames)
- 게임의 경우 프레임 단위로 보면 움직임을 파악하기 어려움
- 여러 프레임을 간격을 두고 입력(예: 9 프레임 전, 5 프레임 전, 1프레임 전 -> 다음 행동?)
퀴즈
표 기반 강화학습을 거대한 상태 공간에 적용하기 어려운 이유로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.