
가치
가치
가치 함수와 정책
- 가치(value): 수익(return)의 기댓값
- 정책에 따라, 다음 상태의 행동이 달라지므로 얻을 수 있는 보상도 달라짐
- 상태나 행동의 가치도 달라짐
- 정책(policy): 상태에서 행동을 선택하는 규칙 또는 행동별 선택 확률
- 보통 π로 표시
- 결정론적 정책: 같은 상태에는 항상 같은 행동
- 확률론적 정책: 같은 상태에서도 확률분포에 따라 다른 행동 선택
상태 가치 함수
- 정책 π를 따르는 동안 상태 s에서 얻을 수 있는 수익의 기댓값
- 간단히 V-함수
- 벨만 방정식:
- π(a∣s): 현재 상태 s에서 각 행동 a의 확률
- p(s′,r∣s,a): 현재 상태 s에서 행동 a를 했을 때, 다음 상태 s′과 보상 r의 확률
- r+γvπ(s′): 다음 상태 보상 r과 다음 상태의 가치의 합
행동 가치 함수
- 상태 s에서 행동 a를 취한 뒤 정책 π를 따를 때 얻는 수익의 기댓값
- 간단히 Q-함수
- 행동 가치 함수의 벨만 방정식
- 상태 가치 함수와 행동 가치 함수의 관계
이득 advantage
- 이득: 현재 상태에 얻을 수 있는 평균적 수익(상태 가치)에 비해 특정 행동을 했을 때 더 얻을 수 있는 평균 수익(행동 가치)
- 위의 식을 행동 가치에 대해 다시 쓰면, 행동 가치는 상태 가치 + 이득으로 구성됨
- 같은 상태의 서로 다른 행동도 상태 가치를 공유
- 예: 카트폴에서 기둥이 똑바로 서있으면 왼쪽으로 가든 오른쪽으로 가든 행동 가치는 같음
최적성 optimality
- 될 수 있는 최상의 상태에 있음
- 최적 정책: 모든 상태에서 다른 정책보다 기대 수익이 크거나 같은 정책
- 경우의 수가 많기 때문에 실제로는 최적 정책을 구할 수 있는 경우는 별로 없음
- 강화학습은 최적정책의 근사를 구하는 것으로 볼 수 있음
- 모든 상태에 가장 좋은 행동을 할 필요는 없고, 자주 마주치는 상태에만 좋은 행동을 해도 현실적으로는 충분
- 단, 적대적 공격(adversarial attack)에 취약할 수 있음
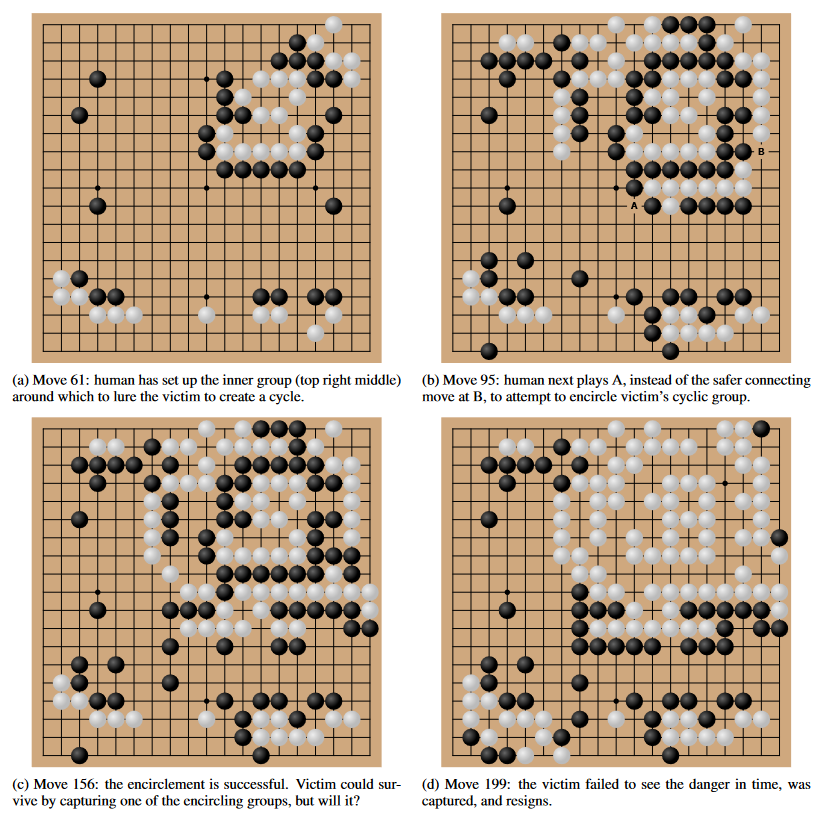
바둑 AI에 대한 적대적 공격
- 바둑 AI의 특정한 취약점을 공격하여 실수를 하도록 유도
- 인간 초보자도 AI에 97%의 승률을 달성
- Adversarial Policies Beat Superhuman Go AIs (https://arxiv.org/pdf/2211.00241)
최적 가치 함수
- 최적 상태 가치 함수: 모든 상태에서 모든 정책에 걸쳐 최대 가치를 갖는 상태 가치 함수
- 최적 행동 가치 함수: 모든 상태-행동에서 모든 정책에 걸쳐 최대 가치를 갖는 행동 가치 함수
- 최적 행동 이득 함수: 모든 상태-행동에서 모든 정책에 걸쳐 최대 가치를 갖는 행동 이득 함수
- 최적 정책은 여러 개여도 최적 가치 함수, 이득 함수는 하나만 존재
벨만 최적성 방정식
- 최적 상태 가치 함수
- 최적 행동 가치 함수
퀴즈
가치(value)의 의미로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.