
몬테카를로
몬테카를로
예측 문제
- 동적계획법은 전이함수를 이용해서 가치를 추정
- 현실에서는 전이함수가 알려진 경우가 없음
- 예측 문제: 전이 함수가 없이 가치 함수를 추정하는 문제
- cf) 제어 문제: 전이 함수 없이 정책을 최적화하는 문제
몬테카를로 법 Monte Carlo Methods
- 확률적 시행을 여러 번 반복하여 추정하는 방법
- 몬테카를로: 카지노로 유명한 유럽 모나코 공국의 지역
- 반지름 r인 원에 외접하는 정사각형이 있을 때
- 원의 넓이는 πr2, 사각형의 넓이는 4r2으로 π:4 비율
- 사각형 안에 균등 분포에 따라 무작위로 b개의 점을 찍음
- 원 안에 찍힌 점의 수가 a개면 π는 다음과 같이 계산:
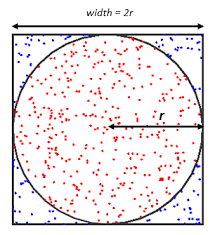
몬테카를로 법으로 원주율 구하기
import numpy as np
import matplotlib.pyplot as plt

a = b = 0
pi = []

for _ in range(10000):
    x, y = np.random.uniform(size=2)
    if x**2 + y**2 <= 1:
        a += 1
    else:
        b += 1
    pi.append(4 * a / (a + b))

plt.plot(pi)
pi[-1]
첫 방문 몬테카를로 First-visit Monte Carlo
- 정책을 이용해서 상태 St=s에 처음 방문해서 종료 상태에 도달할 때까지 환경과 상호작용
- 경험 튜플(experience tuple):
- 타임 스텝마다 (관찰, 행동, 보상, 새로운 관찰)의 순서쌍
- 궤적(trajectory): 경험 튜플의 시퀀스
- 얻어진 궤적을 이용하여 해당 상태의 수익(return) G를 구함
- G를 여러 번 구해서 평균내면, 상태 s의 가치 V(s)를 구할 수 있음
첫 방문 몬테카를로
- 현재 추정하고자 하는 가치 함수의 상태
- 원은 비종료 상태
- 마지막에 +1을 보상으로 받고 에피소드가 종료
- 보상
- 사각형은 종료 상태
- 점은 행동
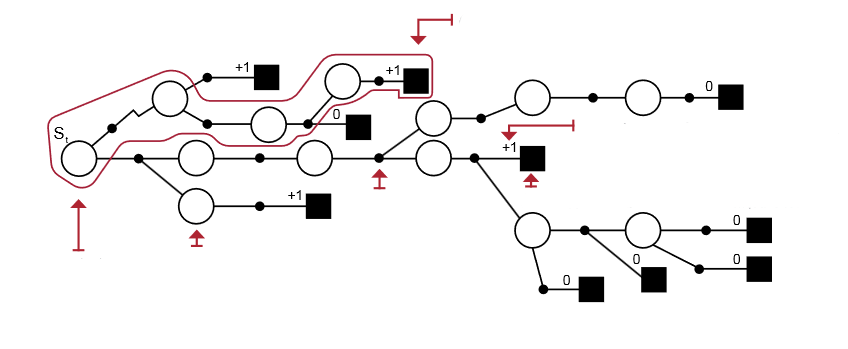
첫 방문 몬테카를로
import numpy as np
from collections import defaultdict


class MCPrediction:
    def __init__(self, env, gamma=0.9):
        self.gamma = gamma
        self.env = env
        self.V = np.zeros(env.observation_space.n)
        self.returns = defaultdict(list)

    def select_action(self, policy, state):
        return policy[state]

    def generate_episode(self, policy):
        episode = []
        state, info = self.env.reset()
        done = False
        while not done:
            action = self.select_action(policy, state)
            next_state, reward, done, _, _ = self.env.step(action)
            episode.append((state, action, reward, next_state, done))
            state = next_state
        return episode

    def update_value(self, episode):
        G = 0
        for t in reversed(range(len(episode))):
            state, action, reward, next_state, done = episode[t]
            G = self.gamma * G + reward
            if state not in [x[0] for x in episode[:t]]:
                self.returns[state].append(G)
                self.V[state] = np.mean(self.returns[state])

    def evaluate_policy(self, policy, num_episodes=1000):
        nS = self.env.observation_space.n
        self.V_track = np.zeros((nS, num_episodes))
        for e in range(num_episodes):
            episode = self.generate_episode(policy)
            self.update_value(episode)
            self.V_track[:, e] = self.V.copy()
        return self.V, self.V_track
실험
env = SlipperyWalk(9)
init_state, info = env.reset()
gamma = 1.0
n_episodes = 500
P = env.unwrapped.P

pi = {i: 0 for i in range(env.observation_space.n)}
agent = MCPrediction(env)
V, V_track = agent.evaluate_policy(pi)
RMSE Root Mean Square Error
- 오차(error)의 제곱의 평균(mean)의 양의 제곱근(root)
- cf) 표준편차
- RMSE는 오차의 단위를 유지
- 예측값과 실제값이 온도(섭씨)라면 RMSE도 섭씨
- 큰 오차에 대해 더 큰 패널티를 부여
def rmse(x, y):
    return np.sqrt(np.mean((x - y)**2))

V_true = policy_evaluation(pi, P)
V_true[-1] -= 1
rmse(V, V_true)
수렴 과정
import matplotlib.pyplot as plt


def plot_value_track(V_track, V_true, env):
    colors = plt.cm.viridis(np.linspace(0, 1, env.length - 2))

    for i in range(env.length - 2):
        j = i + 1
        plt.plot(V_track[j], color=colors[i])  # 추정가치
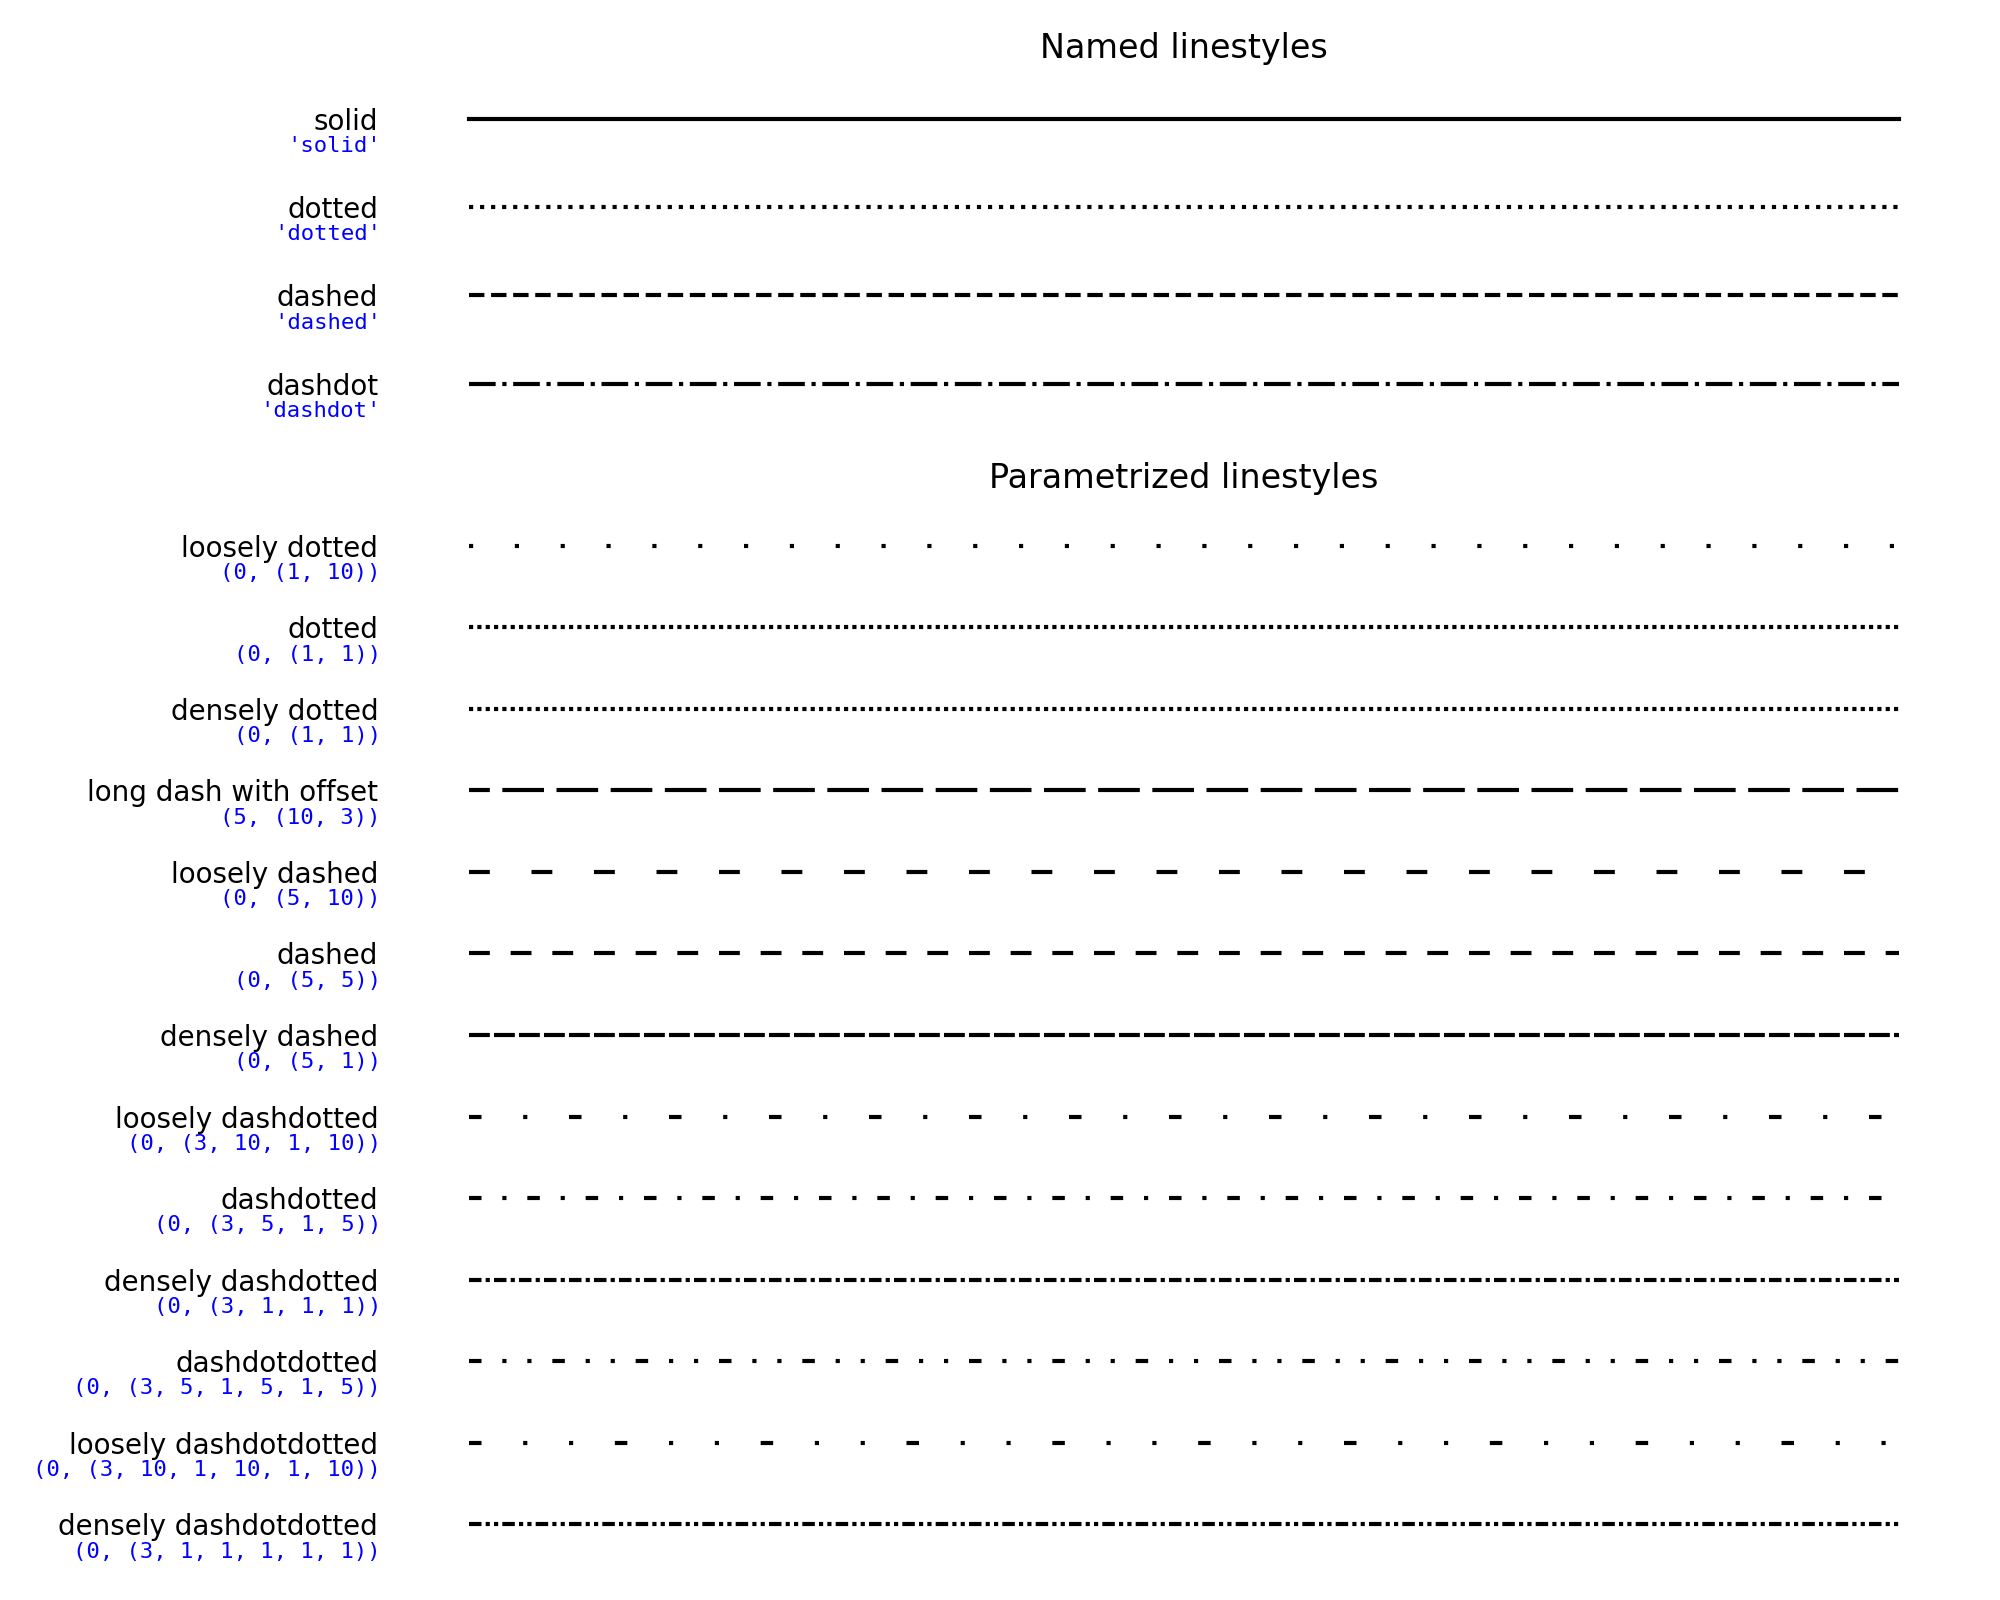
        plt.hlines(V_true[j], 0, 1000, colors=colors[i], linestyles='dashed')  # 실제가치
        plt.text(0, V_true[j], f'{i}')


plot_value_track(V_track, V_true, env)
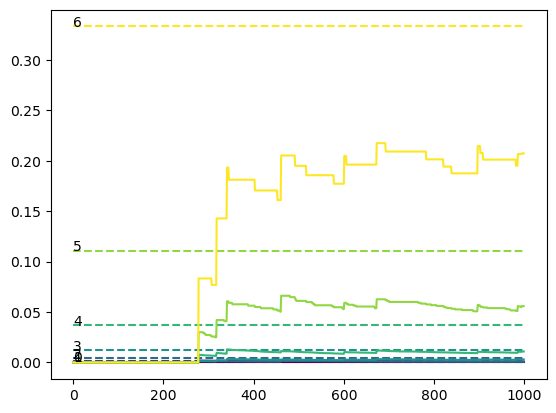
linspace
- 지정된 범위 내에서 균일하게 분포된 숫자들을 생성
np.linspace(start, stop, num)start: 생성할 숫자들의 시작 값.stop: 생성할 숫자들의 끝 값.num: 생성할 숫자의 개수.
np.linspace(0, 1, env.length - 2)는 0과 1 사이를 균일하게 나눈env.length - 2개의 숫자를 생성- 예)
env.length = 9면 0에서 1까지 균일하게 나눈 8개 숫자 생성
- 예)
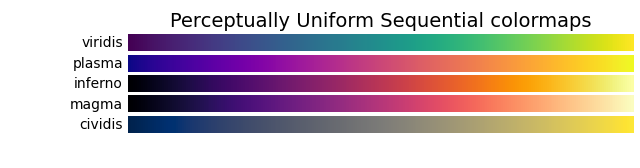
Viridis 컬러맵
- 지각적으로 균일한 컬러맵(Perceptually Uniform Color Maps) 중에 하나
- 데이터의 특정 범위가 시각적으로 강조되거나 왜곡되지 않도록 인간의 시각 시스템이 색상의 변화를 균일하게 인식할 수 있도록 설계
- 어두운 파란색에서 밝은 노란색까지 색상을 포함
- 색맹을 포함한 다양한 시각적 장애를 가진 사람들도 보기 쉬움
- 색상이 밝기와 잘 대응하므로, 흑백으로 인쇄해도 잘 보임
- 그 외 비슷한 컬러맵으로 plasma, inferno, magma, cividis 등이 있음
선 스타일
모든 방문 몬테카를로 every-visit MC
- 첫 방문 몬테카를로는 상태 s를 독립적으로 샘플링하기 때문에, 여러 번 샘플링할 경우 V(s)가 실제 값에 수렴
- 만약 한 궤적에서 상태 s에 다시 방문하더라도 가치 계산에는 반영 X → 이름이 "첫 방문"인 이유
- 첫 방문 몬테카를로가 더 오래되고(1940년대), 더 표준적
- "모든 방문" 몬테카를로는 다시 방문한 경우도 가치 계산에 반영
- 모든 방문 몬테카를로도 실제 값에 수렴한다는 것이 1996년에 증명
몬테카를로 법의 장단점
- 편향되지 않은 추정치를 주는 것은 큰 장점
- 상태 가치 함수를 갱신하기 위해 실제 수익 G를 얻을 때까지 기다려야 함
- 에피소드가 끝나지 않거나 매우 긴 경우 사용이 어려움
- t부터 T까지 여러 타임 스텝의 모든 보상을 더하므로 G의 분산이 큼
- 편향이 작아도 분산이 크면 샘플링의 효율성이 떨어짐
- 편향이 크더라도 분산을 줄일 수 있으면 샘플링의 효율성을 높일 수 있음
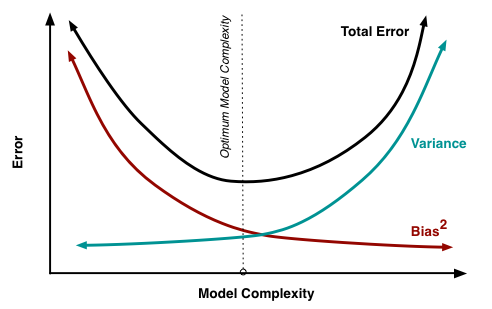
편향-분산 교환 bias-variance trade-off
- 머신러닝에서 편향과 분산 사이의 교환 관계
- 단순한 모델은 모델의 구조에 따라 나올 수 있는 결론이 제한(높은 편향)되지만 데이터에 따라 결론이 달라지지 않음(낮은 분산)
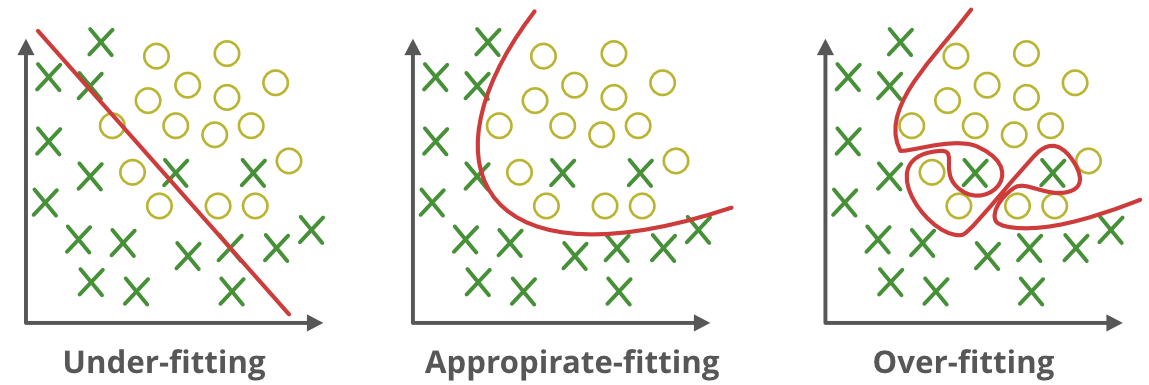
- 데이터에서 충분히 반영하지 못하는 과소적합(underfitting)의 위험
- 복잡한 모델은 데이터에 따라 결론이 달라지고(높은 분산), 다양한 결론이 나올 수 있음(낮은 편향)
- 데이터의 작은 노이즈에도 결론이 달라지는 과대적합(overfitting)의 위험
과적합
- 과대적합 overfitting: 모델이 실제 패턴보다 복잡
- 과소적합 underfitting: 모델이 실제 패턴보다 단순
퀴즈
예측 문제의 설명으로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.