
시간차 학습
시간차 학습 Temporal-Difference Learning
- MC의 공식
- 여기서 G는 상태 가치 함수를 이용해서 추정치를 얻을 수 있음: TD 목표(target)
- 공식을 다음과 같이 수정
- TD오차: TD목표와 V(St)의 차이
시간차 학습
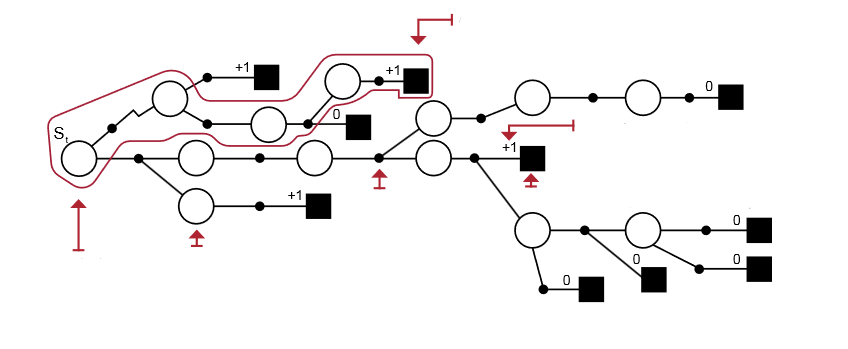
- 현재 추정하고자 하는 가치 함수의 상태
- 원은 비종료 상태
- 마지막에 +1을 보상으로 받고 에피소드가 종료
- 보상
- 사각형은 종료 상태
- 점은 행동
- 한 스텝만 행동하면 바로 가치 함수를 수정할 수 있음
시간차 학습의 장단점
- MC와 달리 에피소드 끝까지 기다릴 필요가 없음 -> 매 step마다 학습 가능
- 무한히 계속되거나 에피소드가 매우 긴 환경에서도 사용할 수 있음
- MC보다 V의 초기 추정치에 더 민감(큰 편향)
시간차 학습의 심리-생물학적 의미
- 시간차 학습은 행동주의 심리학의 일환인 강화 학습 이론에 기초
- 행동이 긍정적인 결과(보상)를 초래하면 그 행동이 강화
- 부정적인 결과(벌)를 초래하면 그 행동이 약화
- 에드워드 톨먼(Edward Tolman)의 목표 지향 행동(goal-directed behavior) 이론: 동물은 보상을 예측하고, 그 예측에 따라 행동을 조정
- TD 오차는 기대한 보상과 실제로 받은 보상 간의 차이
- 도파민 뉴런의 반응이 TD 오차에 기반
도파민 뉴런
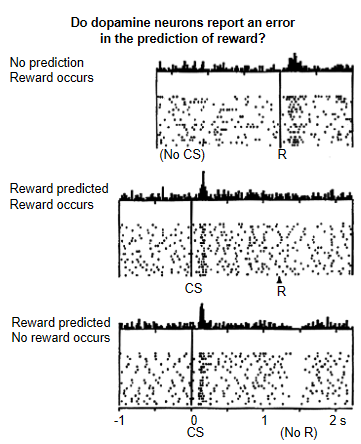
- 과일 주스 한 방울
- 학습 전
- 예상치 못한 보상에 활성화
- 학습 후
- 예상한 보상에는 활성화X
- 조건 자극에 활성화
- 예상한 시점에 예상한 보상이 없으면 활동 저하
시간차 학습
from collections import defaultdict


class TDPrediction(MCPrediction):
    def __init__(self, env, gamma=0.9, alpha=0.1):
        super().__init__(env, gamma)
        self.alpha = alpha

    def update_value(self, episode):
        for t in range(len(episode)):
            state, action, reward, next_state, done = episode[t]
            td_target = reward + self.gamma * self.V[next_state] * (not done)
            self.V[state] += self.alpha * (td_target - self.V[state])
n-step TD
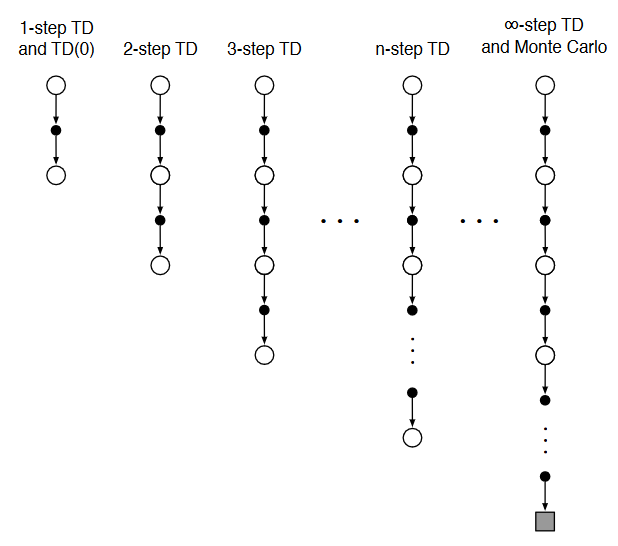
- n 단계만큼 따라가서 반영하는 시간차 학습
- n이 커지면 MC와 비슷해짐(편향 작고, 분산 큼)
- n=∞: 몬테카를로
- n이 작아지면 편향이 커지고 분산이 작아짐
- 적절한 n을 선택할 필요가 있음
n-step TD
class NStepTDPrediction(TDPrediction):
    def __init__(self, env, gamma=0.9, alpha=0.1, n=3):
        super().__init__(env, gamma, alpha)
        self.n = n

    def update_value(self, episode):
        T = len(episode)
        for t in range(T):
            G = 0
            for k in range(t, min(t + self.n, T)):
                state_k, action_k, reward_k, next_state_k, done_k = episode[k]
                G += (self.gamma ** (k - t)) * reward_k
                next_state_kp1 = episode[k + 1][0] if k + 1 < T else None

            if t + self.n < T:
                G += (self.gamma ** self.n) * self.V[next_state_kp1]
            state_t, action_t, reward_t, next_state_t, done_t = episode[t]
            self.V[state_t] += self.alpha * (G - self.V[state_t])
n-step TD의 문제
- n=∞면(MC) 에피소드가 끝났을 때 모든 상태의 가치를 수정할 수 있으나 분산이 크고, 끝날 때까지 기다려야 함
- n=1이면 보상 피드백이 직전 상태의 가치를 수정할 때만 직접적으로 쓰이기 때문에 정보가 느리게 퍼짐
- 여기서 수정된 직전 상태의 가치가 전전 상태의 가치를 수정할 때 사용되고, 전전 상태의 가치는 전전전 상태의 가치를 수정할 때 사용되고...
- n을 키워도 n 스텝만큼은 가치의 수정이 지연됨
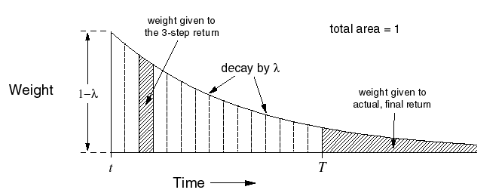
람다(λ)-수익
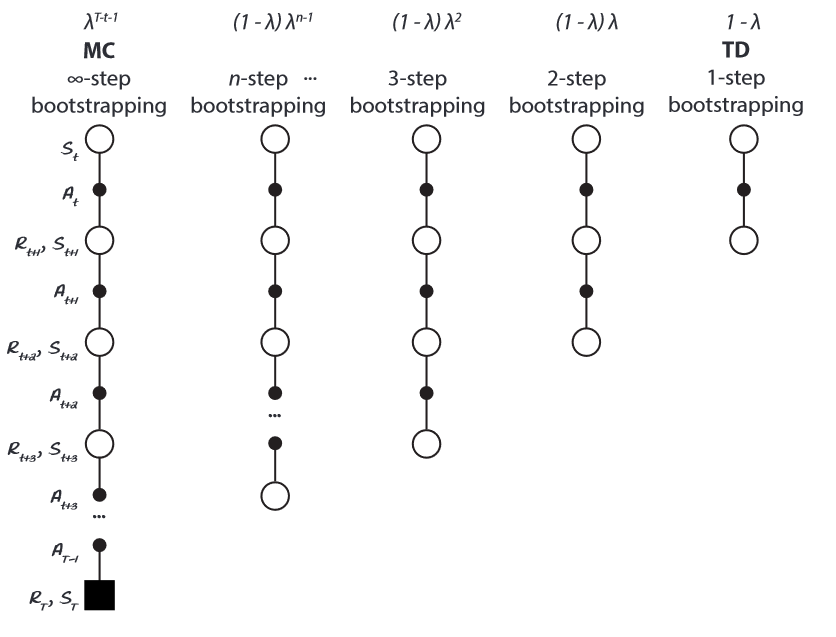
- 람다 수익: 여러 단계의 수익을 가중 평균한 것
- 아이디어: 방금 방문한 상태일수록 현재 TD 오차에 더 큰 책임이 있고, 오래전에 방문한 상태일수록 책임이 (λ의 비율로) 점점 줄어든다.
- 현재 실수의 책임을 과거 상태들에게도 분배하는 방법
람다-수익
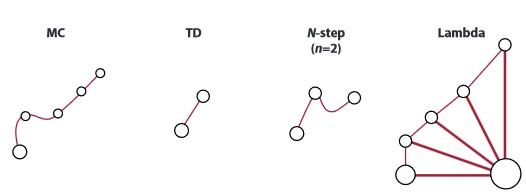
MC, TD, n-step, 람다 수익 비교
- MC: 시작에서 끝까지
- TD: 한 단계
- n-step: 여러 단계
- 람다 수익: 시작에서 끝까지 가중 평균하여 가까운 결과를 더 많이 반영
Forward-View TD(λ)
- 시작에서 끝까지 모든 수익을 가중 평균하여 일괄 반영
- 단, MC와 마찬가지로 에피소드가 끝날 때까지 기다려야 함
- 실제로는 잘 사용하지 않음
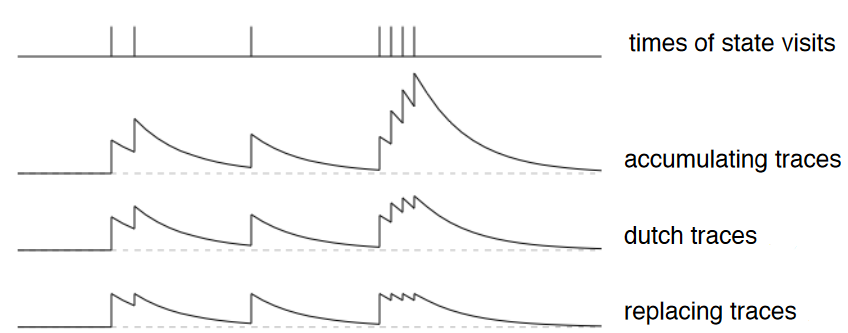
적격 흔적 eligibility trace
- 적격 흔적: 지나온 상태를 기록해둔 것
- 처음에는 모든 상태를 0으로 설정: E0=0
- 어떤 상태에 방문하면 값을 증가
- 누적 흔적(accumulating trace): E(S)←E(S)+1
- 상태에 방문할 때마다 증가 -> 빈도(frequency)를 반영
- 더치 흔적(dutch trace): E(S)←(1−α)E(S)+1
- 누적 흔적보다 느리게 증가
- 대체 흔적(replacing trace): E(S)←1
- 상태에 방문할 때마다 증가하지만, 최댓값을 1로 제한
- 최근에는 잘 사용하지 않음
- 모든 흔적은 스텝마다 감쇠: Et+1=Etγλ
- γ: 최신성(recency)을 반영
- λ: 람다 수익을 반영
Backward-view TD(λ)
- 각 스텝마다 1-step TD 오차를 계산
- TD 오차가 발생할 때마다, "적격 흔적"을 이용해서 지금까지 지나온 상태들(Et>0)에 람다 수익을 반영하도록 즉시 수정
- 일반적으로 TD(λ)라고 하면 Backward-view를 말함
TD(λ)
class TDLambdaPrediction(TDPrediction):
    def __init__(self, env, gamma=0.9, alpha=0.1, lambd=0.9):
        super().__init__(env, gamma, alpha)
        self.lambd = lambd

    def update_value(self, episode):
        T = len(episode)
        for t in range(T):
            state, action, reward, next_state, done = episode[t]
            td_error = reward + (self.gamma * self.V[next_state] * (not done)) - self.V[state]
            E = np.zeros_like(self.V)  # eligibility traces
            E[state] += 1
            for k in range(t, T):
                state_k, _, reward_k, next_state_k, done_k = episode[k]
                self.V[state_k] += self.alpha * td_error * E[state_k]
                E[state_k] = self.gamma * self.lambd * E[state_k] if k < T - 1 else 0
TD와 MC
- TD(0)은 1-step TD와 동일
- Forward View: 람다 수익에 1-step만 포함
- Backward View: 1-step이 지나면 적격 흔적에서 ×0이 되어 사라짐
- TD(1)은 MC와 동일
- Forward View: 람다 수익은 Gt:T과 같음
- Backward View: 책임이 할인율과 똑같이 감쇠
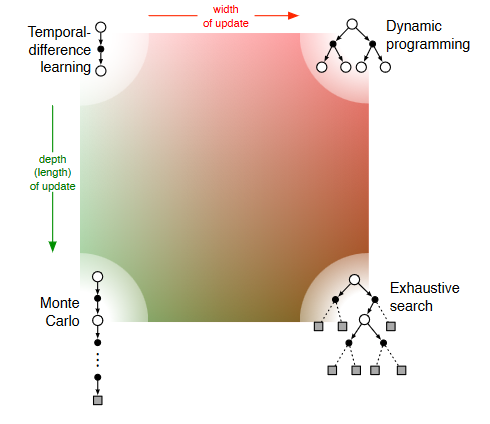
동적 계획법, 몬테카를로, 시간차 학습의 관계
- 시간차 학습: 한 가지 행동을 검토
- 동적 계획법: 모든 행동을 한 단계 검토
- 완전 검색: 모든 경우를 끝까지 검토(현실적으로 불가능)
- 몬테카를로: 한 가지 경우를 끝까지 검토
퀴즈
시간차 학습(TD)이 MC와 달리 매 step마다 학습할 수 있는 이유로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.